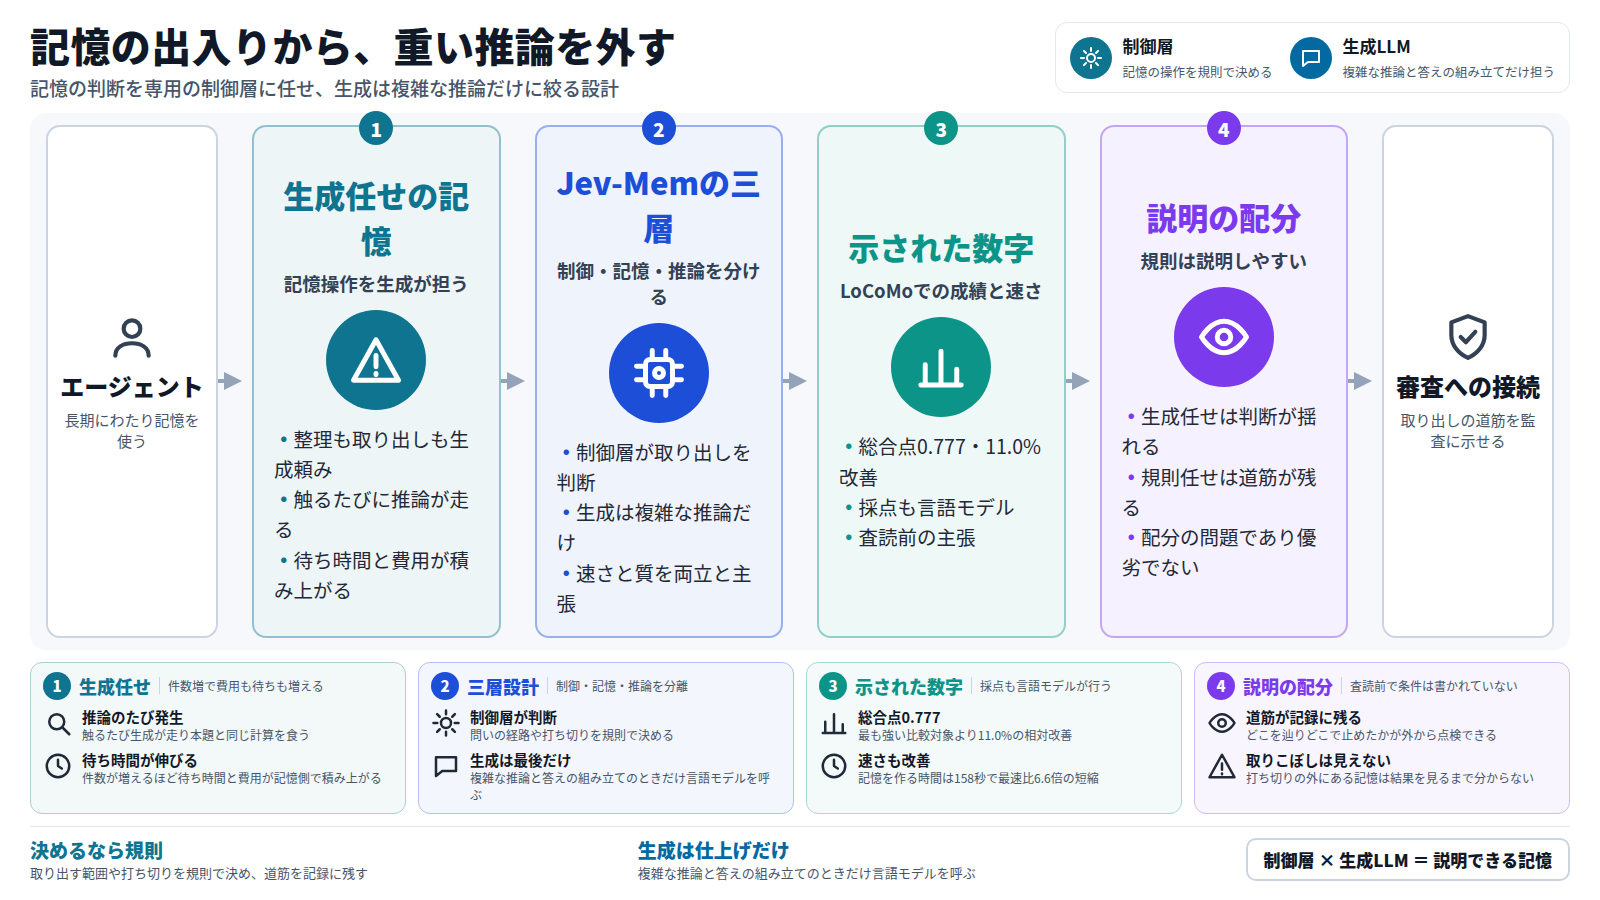
記憶の出入りのたびに、推論が走っている
長い時間を跨いで働くエージェントには、記憶の仕組みが要る。何を覚え、何と結びつけ、問われたときに何を取り出すか。ここまでは異論の少ないところである。問題はその仕組みの動かしかたにある。いま多くの実装は、記憶の整理も、取り出す先の選びかたも、取り出す量の決めかたも、すべて言語モデルの生成に任せている。
結果として、記憶を触るたびに推論が走る。記憶は本題を解くための下働きであるはずが、その下働きが本題と同じ計算を食う。件数が増えるほど、待ち時間と費用は記憶の側で積み上がる。この論文は、そこに別の制御層を置く[1]。本稿の一次情報は査読を経ていない arXiv のプレプリントである。
速い判断と遅い判断を、記憶の側で分ける
著者らが提案する芯は一つである。記憶の操作を決めるのは、生成する言語モデルではなく、軽い専用の制御層にする。人の認知を速い側と遅い側に分ける見かたを借り、速い側を担う制御の面、多重の関係を持つ記憶の面、遅い側の推論の面という三つに分ける。著者らはこの仕組みを Jev-Mem と呼んでいる。
速い側の制御層が受け持つのは、記憶を作るときの種類づけと関係の組み立て、そして取り出すときの一連の判断である。問いをどこへ回すか、取り出しにどれだけの枠を割くか、関係の網をどこまで辿るか、候補にどう点を付けるか、どこで打ち切るか。これらを生成に頼らず決める。
遅い側の推論、つまり生成する言語モデルが呼ばれるのは、込み入った推論と答えの組み立てのときだけである。言い換えれば、記憶の出入りという通り道から、重い計算を外へ出す設計である。記憶の良さと仕組みの速さは普通は取り替えの関係に置かれるが、著者らはその両方が同時に良くなると主張している。
abstract が述べている範囲
abstract に書かれているのは次の範囲である。長期の対話を扱う評点表 LoCoMo の上で、言語モデルによる採点の総合点が 0.777 に達し、最も強い比較対象に対して 11.0% の相対的な改善だったという。記憶を作る時間は 158 秒に下がり、最も速い比較対象に対して 6.6 倍の短縮だったとしている。問いに答えるまでの平均の待ち時間は 0.93 秒で、36.7% の削減だと述べている[1]。
ここで気をつけたいのは、採点している側も言語モデルであるという点である。点数が上がったという記述は、別の言語モデルがそう判定したという記述であって、人が読んで正しかったという記述ではない。速さの数字は測れば決まるが、良さの数字は採点者の性質に依存する。abstract の範囲では、採点の条件は示されていない。ここまでが著者らの主張であり、確立した結論ではない。
現場に置き換えると、どう見えるか
記憶の制御を生成から外すという設計は、運用の側では次の違いになる。
生成に記憶を任せる
何を取り出すかを、そのつど言語モデルが文章で考える。柔らかく振る舞えるが、同じ問いでも判断が揺れる。待ち時間と費用は問い合わせの数に比例して伸び、どこで枠を使い切ったのかを後から説明しにくい。
専用の制御層に任せる
取り出す範囲や打ち切りの条件を、決まった規則で判断する。振る舞いは硬くなるが、同じ問いには同じ道筋を通る。どこを辿ってどこで止めたかが記録に残り、外から点検できる。
要点は速さではなく、判断の揺れを許す場所を絞ることにある。生成に任せた部分は説明しにくく、規則に任せた部分は説明しやすい。どちらが良いかではなく、どこまでを説明可能なまま残すかという配分の問題である。
新しくない部分と、読み取れない部分
記憶を階層に分け、安い判断と高い判断を切り分ける考え方そのものは新しくない。言語モデルに記憶の階層を持たせる試みは以前から積み上げられてきた[5]。速い処理と遅い処理に分けるという見かたも、認知の分野から借りてきた古い枠である。この論文が持ち込んでいるのは、その切り分けを記憶の制御そのものに当てはめ、生成を通り道から外した点である。
読み取れないことも多い。制御層をどう作ったのか、何で学習させたのか、規則を決めるのに使った集合はどれか。取り出しを打ち切る条件が外れたとき、つまり必要な記憶を取りに行かなかったときに何が起きるのか。いずれも abstract の範囲では条件が示されていない。速さの改善が、扱う記憶の量が増えたときにも保たれるのかも書かれていない。査読前のプレプリントであるから、判断は本文と査読の後に置くべきである。
票と実装は立ったが、報道はない
この論文には公開後 27 件の upvote と 2 件のコメントが付き、実装の星は 100 に達している[2][3]。読者の票と、手を動かした人の票が、どちらも立っている状態である。加えて、同じ時期に、エージェントの記憶を仕事に合わせて必要な分だけ選び出すという別の論文が並んでいる[4]。束のサイズは 2 である。
報道の言及は、収集の範囲では確認できていない。研究の外へ出た形跡はまだない、ということである。ここで繰り返しておく。票も星も話題性の指標であって、正しさや重要さの指標ではない。星が付いたのは、動かしてみたい人がそれだけいたということであって、動かして期待どおりだったという記録ではない。記憶の仕組みは、評点表の上では差が出やすく、実運用では差が縮みやすい種類の部品でもある。
資材審査の工程に、どこが接続するか
販売情報提供活動の資材を点検する仕組みに記憶を持たせるなら、覚えるべきものは決まっている。添付文書の版と改訂の経緯、過去に指摘した内容とその根拠、通した表現と通さなかった表現の境目、審査の場で積み上がった解釈。これらは長い時間を跨いで積み上がり、しかも古い記述が現在の判断に効いてくる。
この論文の設計で規制の現場に接続するのは、速さではなく取り出しの道筋が記録に残るという性質である。どの記憶を見て、どこまで辿り、なぜそこで止めたのか。これが規則として書き下されていれば、監査で説明できる。生成に任せた場合、同じ問いに同じ答えが返る保証がないまま、説明は事後の再現に頼ることになる。
逆に、規則で打ち切る設計は、取りに行かなかった記憶を必ず持つ。効いてくるはずの過去の指摘を辿らずに済ませたとき、その取りこぼしは結果を見るまで分からない。速さの改善は測れるが、取りこぼしの費用は事後にしか測れない。だから工程に入れる順序は決まっている。どの記憶は必ず参照させるのかを先に列挙し、その外側にだけ打ち切りの規則を置く。速いから採るのではなく、説明できる範囲を決めてから速さを取る。