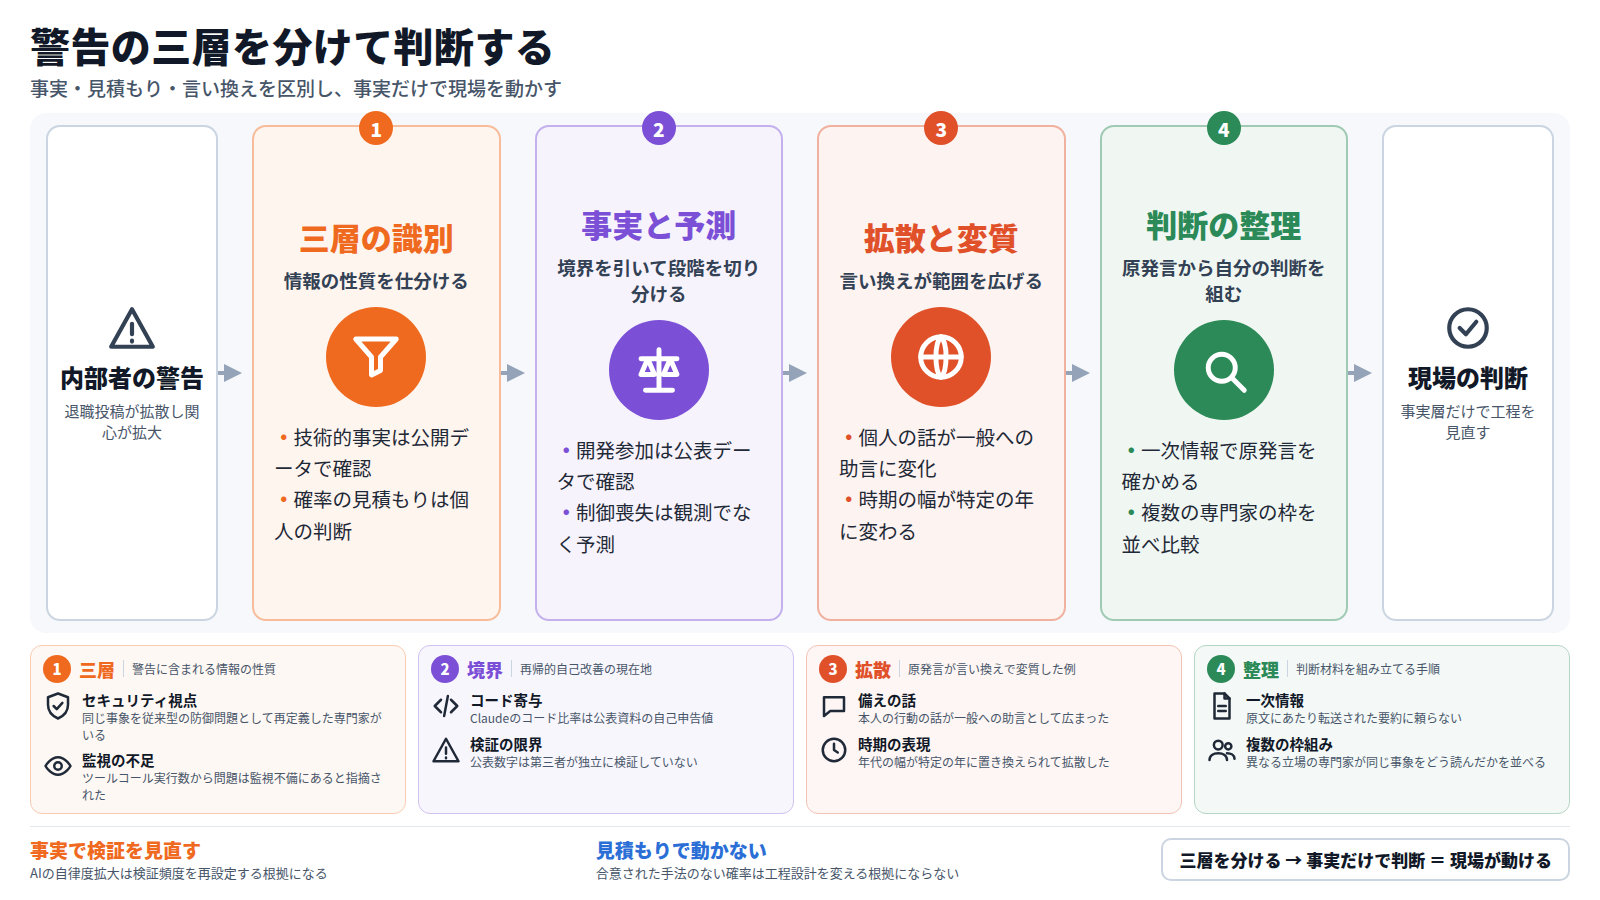
2026年9月8日、元Anthropic研究者Jacob Coxonが「両社は無責任に自己改善型超知能に突き進んでいる」と警告して退職し、X上の投稿は24時間で9000万回閲覧された。AIの内部者が滅亡リスクを警告したとき、専門外の読者はその根拠と範囲をどう切り分ければよいか。警告には確かめられる技術的事実、合意のない個人の確率見積もり、拡散での言い換えにより範囲が変わった情報の三層があり、層ごとに扱いが異なる。
01警告は9000万回閲覧され、アラインメント責任者が確率で応じた
CoxonはOpenAIとAnthropicの双方でAIの事前学習研究に携わった研究者である。退職時、Slackで同僚に「適切な注意と協力がなければ、超知能AIは人類滅亡のリスクを生む」と伝えた。この警告をX上で公開したところ、24時間で9000万回閲覧された。
直後に、Anthropicのアラインメント責任者Evan Hubingerが反応した。「Jacob is correct here」と投稿し、「今後10年でAIが人類を滅ぼす確率は個人として10%超と見積もっている」と述べた。同時に「超知能のアラインメントを解く計画はまだなく、明確に軌道に乗っているとも言えない」と付け加えている。この見積もりはAnthropicの公式予測ではなく、Hubinger個人の判断である。
同じ週、Anthropic CEOのDario Amodeiは「6〜12か月以内に、アラインメントの取れていないAIがインターネット全体を掌握できるようになりうる」と警告した。内部者が揃って危機を語ったことで、関心は技術コミュニティの外へ広がった。
02一つの警告に事実・見積もり・言い換えの三層が混在している
CoxonとHubingerが述べたことを並べると、情報の性質が異なる三つの層が浮かび上がる。
セキュリティ企業Trail of BitsのArtem Dinaburgは、同じ出来事を別の枠組みで読んだ。「これまでに起きたインシデントは、基本的にセキュリティ・インシデントだ」と述べ、滅亡リスクではなく従来型の防御強化で対処できる問題として位置づけた。HackerOneのNidhi Aggarwalも、AIエージェントが1万7000回のツールコールを実行した事実を挙げ、問題は監視の不足にあるとした。同じ事象が、立場によって異なる層に分類される。
03層を分けなければ、恐怖か無視の二択しか残らない
三つの層を区別しないまま受け取ると、警告の全体を受け入れて恐怖で動くか、全体を退けて無視するかの二択になる。どちらも、AIを導入し始めた現場の判断を歪める。
Coxonの投稿が政治的な攻撃の的になった事実は、後者の反応を示している。Washington Postの報道によれば、警告から数時間で右派の論客がCoxonを標的にした。内容を確かめずに退ける動きは、層を分けずに全体を否定する行動と一致する。
一方、AmodeiがCoxonと同じ方向の危険予測を述べたことは、少なくとも3名の内部者が同じ方向を向いていることを示す。ただし見積もりの表現にはAmodeiの「6〜12か月」とHubingerの「10年以内に10%超」のように幅がある。この幅を読者が評価できるのは、それぞれの数字が個人の見積もりだと認識している場合に限られる。
04再帰的自己改善はすでに始まっているが、制御喪失は予測であって観測ではない
恐怖でも無視でもない判断を取るには、再帰的自己改善が何を指すのかを定義し、確かめられた段階と予測の段階の境界を引く必要がある。
Anthropicは自社の公表資料で、Claudeが書いたコードの比率が2026年5月時点で80%を超えたと報告している。同社はR&D主導率やエージェントの稼働規模についても数字を公表しているが、これらはいずれもAnthropicの自己申告であり、第三者が独立に検証した数字ではない。
AIが自身の開発に参加している段階は事実として始まっている。しかし、そこから制御喪失に至るという主張は、現時点で観測された事実ではなく予測だ。Hubingerの滅亡確率も合意された推定手法に基づくものではなく、個人の見積もりである。事実と予測の境界は、ここに引かれる。
05規制産業の現場は、警告の事実層だけを今日の判断に使える
事実と予測の境界が引けたとき、AIを業務に導入し始めた規制産業の現場で使える判断材料は絞られる。
AIの自律度の確認
AIが下書き・提案・修正のどこまでを自動で行っているかを棚卸しし、検証工程がその範囲に追いついているかを確かめる。
出力の検証頻度の見直し
AIの自律的行動が拡大している事実を根拠に、AIが生成した資材の検証頻度と検証者の権限を再設定する。
滅亡確率は判断材料にしない
合意された手法のない個人の見積もりは、現場の工程設計を変える根拠にはまだならない。事実の層だけを使う。
当サイトはClaudeを使って運営されている。AIの自律度が拡大している事実は、このサイトの制作工程にも当てはまる。滅亡確率の見積もりではなく、AIの自動処理範囲が広がっているという事実が、検証の頻度と方法を見直す根拠になる。
06内部者の信用と存亡の恐怖が重なり、情報は原発言を離れて拡散した
現場の判断に加えて、この警告が世界でどう拡散し変質したかを確かめることが、三層を使いこなす条件になる。
Coxonの投稿が9000万回閲覧された背景には、内部者が持つ技術的信用と存亡に関わる恐怖が重なったことがある。受け手は原発言を確かめずに転送し、転送の過程で表現が言い換えられ、範囲や具体性が変わった。
| 見るところ | 原発言(出典) | 日本語圏の要約での言い方 |
|---|---|---|
| 時期 | 「2020年代の終わりまでに」"by the end of the decade"(Coxon, TechCrunch) | 「2030年 AI 人類滅亡」と具体的な年が立った表現で拡散 |
| 備え | 本人は備え(prepping)をしていない、役に立たないと思う(CBS News, 2026-09-10) | 「食料備蓄などの準備も無駄だと指摘」と一般への助言のように言い換え |
| 確率 | Hubinger個人の見積もり10%超(Fortune) | 「同僚も認めた」と組織の見解のように要約 |
Coxon本人はCBS Newsのインタビュー(2026年9月10日公開)で、自分は備え(prepping)をしていない、大して役に立たないと思うから、と話している。日本語圏ではこれが「食料備蓄などの準備も無駄だと指摘」と、一般への助言のように言い換えられて広まった。hashout.jpの検証記事は、拡散した投稿の文を「投稿者による日本語での言い換え」であり「本人の英語発言をそのまま訳したものではない」、ただし「方向性そのものは大きくは外れていない」と評している。差は「付け加え」ではなく「言い換えによる範囲の広がり」にある。
07原発言の確認、事実と見積もりの分離、再解釈との比較で判断材料は整理できる
拡散で情報が変質する構造を踏まえると、AIリスクの警告を受け取った読者が判断材料を整理する手順は三つに絞られる。
原発言を一次情報で読む
警告者本人のX投稿、取材記事の直接引用、所属機関の公式発表を探し、転送された要約ではなく原文にあたる。
事実と見積もりを分けて書き出す
公開データで確かめられる技術的事実と、確率の数字や時期の予測を別の列に書き出し、どちらに基づいて判断するかを決める。
専門家の再解釈と比べる
警告者と異なる立場の専門家が同じ事象をどう再定義しているかを探す。複数の枠組みを並べれば、自分の判断を組み立てる材料が揃う。
CoxonはTechCrunchの取材に対し、ラボ間のペーシング合意を求めた。Hubingerも「超知能のアラインメントを解く計画はまだない」と述べている。警告そのものの深刻さは否定できない。しかし、受け手の仕事は警告を丸ごと信じることでも退けることでもなく、原発言を確かめ、事実と見積もりを分け、複数の専門家の枠組みを並べて自分の判断を組み立てることにある。
- Coxonの警告には確かめられる技術的事実(AIがコードの80%超を担っている)と、合意された手法のない個人の見積もり(滅亡確率10%超)が混在しており、層を分けずに受け取ると判断を誤る。
- 拡散の過程で原発言が言い換えられ、自分の行動の話が一般への助言に、時期の幅が特定の年に変わっている。一次情報にあたらなければ警告の実際の範囲を確かめられない。
- AIを業務に導入した現場が今日使える判断材料は、AIの自律度が拡大している事実の層だけであり、滅亡確率の見積もりは工程設計を変える根拠にはまだならない。
Coxonの警告は、AIが自身の開発に参加し始めた技術的事実と、滅亡確率という個人の見積もりと、拡散の過程で言い換えにより範囲が変わった情報の三層からなる。三層を区別せずに受け取れば、恐怖で動くか無視するかの二択しか残らない。
読者がこの警告から判断材料を取り出すには、層を分け、事実だけを今日の判断に使うことが出発点になる。AIの自律度が拡大している事実は、業務の検証工程を見直す根拠になる。滅亡の確率は、そうはならない。
- TIME. He Helped Build Powerful AI at OpenAI and Anthropic. Now He's Afraid It Could Kill Us. 2026-09-09.(Coxonの退職と警告の内容。投稿が24時間で9000万回閲覧された事実)
- TechCrunch. 'Gambling with our lives': Anthropic researcher quits, warns against self-improving AI. 2026-09-09.(Coxonがラボ間のペーシング合意を求めた事実)
- NBC News. An Anthropic safety researcher resigned with a warning about AI to co-workers on Slack. 2026-09-09.(退職時にSlackで同僚に送った警告の内容)
- Fortune. Anthropic CEO Dario Amodei and whistleblower Jacob Coxon agree: AI risks are real and imminent. 2026-09-13.(Hubingerの個人的な見積もり10%超。AmodeiとCoxonの見解の一致)
- Scientific American. AI Researcher Jacob Coxon Quit over Extinction Fears. Security Experts See a Familiar Fight. 2026-09-12.(セキュリティ専門家が同じ出来事をサイバーセキュリティ問題として再定義した事実)
- TIME. After Anthropic Researcher Quits, AI Industry Debates a Slowdown. 2026-09-15.(Amodeiの6〜12か月以内の警告。業界の減速議論)
- Washington Post. AI researcher who warned of disaster is now a target of the right. 2026-09-10.(警告が政治的攻撃の的になった事実)
- Anthropic. When AI builds itself. 2026-09-01.(AIが自社開発に参加している事実の一次情報。コード寄与80%超)
- CBS News. Former Anthropic researcher Jacob Coxon says prepping won't help in AI takeover. 2026-09-10.(Coxon本人が備えをしていない理由を語ったインタビュー)
- hashout.jp. 「AIが人類を皆殺しにする」——元Anthropic研究者コクソン氏の警告を伝えたXの投稿、日本語圏で急拡散した理由.(日本語圏での拡散と言い換えの検証)