エージェントの強さは、モデルではなく「外枠」が決めている
エージェントを組むとき、中心にある言語モデルは凍結されたまま動かさないことが多い。実際に性能を左右するのは、その周りにあるもの ── プロンプト、制御の流れ、道具の組み方、記憶、文脈の管理である。著者らはこの周辺一式を harness(外枠)と呼び、エージェントの能力はこの外枠によって大きく増幅されると述べている。
外枠は人の手で作られてきた。近年はこれを自動化する研究が増えている。外枠の部品への変更案を機械が出し、機械が選び、それを繰り返す。著者らはこれを、エージェントという系のレベルで起きている再帰的自己改善(recursive self-improvement)の一形態だと位置づける。
本稿が扱うのは査読前のプレプリントである。以下の数字はすべて、著者らが要旨で述べている主張であり、第三者が再現した結果ではない。
提案 ── 進化に制約をかける
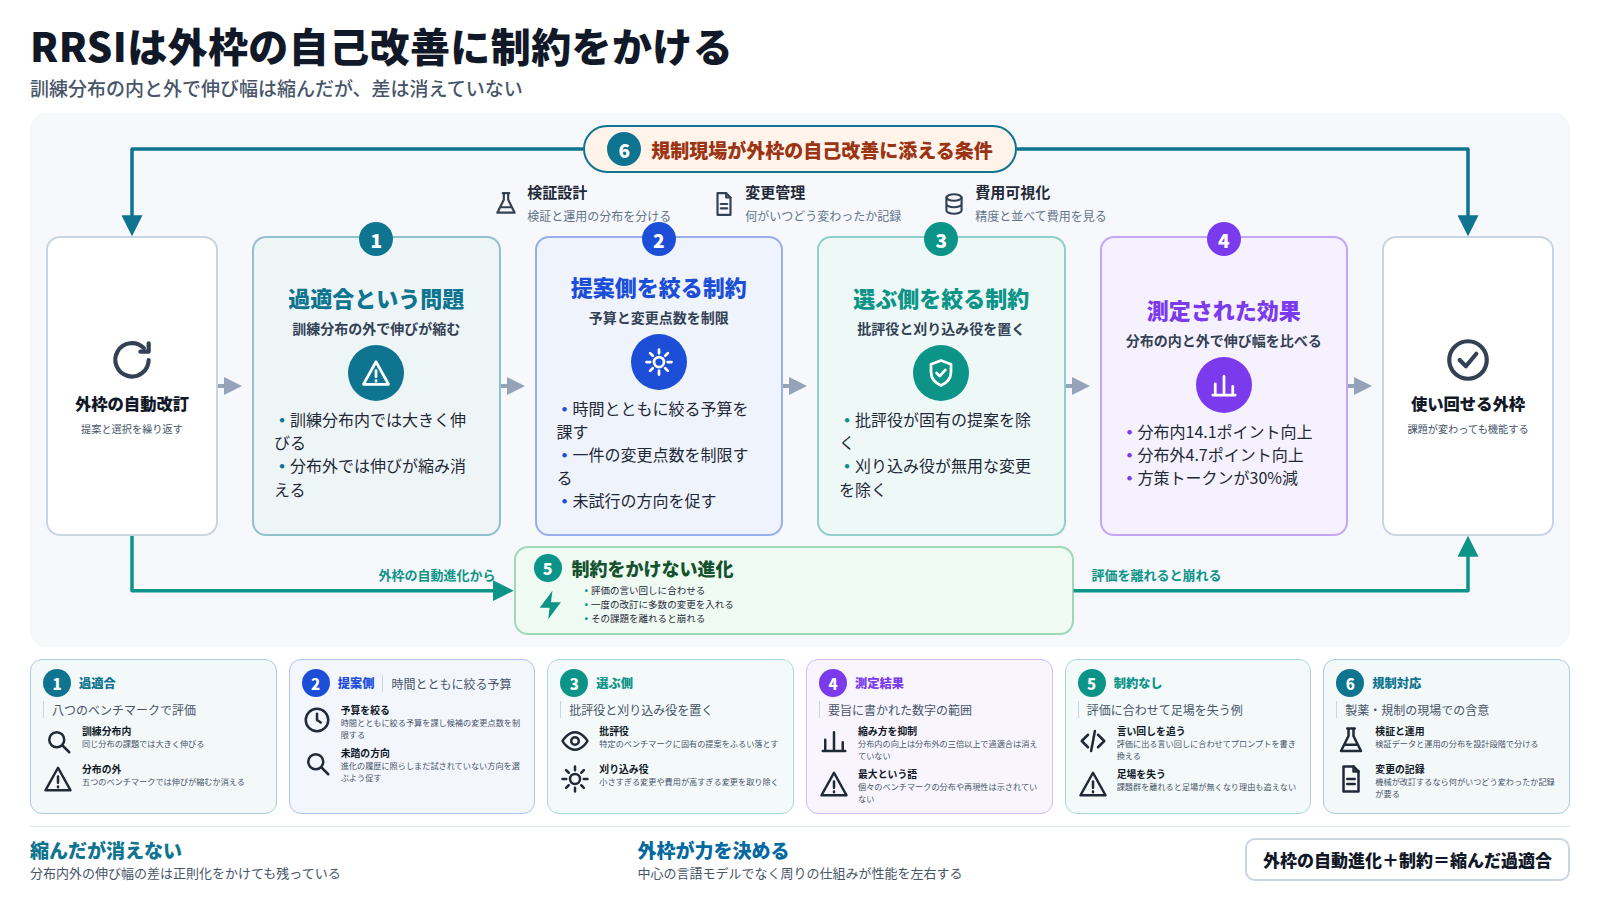
著者らが指摘する問題は一つに絞られる。外枠を繰り返し進化させると、訓練に使った課題を覚え込んでしまう。訓練と同じ分布の課題では大きく伸びるのに、分布の外にあるベンチマークでは伸びが縮み、場合によっては消える。
提案手法 RRSI(Regularized Recursive Self-Improvement)は、この過適合に対して正則化の考え方を持ち込む。変更案を出す側と選ぶ側の両方に制約をかける。
- 提案する側には、時間とともに絞られる予算を課す。一つの候補が束ねられる変更の数を制限し、進化の履歴に照らして、まだ試されていない方向を選ぶよう促す。
- 選ぶ側には批評役(critic)と刈り込み役(pruner)を置く。批評役は、特定のベンチマークに固有の提案をふるい落とす。刈り込み役は、小さすぎる変更、費用が高すぎる変更、もう役に立たなくなった変更を取り除く。
狙いは、ベンチマークに固有の仕掛けや単なる雑音ではなく、使い回しの効く機構が残るようにすることである。
何を示したか ── 要旨に書かれた範囲
評価はコーディング、エージェント的な作業環境、工学設計の課題にまたがる八つのベンチマークで行われた。著者らの報告は次のとおりである。
- 進化の対象にした分割では、最大 14.1 ポイントの向上。
- 分布の外にある五つのベンチマークでは、最大 4.7 ポイントの向上。
- 出来上がった外枠は、正則化をかけない進化に比べて 30% 少ない方策トークンで動く。
数字の並び方そのものが、著者らの主張を表している。訓練分布の内と外で伸び幅が大きく違う。内側の向上が外側の三倍以上ある。著者らが批判している「分布内で大きく伸び、分布外で縮む」現象は、制約をかけた後でも消えてはいない。縮み方を抑えた、という主張である。コードは公開されている[2]。
具体例で見る ── 何が残り、何が捨てられるか
外枠を自動で書き換える仕組みが、どんな変更を残しうるか。制約の有無で並べる。
制約をかけない進化
評価課題によく出る言い回しに合わせてプロンプトを書き換える、特定の入力形式を前提にした分岐を足す、一度の改訂で多数の変更をまとめて入れる。評価スコアは上がる。だが、その課題群を離れると足場が無くなり、なぜ上がったかも追えない。
制約をかけた進化
変更は少数ずつ入り、特定のベンチマークに寄った提案は批評役で落ちる。効き目の小さい変更や費用に見合わない変更は刈り込まれる。残るのは、課題が変わっても機能する仕組み ── 著者らが「使い回しの効く機構」と呼ぶものである。
製薬の実務に置き換えれば、社内の文書処理エージェントが、評価用に用意した書式でだけ高い成績を出す状態と、書式が変わっても同じように働く状態の違いにあたる。前者は、評価の場を離れた瞬間に成立しなくなる。
何が新しくないか、限界はどこか
自動で系を改善する枠組み自体は新しくない。過適合を抑えるために探索を制約する、という発想も、機械学習では長く使われてきた。新しいのは、その発想を外枠の自己改善という対象に当てはめ、提案側と選択側の両方に具体的な制約を置いた構成である。
限界は、要旨の数字にそのまま出ている。分布外での向上は分布内より小さい。つまり、過適合は抑えられたが解消されてはいない。「最大」という語も重要で、ベンチマークごとの分布は要旨には示されていない。平均がどうだったか、伸びなかった、あるいは下がったベンチマークがあったかは、この範囲では分からない。
さらに、分布外として用いた五つのベンチマークが、どの程度「外」なのかも要旨からは読み取れない。評価課題の作られ方が似ていれば、外に見えて外ではない。改善の反復に要した計算費用、結果の分散、乱数の種を変えたときの再現性も示されていない。自己改善の系は反復のたびに費用がかかるため、向上の幅を費用と並べて見なければ、実務上の判断はできない。
なぜ今、この主題が束になっているのか
同じ束には、AI の研究エージェント自体を再帰的に自己改善させる研究が入っている[4]。外枠を改善する話と、研究を行う主体を改善する話は、同じ再帰の構造を共有している。当サイトでもこの主題は続けて扱っており、外枠の自己改善は一本の論文の話ではなく、束として立ち上がっている。
反応の数字も並べておく。要旨の収集時点で upvote は 176、GitHub の star は 190、束の大きさは 2 である。三つの系統(票・実装・束)が同時に立っている点で、単発の話題とは形が違う。ただし upvote も star も、読まれたことと動かされたことを示す数字であって、主張の正しさを示す数字ではない。査読前である以上、外枠が本当に汎用的になったかどうかは、他者の再現を待つほかない。
製薬・規制の現場から見ると
第一に、評価用の課題に合わせて系が変形するという問題は、そのまま社内の検証設計に跳ね返る。検証用のデータセットを固定し、そこに向けて調整を繰り返せば、スコアは上がる。上がったスコアが実務での性能を表しているかは別問題であり、この論文はその乖離を正面から測っている。検証集合と運用の分布をどう分けるかは、設計段階で決めておく事柄である。
第二に、自動で書き換わる系の変更管理である。外枠が機械によって改訂されるなら、何がいつどう変わったかの記録が要る。規制対象の業務に使う仕組みでは、変更の承認と記録が要求される。提案・批評・刈り込みという段を踏む構成は、記録の単位を作りやすい形ではあるが、記録が残ることと、変更の妥当性が説明できることは別である。
第三に、費用の可視化である。方策トークンが減ったという報告は、性能以外の軸で外枠を評価している。実務で継続的に動かす仕組みでは、一件あたりの費用と所要時間が、精度と同じ重みで意思決定に入る。査読前の段階の手法をそのまま持ち込む話ではないが、「何を良い外枠とみなすか」を定義する側は、精度だけを軸にしないほうがよい。