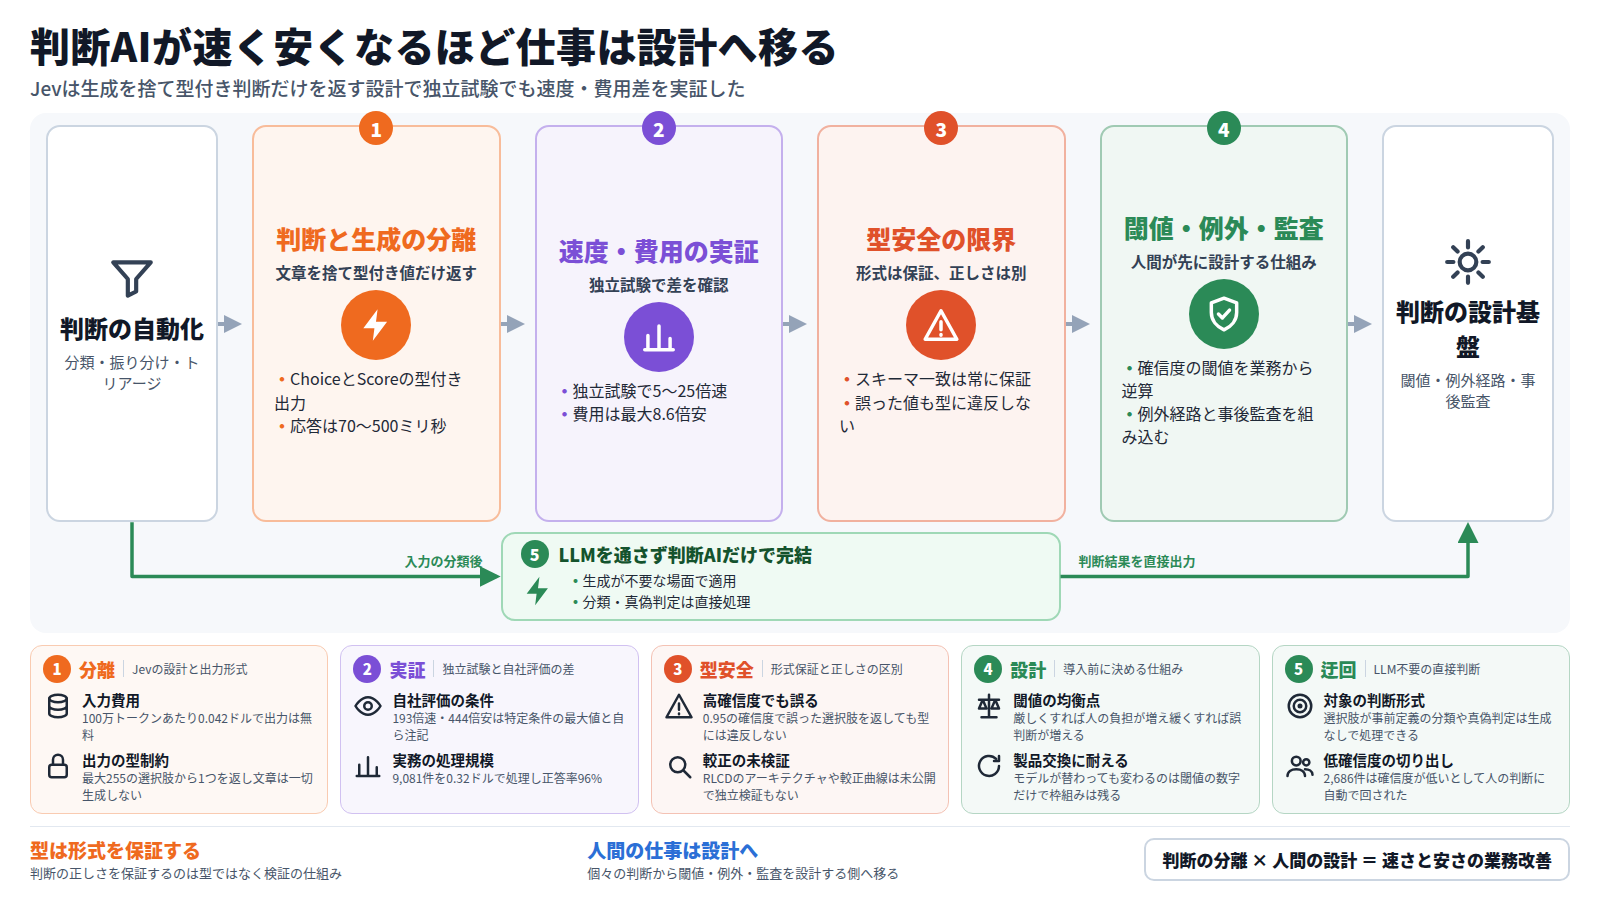
2026年9月15日、TypeSafe AI は文章を生成せず型付き判断だけを返す AI モデル Jev を公開した。判断だけを返す AI が LLM より桁違いに速く安くなるとき、人間の役割は判断そのものからどこへ移るか。個々の判断から、閾値の設定・例外の処理・結果の監査という設計側へ移る。
01Jev は文章生成を捨て、型付き判断だけを返す設計を選んだ
TypeSafe AI が「System One Model」と名付けた新しい分類の AI モデルがある。その最初の製品が Jev である。創業者の Diogo Almeida は、OpenAI で言語モデルを指示に従わせ人と対話できるようにする手法の開発に携わり、その研究が ChatGPT の基盤になったと自ら述べている。
Jev は文章もコードも一切生成しない。入力はプログラムの状態と非構造データであり、出力は型付き値に限定される。Choice は最大 255 の選択肢から 1 つを返す。Score は順位と確率分布を返す。はい/いいえの判断は選択肢が 2 つの Choice として扱える。いずれの出力にも較正済みの確信度が付く。応答時間は 70〜500 ミリ秒と公表されている。
入力の費用は 100 万トークンあたり 0.042 ドル、出力は無料とされている。チャットの代わりにはならず、文章の生成が必要な場面では使えない。この制約を設計の核に据えたことが、従来の LLM とは異なる位置づけを生んでいる。技術分析でも「Jev は汎用言語モデルではなく、制約付きの判断モデルに近い」と位置づけられている。
02判断と生成の分離は、AI ワークフローの配置を変える
文章を生成しない AI が判断だけを返せるなら、LLM を呼び出す工程の前後に判断の層を挟む配置が可能になる。前段では判断 AI が入力を分類し、定型の件を安価なモデルに、複雑な件だけを高性能モデルに振り分ける。後段では判断 AI が生成結果の適否を判定し、不適格な出力をやり直しや人の確認へ回す。
この配置が成り立てば、高性能モデルの呼び出しは複雑な件だけに限られ、費用と応答時間が下がる。さらに、生成が不要な場面では LLM を呼ばずに判断 AI の出力だけで処理を終えるルートも生まれる。
判断と生成を分離する設計は Jev に限った話ではない。判断の部分を他の分類器やルールエンジンに置き換えることもできる。要点は、判断と生成が同一のモデルに同居する必要がないという設計の選択肢が現れたことにある。
03独立試験でも 5〜25 倍速・最大 8.6 倍安、コスト構造は変わる水準にある
前節で示した配置が実務で意味を持つには、速度と費用の差が十分に大きい必要がある。TypeSafe 自身の Workflow Evals では 193 倍速・444 倍安という数字が出ている。ただしこれは同社が設計した特定のワークフローでの最大値であり、評価の作り手による偏りの可能性に同社自身が言及している。独立の試験結果は異なる。
| 評価の出所 | 速度 | 費用 | 正答率 |
|---|---|---|---|
| TypeSafe 自社評価 | 193 倍速(最大値) | 444 倍安(最大値) | 自社ワークフロー基準 |
| Near Here(英・50 件) | 約 5 倍速 | 8.6 倍安 | 96% |
| Good Start Labs(6,003 件) | ─ | 1.6 倍安 | Claude Fable 5.1 との一致率 91.5% |
| Every(早期利用) | 約 25 倍速 | ─ | 欠陥 7 件中 6 件検出(Fable 5.1 は 7 件) |
| paddo.dev(9,081 件) | 約 88 ミリ秒/件 | $0.32/9,081 件 | 96%(50 件抽出) |
独立 4 試験のいずれでも、LLM との速度差・費用差は認められる。5〜25 倍速・1.6〜8.6 倍安という範囲は、判断の工程を自動化する際の費用構造を変えうる差である。paddo.dev の試験では 9,081 件の商品マッチング判定を 13 分 22 秒で処理しており、1 件あたりの壁時計時間は約 88 ミリ秒だった。
ただし自社評価の 193 倍・444 倍との乖離は大きい。TypeSafe 自身が 193.6 倍・444.6 倍について「実際の効果の高い側にあると見込まれる(we expect that these are on the higher end of real world gains)」と書いている。また自社評価の採点は正解との一致ではなく、GPT-6 Astra と Fable 5.1 の平均である reference probabilities との一致で行われている。条件を確かめずに数字だけを引用することはできない。
04型安全は出力形式を保証するが、判断の正しさは保証しない
コストが変わる水準にあることを前節で確かめた。では、Jev が返す出力は何を保証し、何を保証しないか。
Jev の出力は、すべて宣言したスキーマに一致する。LLM が問いと無関係な文章を生成する現象は、出力が型に限定されている以上、構造上起きない。TypeSafe はこの性質を「幻覚を起こさない」と表現している。しかし、型が正しいことと判断が正しいことは別の問題である。
技術分析では「スキーマへの一致は保証される。だが誤った選択肢を高い確信度で返すことはある」と指摘されている。たとえば 3 択の分類で正解が A であるとき、Jev が B を 0.95 の確信度で返すことは、型の制約に違反しない。出力の形式は常に有効だが、選ばれた値が正しいかどうかは型では分からない。
開発者コミュニティの議論でも「型安全は事実の正しさではない。完全に間違った有効な値を出力できる」という反論が出ている。この区別を見落とすと、形式の保証を正しさの保証と取り違える。
05資材審査の分類・振り分け・トリアージは型付き判断の対象になる
型安全が形式の保証であって正しさの保証ではない以上、業務の工程を形式保証で足りるものと正しさの検証が要るものに分けて考える必要がある。資材審査の工程には、選択肢が事前に定義できる判断が含まれる。
適応症の分類
資材がどの適応症に該当するかを事前定義の選択肢から判定する工程。選択肢が決まっていれば Choice 型の出力で置き換えうる。
禁止表現の有無判定
誇大表現や未承認適応の記載があるかを真偽で返す工程。選択肢を「あり」「なし」の 2 つに定めた Choice 型で自動化の候補になる。
繁忙期のトリアージ
審査件数が集中する時期に優先度を付ける工程。Score 型の順位付けで支援できる。
実務の試験では、ある開発者が 9,081 件の商品マッチング判定を Jev に処理させた。総費用は 0.32 ドル。50 件の抽出検証で 48 件が妥当と評価され、正答率は 96% だった。30% にあたる 2,686 件は確信度が低いとして人の判断に回されており、判断 AI が自ら例外を切り出す動作が確認されている。
選択肢が事前に定義された判断であれば、型付きモデルの対象になりうることを示す事例である。ただし資材審査は医薬品の規制下にあり、導入には検証要件が伴う。現時点で導入が可能だと断定はできない。
06LLM は確信度を直接返せず、Jev は較正済み確率を出力する設計にした
資材審査の工程で判断 AI を使うには、判断の確信度が信頼できる必要がある。TypeSafe は、LLM の自己回帰生成では出力トークンの確率と判断の確信度が一致しないと主張し、RLHF や RLVR と対比する形で RLCD を提案している。
TypeSafe は RLCD と呼ぶ訓練手法を用いている。正式名は Reinforcement Learning for Calibrated Decisions であり、人間の好みではなく、確信度と正答率の対応を直接最適化するとしている。出力の確信度が 0.9 であれば、その判断が正しい割合も 90% 前後になるよう較正する設計である。
しかし技術分析(pearpages)が指摘するとおり、RLCD の具体的なアーキテクチャは公開されていない。報酬関数も訓練手順も開示されておらず、較正曲線や信頼性図表も公表されていない。較正精度の独立検証は存在しない。実務の試験者は「50 件の手作業の検証では、0.85 が本当に 85% を意味するかは検証できない」と明記している。較正が正しいという前提で設計するのではなく、較正を自分で検証する仕組みが先に要る。
07閾値・例外経路・事後監査の 3 つを先に設計する
較正済み確率の独立検証がまだない以上、利用する側で確率をどう扱うかの設計が先になる。判断 AI を導入する側が先に決めるべきは、モデルの性能ではなく、判断の結果をどう扱うかの仕組みである。
閾値の設定
確信度がいくつ以上なら自動処理とするかを、業務の許容誤差から逆算して決める。閾値を厳しくすれば人の負担は増え、緩くすれば誤判断が増える。その均衡点は業務ごとに異なる。
例外経路の設計
確信度が閾値を下回った件を、誰がどの手順で判断するかを事前に定める。例外が全体の何割になるかの見積もりも、運用の前提に要る。
事後監査の仕組み
自動判断の正答率を定期に検証し、閾値と経路を更新する手順を組み込む。較正のずれは時間とともに起きうる。
この 3 つが先に設計されていれば、判断 AI の性能が変わっても、変わるのは閾値の数字だけであり、仕組みは維持できる。判断 AI の製品が入れ替わっても、閾値と例外経路と監査の枠組みはそのまま使える。
判断が速く安くなることの価値は、判断そのものが消えることにあるのではない。人間の仕事が「判断する」から「判断の条件を設計する」へ移ることにある。その設計を先に済ませた組織が、速さと安さを実際の業務改善に変換できる。
なお、当サイトは Anthropic の Claude を使って運営されている。Jev は LLM と補完的に使われうる製品であり、この記事を書く側にも利害の近さがあることは記しておく。
- TypeSafe AI の Jev は文章生成を捨て型付き判断だけを返す設計で、独立試験では 5〜25 倍速・最大 8.6 倍安だが、自社評価の 193 倍速・444 倍安は特定条件の最大値である。
- 型安全は出力形式の一致を保証するが判断の正しさは別の問題であり、較正精度の独立検証はまだ存在しない。
- 判断 AI が安く速くなるほど、人間の役割は個々の判断から閾値の設定・例外の処理・結果の監査という設計側へ移る。
判断が速く安くなっても、判断の正しさを保証するのは型ではなく検証の仕組みである。Jev が示したのは、判断を生成から分離できるという設計の選択肢であり、その選択肢の価値は人間の側の設計にかかっている。
人間の役割は判断そのものから、閾値・例外・監査を設計する側へ移る。その移動を価値に変えられるかどうかは、判断 AI の性能ではなく、導入する側が何を先に設計したかで決まる。
- TypeSafe AI Blog. Introducing System One Models & Jev. 2026-09-15.(Jev の設計・出力形式・応答時間・RLCD の概要)
- The Cherry Creek News. TypeSafe's Jev Claims 193x Faster and 444x Cheaper. 2026-09-16.(Near Here の独立試験: 96% 正答率・5 倍速・8.6 倍安)
- paddo.dev. The Thirty-Cent Judge: TypeSafe's Jev on a Real Product-Matching Queue. 2026-09-17.(9,081 件の実務試験: $0.32・正答率 96%・較正未検証の指摘)
- pearpages. Jev, Sorted: What TypeSafe's 'System One' Model Actually Is, and What Is Still Just a Claim. 2026-09-16.(型安全と判断の正しさの区別・RLCD の未検証)
- PC Watch. LLMの193倍速い"判断だけのAI"「Jev」、ChatGPTの共著研究者が開発. 2026-09-16.(Jev の制約と自社評価の条件)
- Latent Space. Jev: a 'System One Model' that only decides/classifies/routes/scores. 2026-09-15.(Jev の技術的位置づけ)
- Hacker News. Discussion: TypeSafe AI Jev. 2026-09-15.(型安全が正しさを意味しないという議論)