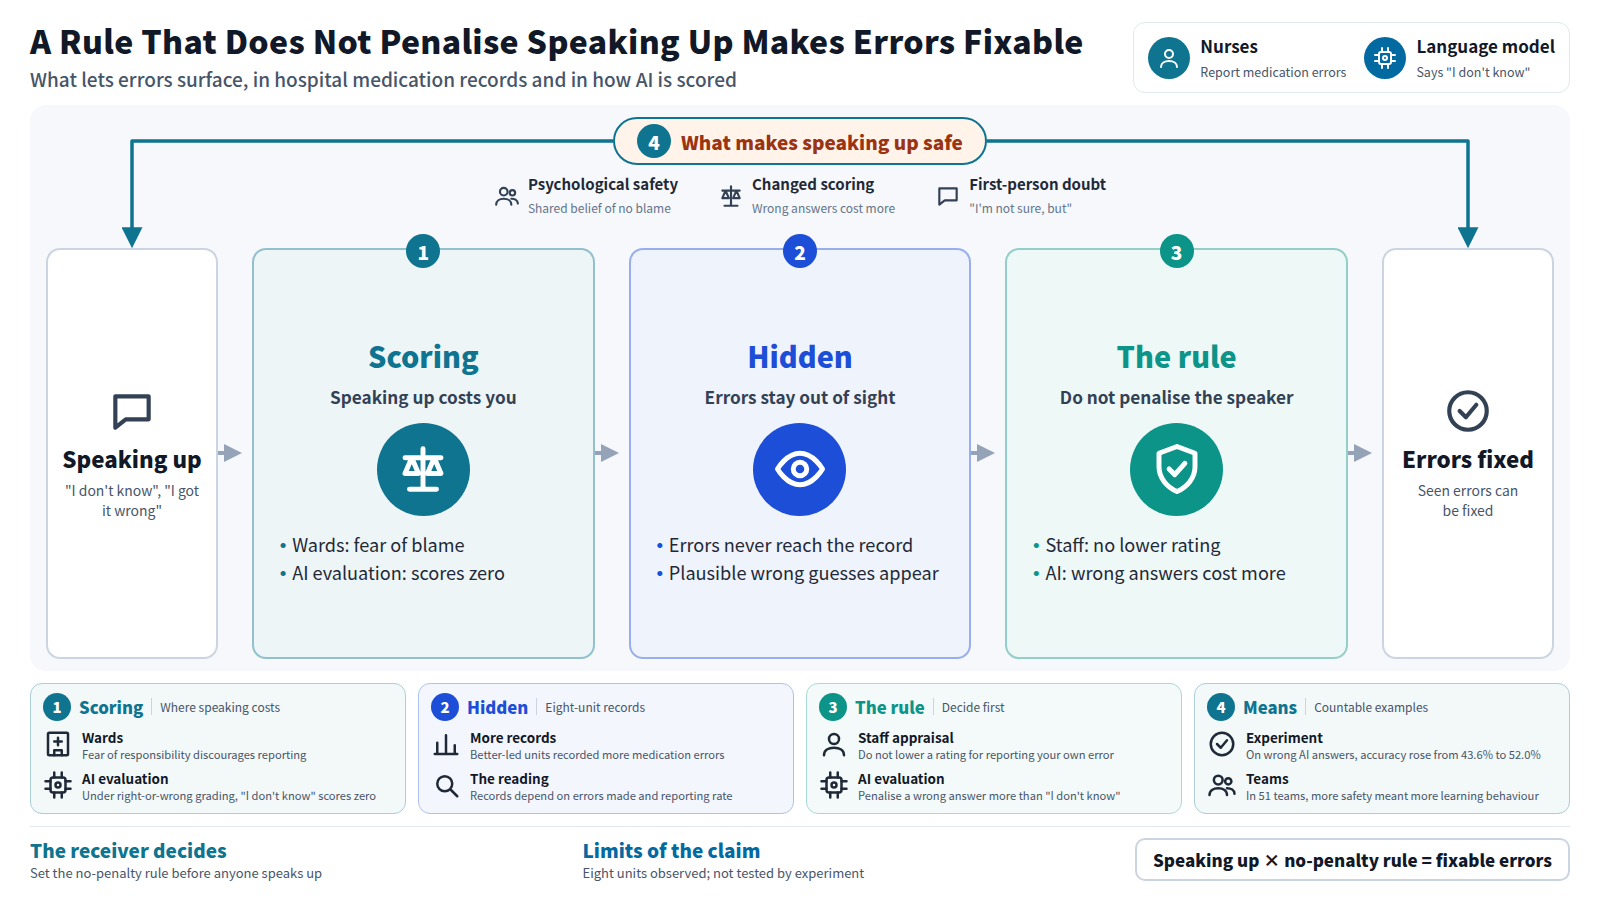
أجب بـ«لا أعلم» فتحصل على صفر؛ خمّن، وقد تكون على صواب. في سبتمبر 2025 جادل باحثو OpenAI بأن نماذج الذكاء الاصطناعي، لأنها تُقيَّم بهذه الطريقة، تخمّن بدلًا من أن تعترف بأنها لا تعلم. ماذا يتيح لك إظهار ضعفك، والاعتراف بأنك لا تعرف أو بأنك أخطأت؟ وهذا يجعل من الممكن اكتشاف الأخطاء وإصلاحها. وتبقى هذه الفرصة قائمة حيث لا يُعاقَب من يتكلم على كلامه.
01القدرة على قول «لا أعرف» تتيح فرصة لتصحيح الأخطاء
حين يقول أحدهم «لا أعرف» أو «أخطأت في ذلك»، ينتقل الخطأ إلى مكان يستطيع الآخرون رؤيته فيه. والخطأ الذي يمكن رؤيته يمكن إصلاحه، أما الذي يبقى مخفيًا فلا. لاحظت عالمة الإدارة Amy Edmondson هذا التسلسل في أجنحة المستشفيات، ثم لاحقًا في فرق داخل شركة تصنيع.
التسلسل نفسه يعمل في طريقة تقييم الذكاء الاصطناعي. ففي ورقة بحثية عام 2025، أشار آدم تاومان كالاي وزملاؤه في OpenAI إلى أن معظم معايير تقييم النماذج اللغوية تمنح الإجابة "لا أعرف" صفر نقاط. ونتيجة لذلك، تتعلم النماذج التخمين بثقة.
سواء كان المتحدث شخصًا أم نموذجًا، تبقى الأخطاء بعيدة عن الأنظار حين يعاقِب نظام التقييم من يعترف بها. لذا على كل من يقيّم تقرير زميل أو إجابة ذكاء اصطناعي أن يقرّر مسبقًا ألّا يعاقب من يتكلّم.
02ثماني وحدات في المستشفيات، 1996: الوحدات الأفضل قيادةً سجّلت أخطاءً دوائية أكثر
الدراسة الأولى التي وضعت أرقامًا لهذا التسلسل نظرت في السجلات الطبية للمستشفيات. ففي ورقة بحثية صدرت عام 1996، قارن Edmondson بين الأخطاء الدوائية المسجلة في ثماني وحدات داخل مستشفيات جامعية. وسجلت الوحدات التي تتمتع بتوجيه أقوى من مديرة أو مدير التمريض وبعلاقات عمل أفضل أخطاءً أكثر، لا أقل.
عند قراءته قراءة ساذجة، يقول إن الوحدات الجيدة ترتكب أخطاء أكثر. لكن إدموندسون قرأته قراءة أخرى. فعدد الأخطاء التي تصل إلى السجل يعتمد على أمرين: كم خطأً يقع فعلاً، وكم مرة يُبلَّغ عنه. ففي الوحدات ذات العلاقات الجيدة، وجدت الممرضات أن الإبلاغ عن أخطائهن أسهل، فوصل عدد أكبر منها إلى السجل. كان هذا تفسيرها.
عندما يتحدث هذا المقال عن إظهار الضعف، فهو لا يقصد افتقار القدرة بوجه عام. بل يقصد القول صراحةً إنك لا تعرف أو إنك أخطأت في أمر ما. ومن صوره أن تبلّغ ممرضة أو ممرض عن خطأ دوائي ارتكبه بنفسه.
03من إعطاء الأدوية إلى إجابات الذكاء الاصطناعي، لا تظهر الأخطاء إلا في الأماكن التي تسمح بالتحدث عنها
تعتمد الأخطاء المسجَّلة على مدى سهولة الإبلاغ عنها. وقد توصلت إدموندسون إلى ذلك في إعطاء الأدوية في أجنحة المستشفيات. وعلى صعيد أخطاء المستشفيات، نشر معهد الطب الأمريكي تقريره «الخطأ من طبيعة البشر» (To Err Is Human) عام 2000. وقدّر التقرير أن ما يصل إلى 98,000 شخص يموتون كل عام بسبب أخطاء طبية تقع في المستشفيات. كما وجد أن الخوف من تحمّل المسؤولية يثني الناس عن الإبلاغ عن الأخطاء.
تعتمد الاختبارات التي تقيس نماذج الذكاء الاصطناعي نوعًا مشابهًا من التقييم. فكثير من المعايير يصنّف الإجابة على أنها صحيحة أو خاطئة فقط. وبموجب هذا النظام تحصل عبارة "لا أعرف" على صفر، تمامًا كالإجابة الخاطئة، بينما يملك التخمين فرصة معينة لنيل درجة.
| الجانب | الممرضون في وحدة بالمستشفى | تقييم النماذج اللغوية |
|---|---|---|
| الاعتراف بخطأ أو بعدم يقين | الخوف من تحمّل المسؤولية | يحصل على صفر |
| الالتزام بالصمت | لا يصل الخطأ إلى السجل أبدًا | ظهور إجابات خاطئة تبدو معقولة |
| ما الذي يجعل التعبير عن الرأي ممكنًا | علاقات جيدة داخل الوحدة | تقييم يعاقب الإجابات الخاطئة بشدة أكبر |
يختلف الموقفان في العمل الجاري وفي من يتحدث. أما ما يجمع بينهما فهو أن إقدام أي شخص على الكلام يعتمد على ما يعود على من يتكلم.
04البشر والذكاء الاصطناعي كلاهما يخفي الأخطاء عندما يعاقب التقييم من يعترف بها
في الجناح، يجلب الاعتراف بالخطأ اللوم؛ وفي اختبارات الذكاء الاصطناعي المرجعية، يكلّف الاعتراف بالجهل خسارة نقاط. فلماذا إذن يلتزم الناس الصمت وتبدأ النماذج بالتخمين؟
في عام 1999 درست إدموندسون 51 فريقًا في شركة تصنيع. نظرت في اعتقاد مشترك بين أعضاء الفريق: أنه في هذا الفريق لن يُلام المرء على طرح الأسئلة أو الإبلاغ عن الأخطاء. وعرّفته بأنه اعتقاد مشترك بأن الفريق آمن لتحمّل المخاطر في العلاقات بين الأفراد، وأطلقت عليه اسم الأمان النفسي.
انخرطت الفرق التي تتمتع بقدر أكبر من الأمان النفسي بصورة أكبر في سلوكيات التعلّم، مثل مناقشة الأخطاء وطلب المساعدة. كما أن الفرق التي انخرطت أكثر في سلوكيات التعلّم حققت أداءً أفضل.
أظهر كالاي وزملاؤه المؤلفون المشاركون التسلسل نفسه للنماذج اللغوية في صيغة رياضية. فعند التصحيح القائم على الصواب أو الخطأ، تكون عبارة "لا أعرف" أسوأ إجابة ممكنة. أما التخمين الواثق فيحقق درجة متوقعة أعلى. وتشير الورقة البحثية نفسها إلى طلاب يملؤون الفراغات في الامتحان بالتخمين. والنماذج كذلك تتكيف مع نظام التصحيح وتتعلم أن تقدم إجابة حتى حين لا تعرف.
05عندما أضاف الذكاء الاصطناعي عبارة «لست متأكدًا، لكن»، قلّ عدد المستخدمين الذين اتبعوا إجاباته الخاطئة
إذا كان التقييم الذي يعاقب المتحدث يدفع الأخطاء إلى الاختباء، فكيف يمكن بناء تقييم لا يفعل ذلك، وكم يُحدث من فرق؟ تقدم ثلاث دراسات أمثلة يمكن إحصاؤها.
تغيير نظام التقييم
اقترح كالاي وزملاؤه أن يُطلب من النموذج الإجابة فقط إذا تجاوزت ثقته القيمة t، مع خصم t/(1−t) نقطة على الإجابات الخاطئة. فتحصل عبارة «لا أعرف» على صفر ولا تعود أسوأ من الإجابة الخاطئة.
Voice uncertainty in the first person
في تجربة أجراها Kim وزملاؤه على 404 مشاركين، حين أضاف الذكاء الاصطناعي عبارة «لست متأكدًا، لكن» بصيغة المتكلم، ارتفعت دقة المستخدمين في الأسئلة الطبية التي أخطأ فيها الذكاء الاصطناعي من 43.6% إلى 52.0%.
اعتقاد مشترك داخل الفريق
أظهرت أبحاث غوغل الداخلية أن الأمان النفسي هو الأهم بين خمس ديناميكيات تميّز الفرق الفعّالة.
وفقًا لكيم وزملائه، جعلت التعبيرات عن عدم اليقين بصيغة المتكلم المستخدمين أقل ميلًا إلى الموافقة ببساطة على إجابة الذكاء الاصطناعي. وكان التحسن في الدقة أكبر في الأسئلة التي أخطأ فيها الذكاء الاصطناعي. فعندما يصرّح الذكاء الاصطناعي بعدم يقينه، يصبح المستخدمون أقل انجرافًا وراء أخطائه.
06وجود وحدة تبلّغ عن أخطاء كثيرة، أو ذكاء اصطناعي يقول «لا أعرف»، ليس بالضرورة علامة سيئة
عندما عبّر الذكاء الاصطناعي عن عدم اليقين بصيغة المتكلم، قلّ عدد الأشخاص الذين اتبعوا إجاباته الخاطئة. وتعتمد فائدة التقرير أو الإجابة التي تُظهر ضعفًا على الطريقة التي يتعامل بها المتلقي معها. هناك ثلاثة أمور تستحق أن تُقرأ قراءة مختلفة.
الوحدات التي تبلّغ أكثر
عبر الوحدات الثماني، سجّلت الوحدات ذات القيادة الأفضل عددًا أكبر من الأخطاء.
عبارة «لا أعلم» لدى الذكاء الاصطناعي
قلّل التعبير عن عدم اليقين بصيغة المتكلم من الاعتماد المفرط على إجابات الذكاء الاصطناعي الخاطئة.
قواعد الاستنباط
في التقييم القائم على الصواب والخطأ، التخمين هو الأكثر ربحًا.
على من يقارن بين الأقسام بحسب تقارير الأخطاء ألا يفترض أن القسم الذي يبلّغ أكثر هو الأسوأ. فقد يكون القسم الذي لديه تقارير قليلة يرتكب أخطاء قليلة، أو قد يكون عاجزاً ببساطة عن الكلام. والعدد وحده لا يستطيع التمييز بين الحالتين.
على من يستخدم إجابات الذكاء الاصطناعي ألا يعدّ عبارة "لا أعرف" أو "لست متأكداً" عيباً. والأمر نفسه ينطبق على المستندات المصاغة بالذكاء الاصطناعي التوليدي. فحيثما وضع الذكاء الاصطناعي علامة على مقطع بأنه يحتاج إلى تحقق، أبقِ العلامة وابدأ المراجعة من هناك.
على من يضع قواعد التقييم أن يحدد أولاً نظام تسجيل لا يعاقب من يتكلم. ففي تقييم الموظفين، يعني ذلك ألا يُخفَّض تقييم شخص لأنه أبلغ عن خطئه هو. وفي تقييم الذكاء الاصطناعي، يعني أن تُعاقَب الإجابة الخاطئة بشدة أكبر من "لا أعرف".
07أكثر من عبارة «لا أعرف» من الذكاء الاصطناعي يعتمد على معايير التقييم التي يضعها المطوّرون والمستخدمون
هل سينتشر تقييم لا يعاقب المتحدث؟ كتب كالاي وزملاؤه أن تخمين الذكاء الاصطناعي لن يتراجع ما لم يتغير تقييم المعايير الأكثر استخدامًا. لا يكفي إضافة معيار آخر يقيس الأخطاء. فإذا استمرت معظم المعايير في تصحيح الإجابات بالصواب أو الخطأ فقط، ستظل النماذج تميل إلى التخمين. وتعتمد زيادة قول الذكاء الاصطناعي «لا أعرف» على كيفية تعامل من يبنون التقييمات ومن يستخدمون الذكاء الاصطناعي مع هذه الإجابة.
ما يمكن أن يقوله هذا المقال عن أماكن العمل البشرية له حدود. فقد رصدت دراسة Edmondson عام 1996 ثماني وحدات. أما القراءة القائلة إن زيادة السجلات تعكس سهولة الإبلاغ فلم تُختبر تجريبيًا. ورقم 98,000 وفاة في To Err Is Human هو الحد الأعلى لتقدير.
ومع ذلك، أنا متأكد من أمر واحد. كيفية التعامل مع من يعترف بخطئه أمر يستطيع المتلقي أن يقرره. ووقت القرار هو قبل أن يتكلم أي أحد.
- في الدراسة التي شملت ثماني وحدات، سجّلت الوحدات ذات القيادة الأفضل أخطاءً دوائية أكثر. لا تفترض أن الوحدة التي تبلّغ عن أخطاء أكثر ترتكب أكثر.
- عندما عبّر الذكاء الاصطناعي عن عدم اليقين بصيغة المتكلم، ارتفعت دقة المستخدمين في إجاباته الخاطئة من 43.6% إلى 52.0%. لا تعامل عبارة «لا أعرف» من الذكاء الاصطناعي على أنها عيب.
- في التقييم القائم على الصواب والخطأ، تحصل عبارة "لا أعرف" على أسوأ درجة ويُكافأ التخمين. ضع نظام تقييم لا يعاقب من يتكلم، للبشر والذكاء الاصطناعي على حد سواء.
إظهار ضعفك، أو قول إنك لا تعرف أو إنك أخطأت، يجعل الأخطاء مرئية ويتيح إصلاحها. وهذه الفرصة لا تدوم بالشجاعة وحدها. إنها تدوم حيث لا يعاقب التقييم من يتحدث.
في البلاغات البشرية كما في عبارة الذكاء الاصطناعي "لا أعرف"، المتلقّي هو من يضع ذلك التقييم أولاً. أما أنا، فقد قررت مسبقاً ما ستكون كلماتي الأولى حين يقول لي أحدهم: "لقد أخطأتُ".
- إيمي سي. إدموندسون. التعلّم من الأخطاء أسهل قولًا منه فعلًا: تأثيرات الجماعة والمنظمة في اكتشاف الخطأ البشري وتصحيحه. Journal of Applied Behavioral Science 32(1), 1996.(سجلات أخطاء الدواء في ثماني وحدات، وتفسير الإبلاغ)
- إيمي إدموندسون. الأمان النفسي وسلوك التعلم في فرق العمل. Administrative Science Quarterly 44(2), 1999.(تعريف السلامة النفسية؛ وصلتها بسلوك التعلم والأداء في 51 فريقًا)
- معهد الطب. الخطأ من طبيعة البشر: بناء نظام صحي أكثر أمانًا. National Academies Press, 2000.(تقدير يصل إلى 98,000 وفاة سنويًا بسبب أخطاء المستشفيات؛ وعوائق الإبلاغ)
- آدم توْمان كالاي، أوفير ناخوم، سانتوش س. فيمبالا، إدوين تشانغ. لماذا تهلوس النماذج اللغوية. arXiv:2509.04664, 2025.(التقييم الثنائي يكافئ التخمين؛ واقتراح التسجيل t/(1−t)؛ والحاجة إلى تغيير المعايير الرئيسية)
- Sunnie S. Y. Kim, Q. Vera Liao, Mihaela Vorvoreanu, Stephanie Ballard, Jennifer Wortman Vaughan. "لست متأكدًا، لكن...": دراسة أثر تعبير النماذج اللغوية الكبيرة عن عدم اليقين على اعتماد المستخدمين وثقتهم. FAccT 2024 / arXiv:2405.00623.(404 مشاركين؛ من 43.6% إلى 52.0%)
- فكّر مع Google. ديناميكيات الفريق: المفاتيح الخمسة لبناء فرق فعّالة. 2023.(السلامة النفسية بوصفها أهم عامل ديناميكي في أبحاث Google)