「分からない」と答えれば 0 点、当て推量なら当たる見込みがある。2025 年 9 月、OpenAI の研究者は、AI の採点がこの形をしているので、AI は分からないと言わずに推測すると論じた。自分の弱さ、つまり分からないことや間違えたことを人に見せることは、何を可能にするのか。誤りが見つかり、直される機会を可能にする。その機会は、言った人を減点しない決まりがある場で続く。
01分からないと言えることが、誤りを直す機会をつくる
分からない、間違えた、と口にすると、誤りは周りの人に見える場所に出る。見えた誤りは直せる。見えない誤りは直せない。経営学者の Amy Edmondson は、この順序を病院の病棟で確かめ、のちに製造会社のチームでも確かめた。
AI を採点する場でも、同じことが起きている。OpenAI の Adam Tauman Kalai らは 2025 年の論文で、言語モデルの採点の多くが「分からない」を 0 点にすると指摘した。そのため、モデルは自信のある当て推量を覚える。
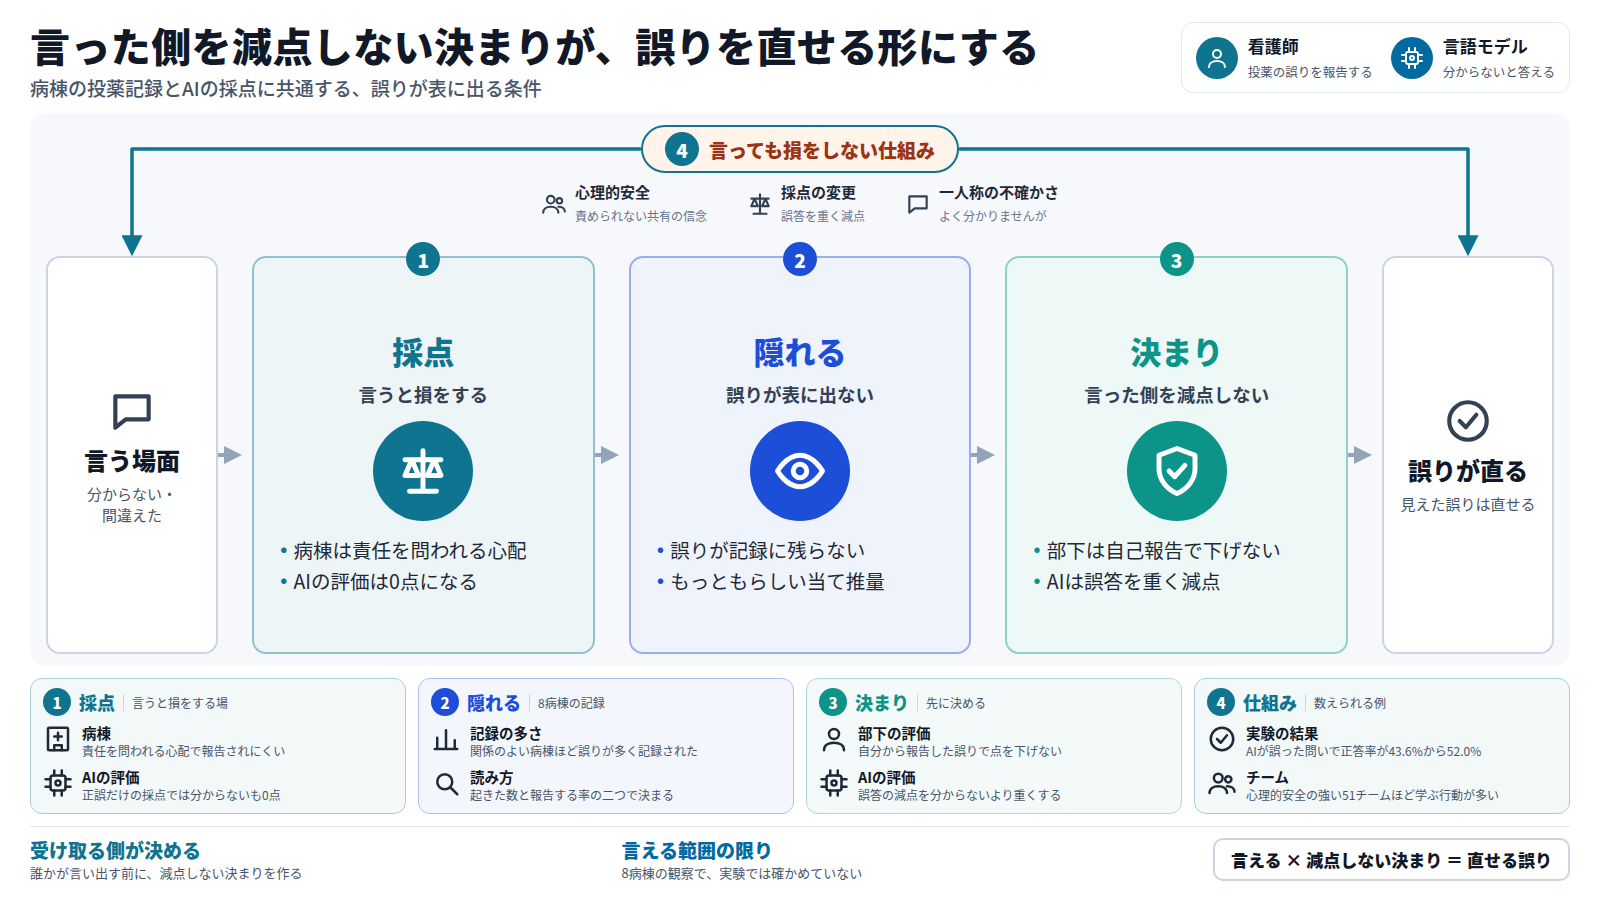
人でも AI でも、言った側が損をする採点の下では、誤りは表に出てこない。だから部下の報告や AI の答えを評価する人は、言った側を減点しない決まりを、先に自分で決めることになる。
021996年の8病棟で、関係のよい病棟ほど投薬の誤りが多く記録された
誤りを言えば直せる、という順序を数字で示した最初の研究は、病棟の記録を調べたものだった。Edmondson は 1996 年の論文で、大学病院の 8 つの病棟を調べ、投薬の誤りの記録を比べた。看護師長の指導が強く、病棟の人間関係がよいところほど、記録された誤りが多かった。
この結果は、よい病棟ほど誤りを犯す、と読めてしまう。Edmondson は別の読み方をした。記録に残る誤りの数は、実際に起きた誤りの数と、それを報告する率の二つで決まる。関係のよい病棟では、看護師が誤りを報告しやすかった。そのため記録に残る誤りが増えた、という解釈である。
この記事で「弱さを見せる」と言うときは、能力が足りないこと全般を指さない。分からない、間違えた、と口に出すことに限る。看護師が自分の投薬の誤りを報告するのは、その一つの形である。
03病棟でもAIの評価でも、誤りは言える場にだけ集まる
誤りの記録が多いかどうかは、報告しやすいかどうかで決まる。Edmondson はこのことを、病棟で医薬品を投与する場面で見つけた。病院で起きる誤りがどれほど大きいかについて、米国の医学研究所は 2000 年に報告書『To Err Is Human』を出した。研究所は、病院で起きる医療の誤りで、年に最大 98,000 人が亡くなると推計した。また、責任を問われる心配のために、誤りが報告されにくくなっていると書いた。
AI の成績を測る試験にも、「分からない」と言うと損をする採点がある。多くの評価では、答えを正解か誤答かだけで採点する。そこでは「分からない」と答えても、誤答と同じ 0 点になる。当て推量で答えれば、点を取れる見込みが残る。
| 見るところ | 病棟の看護師 | 言語モデルの評価 |
|---|---|---|
| 誤りや不確かさを言うと | 責任を問われる心配がある | 0 点になる |
| 言わないと | 誤りが記録に残らない | もっともらしい誤答が出る |
| 言えるようにするもの | 関係のよい病棟 | 誤答を重く減点する採点 |
二つの場面では、仕事の中身も、誤りを言う者も違う。それでも、言ったあとに何が返ってくるかで言うかどうかが決まる点は同じである。
04人もAIも、言った側が損をする採点の下では誤りを出さない
病棟では誤りを言うと責任を問われ、AI の評価では分からないと言うと 0 点になる。では、なぜ人は言わなくなり、モデルは推測するようになるのか。
Edmondson は 1999 年、製造会社の 51 のチームを調べた。調べたのは、このチームでは質問や失敗の報告をしても責められない、というメンバーの共有の思いである。Edmondson はこの思いを、対人関係のリスクを取っても安全だというチームの信念と定義し、心理的安全と名付けた。
心理的安全の強いチームほど、失敗を話し合い、助けを求めるといった学ぶための行動が多かった。そして、学ぶための行動が多いチームほど、成果も高かった。
Kalai らの論文は、言語モデルについて同じ順序を数式で示した。正誤だけで採点すると、「分からない」は最も損な答えになる。自信のある当て推量のほうが、平均の点は高くなる。論文は、学生が試験の空欄を推測で埋める例も挙げている。モデルも採点に合わせて、分からないときにも答えを作るようになる。
05AIが「よく分からないが」と添えると、AIの誤答に従う人が減った
人も AI も、言うと損をする場では誤りを隠す。それなら、損をしない採点はどう作れ、どれだけ効くのか。三つの研究が、数えられる例を出している。
採点を変える
Kalai らは、確信が t を超えるときだけ答えるよう求め、誤答には t/(1−t) 点を差し引く採点を示した。「分からない」は 0 点で、誤答より損をしない。
一人称で不確かさを言う
Kim らの 404 人の実験では、AI が「よく分かりませんが」と一人称で添えると、AI が誤った医療の問いで、利用者の正答率が 43.6% から 52.0% に上がった。
チームの共有の信念
Google の社内調査は、成果を上げるチームを分ける五つの要因のうち、心理的安全を最も重要とした。
Kim らの論文によると、AI が一人称で不確かさを添えると、利用者が AI の答えにそのまま従う傾向は弱まった。正答率の上がり幅は、AI が誤った問いで特に大きかった。AI が自分の不確かさを言うことで、利用者は AI の誤りに引きずられにくくなる。
06報告の多い部署もAIの「分からない」も、悪い印とは限らない
AI が一人称で不確かさを言うと、AI の誤答に従う人が減った。弱さを見せた報告や答えが役に立つかどうかは、受け取る側の扱いで変わる。読み替える点は三つある。
報告が多い部署
8 病棟では、関係のよい病棟ほど誤りが多く記録された。
AIの「分からない」
一人称の不確かさは、AI の誤答に頼りすぎる人を減らした。
減点の決まり
正誤だけの採点では、当て推量が最も得になる。
報告の数で部署を比べる人は、報告の多い部署を悪い部署と決めつけないことになる。報告が少ない部署は、誤りが少ないのかもしれないし、言えないだけかもしれない。数だけでは二つを見分けられない。
AI の答えを使う人は、「分からない」や「確かではない」という返事を欠陥として扱わないことになる。生成 AI で文書を下書きしたときも同じである。AI が「要確認」と書いた箇所を消さずに残し、そこから見直しを始める。
評価の決まりを作る人は、言った側が損をしない採点を先に決めることになる。部下の評価なら、誤りを自分から報告したことで点を下げない。AI の評価なら、誤答の減点を「分からない」より重くする。
07AIの「分からない」が増えるかは、評価を作る人と使う人の採点で決まる
言った側が損をしない採点は、これから広がるのか。Kalai らは、よく使われる評価の採点を変えない限り、AI の当て推量は減らないと書いた。誤りを測る評価を一つ足すだけでは足りない。ほかの多くの評価が正誤だけで採点し続ければ、モデルは推測する方へ寄る。AI が「分からない」と答える場面が増えるかどうかは、評価を作る人と、AI を使う人の扱いにかかっている。
人の職場について、この記事が言える範囲には限りがある。Edmondson の 1996 年の研究は、8 つの病棟を観察したものだ。記録が多いのは報告しやすいからだ、という読み方は、実験で確かめたものではない。『To Err Is Human』の 98,000 人も、推計の上限である。
それでも、私は一つのことは確かだと考える。誤りを言った人をどう扱うかは、受け取る側が決められる。決める時期は、誰かが言い出す前である。
- 8 病棟の研究では、関係のよい病棟ほど投薬の誤りが多く記録された。報告の多い部署を、誤りの多い部署と決めつけない。
- AI が一人称で不確かさを言うと、AI が誤った問いで利用者の正答率が 43.6% から 52.0% に上がった。AI の「分からない」を欠陥として扱わない。
- 正誤だけの採点では「分からない」が最も損をし、当て推量が得になる。人にも AI にも、言った側が損をしない採点を先に決める。
自分の弱さ、つまり分からないことや間違えたことを人に見せることは、誤りを見える場所に出し、直す機会を可能にする。その機会は勇気だけでは続かない。言った側が損をしない採点があるところで続く。
人の報告にも AI の「分からない」にも、その採点を先に決めるのは受け取る側である。私も、部下から「間違えました」と聞いたときの最初の一言を、先に決めておくことにしている。
- Amy C. Edmondson. Learning from Mistakes Is Easier Said Than Done: Group and Organizational Influences on the Detection and Correction of Human Error. Journal of Applied Behavioral Science 32(1), 1996.(8 病棟の投薬の誤りの記録と、報告されやすさという解釈)
- Amy Edmondson. Psychological Safety and Learning Behavior in Work Teams. Administrative Science Quarterly 44(2), 1999.(心理的安全の定義と、51 チームでの学ぶための行動・成果との結び付き)
- Institute of Medicine. To Err Is Human: Building a Safer Health System. National Academies Press, 2000.(病院の医療の誤りで年に最大 98,000 人という推計と、報告の妨げ)
- Adam Tauman Kalai, Ofir Nachum, Santosh S. Vempala, Edwin Zhang. Why Language Models Hallucinate. arXiv:2509.04664, 2025.(正誤だけの採点が当て推量を得にすること、t/(1−t) の採点、主要な評価の採点を変える必要)
- Sunnie S. Y. Kim, Q. Vera Liao, Mihaela Vorvoreanu, Stephanie Ballard, Jennifer Wortman Vaughan. "I'm Not Sure, But...": Examining the Impact of Large Language Models' Uncertainty Expression on User Reliance and Trust. FAccT 2024 / arXiv:2405.00623.(404 人の実験、43.6% から 52.0%)
- Think with Google. Team dynamics: The five keys to building effective teams. 2023.(Google の社内調査で心理的安全が最も重要とされたこと)