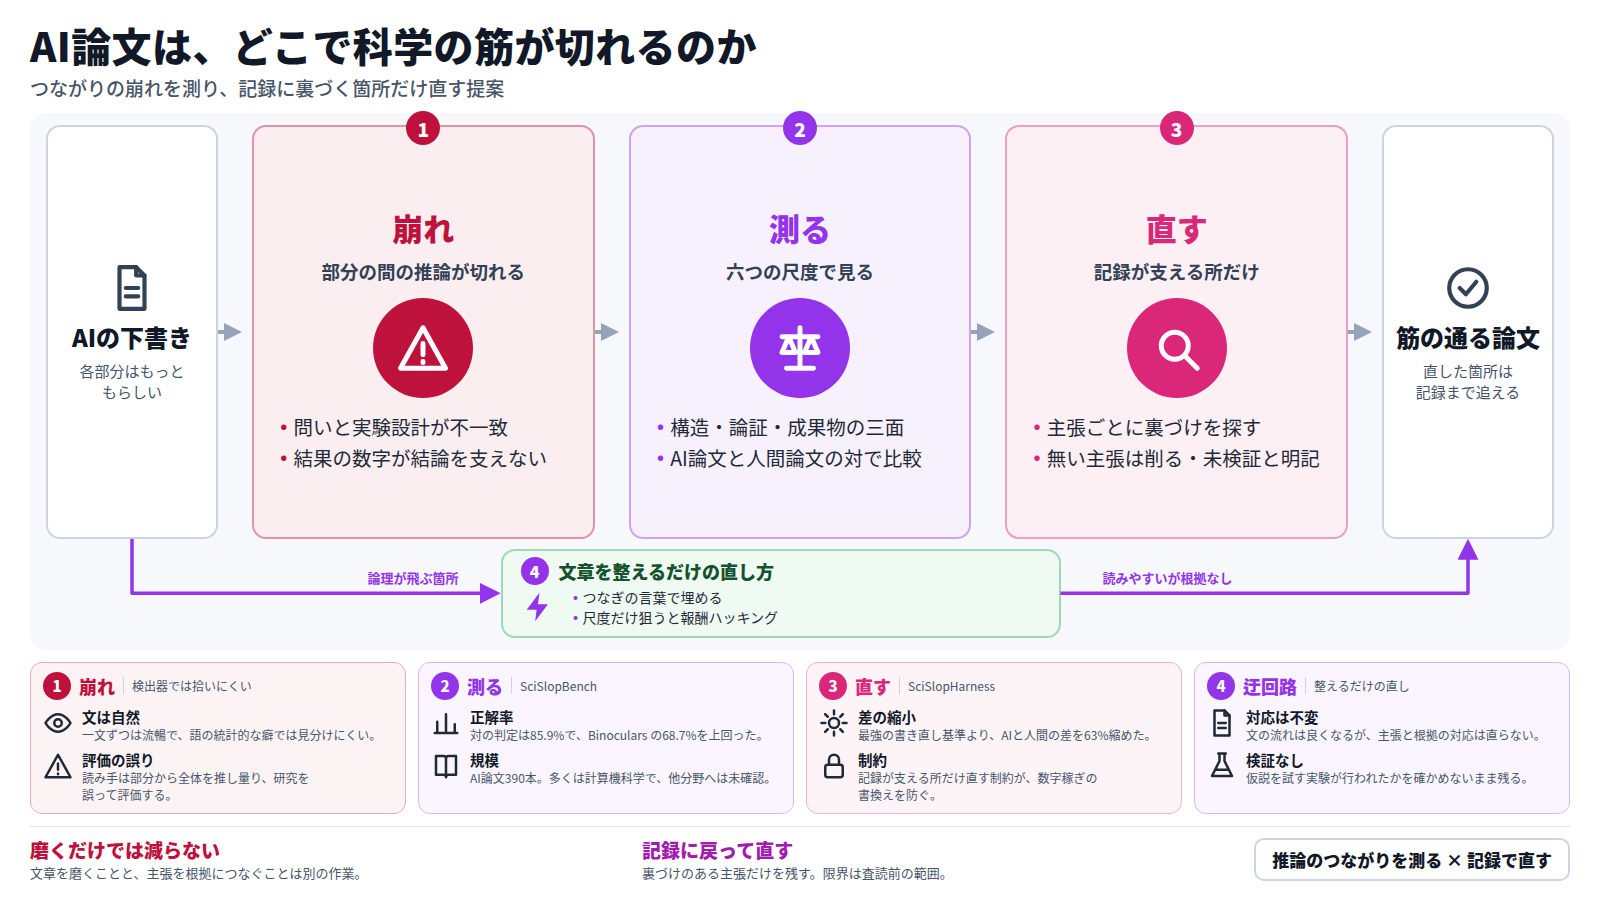
1. 部分は読めるのに、全体として筋が通らない論文
AI が生成した低品質な文章は、英語圏で「AI slop」と呼ばれるようになった。とくに学術の場では、論文の下書きや査読コメントに AI の文章が混ざることが珍しくなくなっている。[1]
ただ、論文の場合、問題は文章の不自然さだけではない。著者らの言い方を借りれば、AI が生成した科学論文では、各部分はもっともらしく見えるのに、部分どうしをつなぐ科学の推論が崩れていることがある。導入で掲げた問いと実験の設計がかみ合っていない、結果の節に書いた数字が結論の主張を支えていない、といった崩れである。読み手は部分の出来から全体を推し量るため、この崩れは研究の評価を誤らせる。
こうした崩れは、トークン単位で文章の統計的な癖を見る既存の AI 検出器では拾いにくい、と著者らは主張する。文の一つひとつは自然だからである。一次情報は arXiv に公開されたプレプリントで、査読前の段階にある。
2. 提案の芯は、論文の「つながり」を測る尺度
手法の芯は一つに絞れる。文章の表面ではなく、論文全体の推論のつながりを測ることである。著者らは科学的スロップを、構造(Structure)、論証(Argument)、成果物(Artifacts)の三つの面にわたる六つの尺度で測る。各尺度の具体的な定義は abstract には書かれていないが、名前からは、論文の組み立て、主張と根拠の対応、図表やコードなど成果物と本文の対応を見るものと読める。
測るための場として、著者らは SciSlopBench を作った。AI が生成した論文 390 本からなり、多くは計算機科学だが、生命科学、社会科学、自然科学にも広がっている。各論文には、研究課題と貢献の種類を揃えた人間の論文が一本ずつ対として付く。同じ問いに対する AI の論文と人間の論文を並べて比べられるようにした設計である。
そのうえで、スロップを減らすための枠組み SciSlopHarness を提案している。固定した LLM を導き、実験記録が裏づける箇所だけを修正させるハーネスである。
3. abstract の範囲で示されたこと
第一に、六つの尺度で対のどちらが AI の論文かを判定すると、正解率は 85.9% だった。比較対象の検出器 Binoculars は 68.7% である。[4]文章の統計的な癖ではなく、推論のつながりを見るほうが見分けやすかった、というのが著者らの読みである。
第二に、スロップの度合いは人間の論文の評価とも関係していた。スロップが多い論文ほど ICLR での評価が低く、採択された論文と不採択の論文を、2017 年から 2025 年のどの年でも偶然より高い精度で分けたという。
第三に、スロップを減らすのは簡単ではなかった。尺度そのものを直接最適化するとうまくいかない。通常の書き直しではスロップが残り、スロップを意識させる指示を直接与えると、報酬ハッキング、つまり尺度の数字だけをよく見せる書き換えが起きた。これに対し SciSlopHarness は、最も強い書き直しのベースラインと比べて、残っていた AI と人間の差を 63% 縮めたと報告している。人間の論文を目標として与える必要は無い。実装は GitHub で公開されている。[3]
4. 具体例で見る ── 文章を整えるか、記録に戻るか
AI に下書きさせた研究報告書の考察を、社内レビューで直す場面を考える。同じ「直す」でも、やり方は二つに分かれる。
文章を整える直し方
考察の論理が飛んでいる箇所を、つなぎの言葉で埋める。「この結果は、前述の仮説と整合的であり」と一文足せば、読みやすくはなる。しかし、その仮説を検証する実験が本当に行われたかは確かめていない。文の流れはよくなっても、主張と根拠の対応は直っていない。尺度だけを見て直すと、この形になりやすい。
記録に戻る直し方
考察の主張を一つずつ取り出し、実験ノートや解析ログのどこに裏づけがあるかを探す。裏づけが見つかった主張は、その記録に合わせて書き直す。見つからない主張は、書き換えるのではなく削るか、未検証と明記する。手間はかかるが、直した箇所はすべて記録までたどれる。
論文の SciSlopHarness は右側の考え方をとっている。記録が支える箇所だけを直すという制約が、報酬ハッキングを避ける役を果たしている、と著者らは位置づけている。
5. 新しくない部分と、abstract から読み取れない限界
AI が書いた文章を見分ける研究は多い。二つの言語モデルの出力の差から機械生成文を見分ける Binoculars もその一つで、学習データ無しで動く検出器として提案された。[4]論文の質を、構造や主張と根拠の対応で点検するという考え方も、査読の作法としては昔からある。この論文の寄与は、それをAI 生成論文の推論の崩れとして定義し、対にした比較で測れる形にした点と、修正の側で記録への裏づけを条件にした点にある、と読める。
限界も多い。第一に、六つの尺度の定義と、それをどう計算するかは abstract には書かれていない。LLM に判定させているのであれば、判定役の癖が結果に入る。第二に、対にした人間の論文がどう選ばれたかは分からない。第三に、ICLR の評価との関係は相関であり、スロップが評価を下げたことを示すものではない。第四に、390 本の多くは計算機科学で、他分野でどこまで同じ結果になるかは abstract の範囲では示されていない。第五に、検出の正解率は対のどちらかを当てる設定での数字であり、一本の論文だけを渡されたときにどう働くかは別の問題である。
この尺度が、AI を使ったかどうかを判定する道具として使われる危うさにも触れておく。人間が書いた論文でも推論は崩れる。尺度が測っているのは文章の出所ではなく推論の崩れであり、その読み分けを誤ると、書き手への不当な疑いにつながる。
6. 束になっていない一本の論文として読む
この論文は Hugging Face の Daily Papers で 54 の upvote を集め、公開実装には 13 の star が付いている。[2]当サイトの選定で立った signal は読者の票の系統だけで、実装者の star も報道の追随も基準には届いていない。upvote は「読む価値がある」と投じられた票であって、手法の正しさを保証するものではない。
同じ問いを扱う論文の束もできていない。束の大きさは 1 で、収集した論文の中に同じ主題へ寄った論文は見つからなかった。AI が書いた論文や AI による査読の質を問う研究は増えているが、「科学の推論のつながりを測る」という問いが一斉に立ち上がっているとまでは言えない。
それでも取り上げるのは、この論文の結論が、AI に文書を書かせる現場の多くに当てはまる形をしているからである。文章を磨くことと、主張を根拠につなぎ直すことは別の作業だ、という指摘は、論文に限らない。
7. 製薬・規制の現場から見ると
製薬の現場では、治験の報告書、申請資料の概要、学術論文の下書きなどで、AI に文章を書かせる検討が進んでいる。こうした文書で最も問題になるのは、まさにこの論文が言う崩れである。各節はそれらしく読めるのに、有効性の主張が解析結果のどこにも支えられていない、という形の誤りは、規制文書では許されない。
持ち帰れる点は二つある。一つは、AI の下書きを直すときに、文章の流れではなく、主張から元データへのつながりを点検することである。主張ごとに、裏づけとなる表やログを指し示せるかを確かめる工程は、従来の品質管理の考え方とも重なる。もう一つは、点検の尺度を目標にして直させないことである。尺度に合わせて書き換えさせると、尺度の数字だけがよくなる。この論文が報告した報酬ハッキングは、社内の品質指標でも起こりうる。
この論文の評価は主に計算機科学の論文で行われたもので、規制文書で同じ効果が出るかは示されていない。この記事の読みも、プレプリントの abstract の範囲にとどまる。