1. 長期タスクの成果物は、誰がどう確かめるのか
LLM エージェントは、ファイルを読み、道具を使い、何段階もの作業を経て一つの成果物を出すところまで来ている。調査メモ、表の集計、設定ファイルの書き換えといった仕事である。作業が長くなるほど、途中のどこかで要件を取りこぼしたり、根拠のない主張が混ざったりする余地が増える。
短い問題なら、正解と照らし合わせれば済む。しかし実務の長い仕事には、たいてい正解例が無い。採点基準を事前に書き下すのも難しい。著者らが置いた条件はまさにそこで、テスト時に参照解答も採点ルーブリックも使えない場面で、基盤モデルを固定したまま検証を強くできるか、を問うている。[1]
一つの手がかりは、同じタスクを何度も解かせることである。試行(ロールアウト)を重ねると、ある試行は前半を正しく、別の試行は後半を正しく書く、といった具合に、正しい主張が試行ごとに散らばる。問題は、そのうちどれを信じるかを決める仕組みである。一次情報は arXiv に公開されたプレプリントで、査読前の段階にある。
2. 提案の芯は、生成に使ったモデルを「道具を持った検証者」に変えること
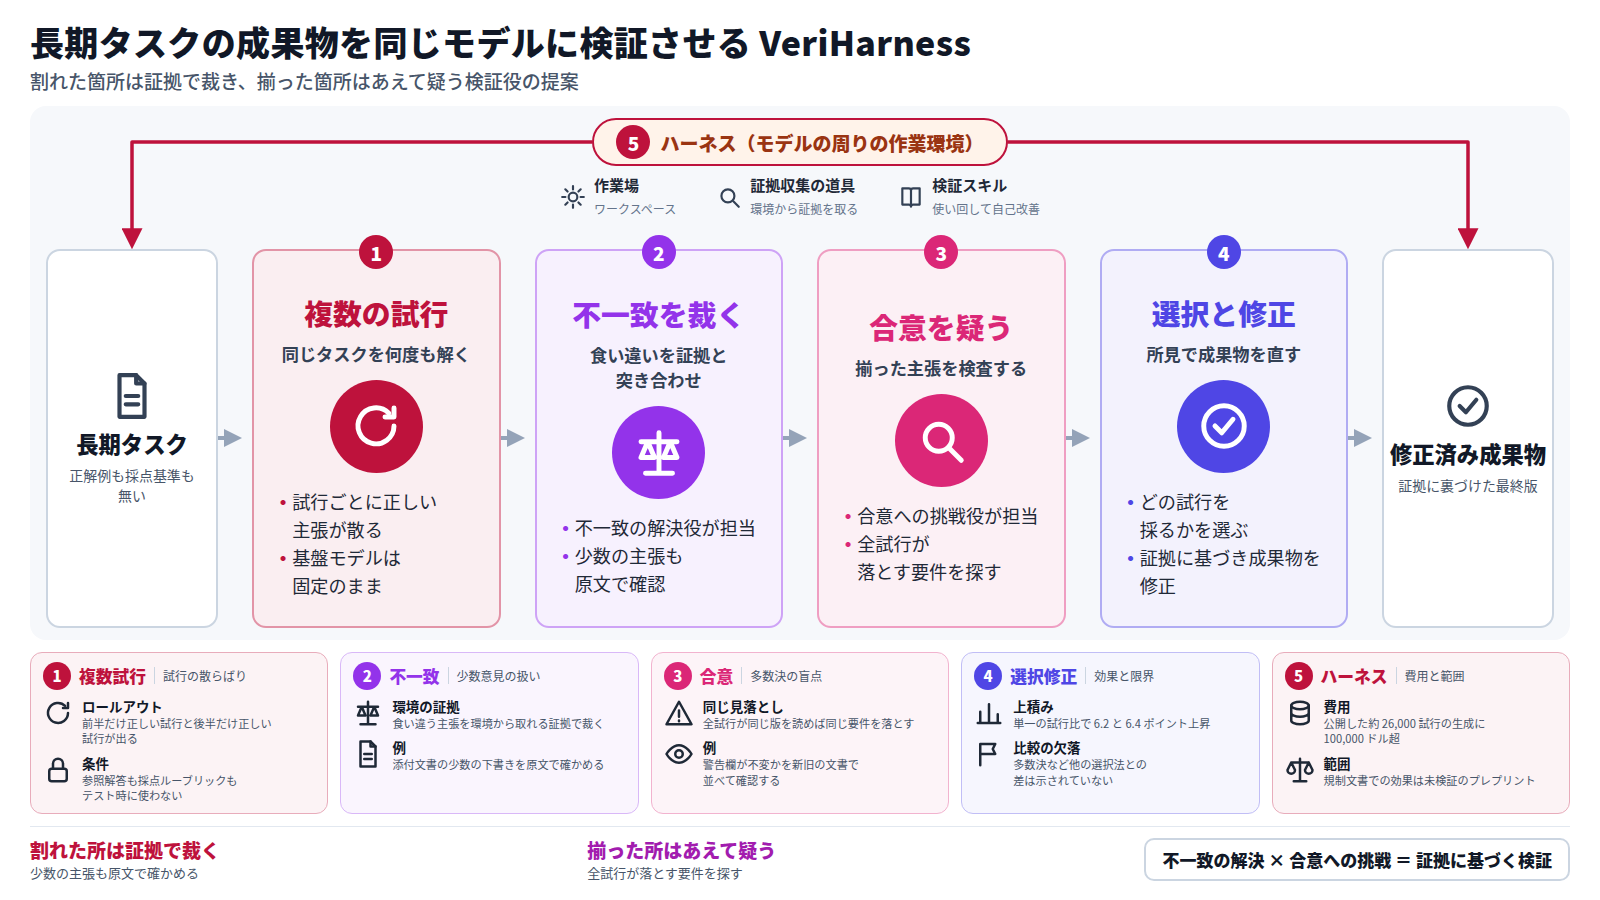
VeriHarness の芯は一つに絞れる。成果物を生成したのと同じ LLM に、作業場(ワークスペース)、証拠を集める道具、使い回せる検証スキルを与え、エージェントとして検証させることである。新しいモデルを学習させるのではなく、モデルの周りの作業環境、つまりハーネスの側で検証力を上げる設計になっている。
この検証者は二つの役に分かれる。一つは不一致の解決役(disagreement resolver)で、試行どうしで主張が食い違う箇所を、環境から取れる証拠と突き合わせて裁く。もう一つは合意への挑戦役(consensus challenger)で、試行が揃って同じことを言っている箇所をあえて検査し、どの試行も落としている要件が無いかを探す。
二つの役の所見は、最終的な成果物の選択と修正に使われる。どの試行を採るかを選ぶだけでなく、証拠に裏づけられた形で成果物を直すところまでが一つの流れである。
3. abstract の範囲で示されたこと
出発点となった観察は二つある。食い違いはしばしば正しい別解を露わにすること、そして合意は誤りを隠しうることである。多数決で揃った答えを正しいとみなす素朴な方法では、全員が同じ見落としをしている箇所を拾えない、という指摘になる。
評価は、長期タスクのワークスペース型ベンチマーク五つと、最前線のモデル二つで行われた。著者らによれば、VeriHarness は比較したベースラインの中で最も高い選択スコアを示した。証拠に基づく修正を加えると平均性能はさらに上がり、単一の試行に対する上積みは、Gemini 3.5 Flash で 6.2 ポイント、Claude Opus 4.8 で 6.4 ポイントになったという。
加えて、検証スキルは失敗からのフィードバックで自己改善できたと報告されている。著者らは、五つのベンチマークと二つのモデルにわたる約 26,000 件の試行をすべて公開しており、その生成には 100,000 ドルを超える費用がかかったと書いている。実装は GitHub で公開されている。[3]
4. 具体例で見る ── 複数の下書きから、規制文書の要約を一本にまとめる
エージェントに、ある製品の添付文書改訂の要点を社内向けにまとめさせる場面を考える。同じ依頼で何本か下書きを出させたところ、内容がほぼ揃った。
担当者:下書きはどれも同じ結論です。改訂は用量の記載だけで、警告欄は変わっていない、と。揃っているので、これで確定してよさそうです。
レビュー担当:揃っていることは安心材料になりません。全員が同じ版の旧文書を読んでいれば、同じ見落としをします。警告欄が本当に変わっていないか、新旧の文書を並べて確かめましたか。
担当者:確かめていません。逆に、一本だけ「相互作用の項にも追記がある」と書いた下書きがありました。少数なので外していました。
レビュー担当:その一本こそ、原文に当たって白黒をつける対象です。割れているところは証拠で裁き、揃っているところは揃っているからこそ疑う。順番はそれでいきましょう。
この会話の二つの動きが、論文の二つの役にあたる。少数意見を原文で確かめるのが不一致の解決役、揃った結論を疑い、落ちている要件を探すのが合意への挑戦役である。どちらも、多数決ではなく証拠で判断するという点で共通している。
5. 新しくない部分と、abstract から読み取れない限界
同じ問題を複数回解かせて答えを選ぶ考え方は新しくない。多数決で答えを決める方法や、別の採点モデルで最良の試行を選ぶ方法は、広く使われてきた。道具を持たせて主張を裏取りさせる発想も、エージェント研究では珍しくない。この論文の寄与は、合意を疑う役を明示的に置いたことと、それを長期タスクの検証に組み込んだ点にある、と読める。
限界も多い。第一に、五つのベンチマークがどういう課題で、何を「選択スコア」として測ったのかは、abstract には書かれていない。第二に、上積みの数値は単一の試行との比較であり、多数決や他の選択法と比べてどれだけ差があるかは、abstract の範囲では示されていない。第三に、検証のために何度も試行を回し、さらに検証役を動かす費用は小さくない。公開された試行の生成だけで 100,000 ドルを超えたという記述は、手法の重さを測る一つの目安になる。第四に、検証スキルの自己改善が、どの程度の失敗例で、どこまで汎化したのかは分からない。
また、abstract の結びでは自らの手法を「novel and critical」と形容しているが、これは著者らの評価である。新規性や重要性は、査読と追試を経て判断されるべきものである。
6. この主題が、いま束になっている理由
この論文は Hugging Face の Daily Papers で 48 の upvote を集め、公開実装には 39 の star が付いている。[2]当サイトの選定では、読者の票、実装者の star、同じ主題の論文の束という三つの系統が立った。ただし upvote や star は話題性の目安であって、手法の正しさを保証するものではない。
束の大きさは 2 である。同じ時期に出た論文として、チップ設計の検証作業をエージェントで自動化するための基盤を見直す研究がある。[4]領域は違うが、「エージェントが出した結果を、何を根拠に信じるか」という問いが、汎用の長期タスクと半導体の検証という別々の現場で同時に立っている。
束をつくるキーワードには、検証、長期タスク、スケーリング、基盤の再設計が並ぶ。エージェントに任せる仕事が長くなるにつれ、生成の性能よりも検証の仕組みが論点になりつつある、という流れの中に置ける。とはいえ束は二本であり、大きな潮流と言い切れる厚みではない。
7. 製薬・規制の現場から見ると
製薬の文書業務では、AI に下書きを複数出させて比べる使い方が始まりつつある。そのとき陥りやすいのが、「どの下書きも同じことを言っているから正しい」という判断である。この論文の観察は、その判断に疑問を投げる。同じ資料を読み、同じ前提で書いた下書きは、同じ箇所を同じように落とす。
持ち帰れる点は二つある。一つは、答えが割れた箇所を、少数だからと捨てずに原文で確かめることである。少数の主張が正しい別解を含んでいる場合がある。もう一つは、答えが揃った箇所にも、落ちている要件が無いかを点検する工程を置くことである。規制文書の確認手順に、合意そのものを検査する項目を入れるのは、AI を使うかどうかにかかわらず意味がある。
一方で、この論文の評価はワークスペース型のベンチマークで行われたもので、規制文書の審査で同じ効果が出るかは示されていない。手法も検証のたびに多くの試行を要する。導入を検討するなら、まず自社の文書で、検証役が何を拾い、何を拾えなかったかを記録するところから始めるのが筋になる。この記事の読みも、プレプリントの abstract の範囲にとどまる。