1. 実務のファイルを扱えるエージェントを、何で鍛えるか
LLM エージェントに期待される仕事は、質問に答えることから、実際の業務をこなすことへ移りつつある。表計算のファイルを読み、報告書の PDF を参照し、複数の道具を使い分けて、最後に成果物を作る。著者らはこうしたエージェントを「working agents」と呼んでいる。
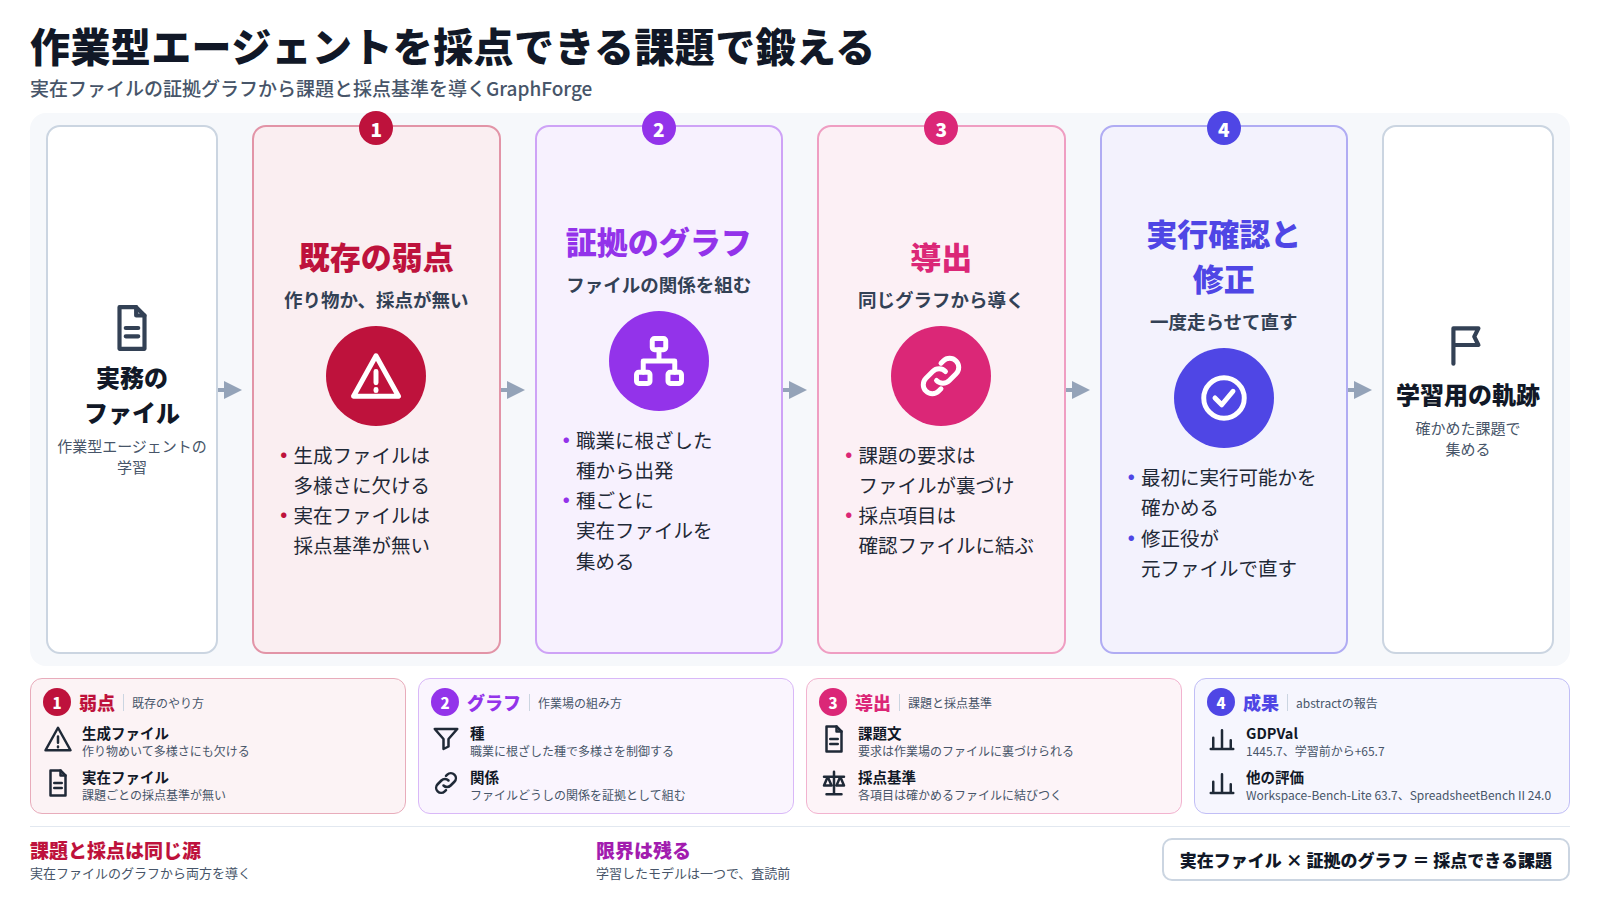
このようなエージェントを学習させるには、本物らしい多様なファイルの上に組まれ、結果が正しいかを確かめられる課題が大量に要る。ところが、そうしたデータを作る仕組みはまだ少ない、と著者らは指摘する。既存のやり方には二つの弱点がある。一つは、課題用のファイルそのものをモデルに作らせる方法で、ファイルが作り物めいて多様さにも欠ける。もう一つは、実在のファイルの上に課題を組む方法で、こちらは課題ごとの採点基準が無く、エージェントの成果物の質を確かめられないまま残る。[1]
この論文は、実在のファイルを使いながら、課題と採点の両方をそのファイルに結びつけるデータ合成の枠組みを提案した。一次情報は arXiv に公開されたプレプリントで、査読前の段階にある。
2. 提案の芯は、課題と採点基準を同じ「証拠のグラフ」から作ること
GraphForge の芯を一つに絞ると、作業場に集めた実在のファイルどうしの関係を証拠のグラフとして組み、課題文と採点基準の両方をそのグラフから導くことである。
手順はこうなる。まず、職業に根ざした種(シード)から出発し、多様さを制御する。種ごとに実在のファイルを集めて作業場を組み、ファイルどうしの関係について証拠のグラフを作る。課題文と採点基準(ルーブリック)はどちらもこのグラフから導かれるので、課題の要求は作業場のファイルに裏づけられ、採点の各項目は、それを確かめるのに必要なファイルに結びつけられる。
さらに、最初に一度エージェントを走らせて、課題が実行可能かを確かめる。問題があれば、修正役のエージェントが元のファイルに照らして課題と採点基準を直す。そのあとで学習用の作業の軌跡を集める。データを作る段階に、確かめる工程と直す工程を組み込んでいる点が特徴である。
3. abstract の範囲で示されたこと
著者らは Qwen3.6-27B を、GraphForge で作った 2,169 本の軌跡で追加学習させた。その結果、OpenHands の上で動かした GDPVal の値が 1445.7 となり、学習前から +65.7 上がった、と報告している。[3][5]Claude Code の上で動かした Workspace-Bench-Lite では 63.7(+7.7)、SpreadsheetBench II では 24.0(+13.7)だったという。[4]
加えて、追加学習したモデル自身に何度か解かせ、その候補を証拠に結びついた採点基準で選び、選んだものでもう一度学習させる方法(rejection fine-tuning)を試した。この方法で三つのベンチマークすべてがさらに上がったとされ、著者らはこれを、採点基準が良い候補を選ぶ手がかりとして役立つことを示すものだと述べている。
データとモデルは公開されている、と abstract には書かれている。ただし arXiv のページ上では、公開先へのリンクは確認できなかった。
4. 具体例で見る ── 添付文書の改訂に合わせて、資材の修正箇所を洗い出す
製薬の現場の業務を一つ、学習用の課題に仕立てる場面を考える。添付文書が改訂され、それに合わせて既存の説明資材のどこを直すべきかを洗い出し、修正箇所の一覧を作る仕事である。
ファイルをモデルに作らせる型
改訂前後の添付文書も、説明資材も、モデルが作る。体裁は整うが、実際の文書に特有の書き方の癖、表の崩れ、版の違う資料の混在といった面倒さが入りにくい。採点も「一覧が作れたか」程度にとどまり、挙げた箇所が本当に改訂に対応しているかは確かめにくい。
実在のファイルと証拠のグラフで組む型
実在の文書を作業場に置き、「この資材のこの記載は、改訂された添付文書のこの項目に対応する」という関係をグラフとして組む。課題文はその関係から作られ、採点の各項目には「どのファイルのどこを見れば確かめられるか」が結びつく。エージェントが挙げた修正箇所が、根拠のファイルに照らして正しいかを項目ごとに確かめられる。
右の型の考え方は、採点の基準を、元の資料に戻って確かめられる形で持つという点で、人が行う照合の作業に近い。ただしこれは学習用データの作り方の話であり、こうして学習したエージェントが実務で正しく修正箇所を挙げるかは、別に確かめる必要がある。
5. 新しくない部分と、abstract から読み取れない限界
職業に根ざした実務的な課題でモデルを評価する考え方は、GDPval のような評価の取り組みで先に示されている。[3]表計算の実務操作を問うベンチマークもある。[4]採点基準で候補を選んで学習し直す方法も、それ自体は既知の手法である。この論文の寄与は、実在のファイルから課題と採点基準を同じグラフで導き、採点の各項目をファイルに結びつけた点にある、と読める。
限界はいくつもある。第一に、学習させたモデルは一つで、他の大きさや系統のモデルで同じ効果が出るかは abstract からは分からない。第二に、GDPVal の値がどのような尺度で、上がり幅がどの程度の意味を持つのかは abstract には説明が無い。第三に、Workspace-Bench-Lite と SpreadsheetBench II の上がり幅は示されているが、他の学習データで同じ量を学習させた場合との比較があるかは書かれていない。第四に、採点基準を作る仕組みと、その採点基準で候補を選ぶ仕組みが同じ枠組みの中にあるので、採点基準の偏りがそのまま学習に入り込むおそれがある。第五に、実在のファイルをどこから集め、権利や個人情報をどう扱ったかも abstract の範囲では示されていない。
6. この論文がいま目に留まった理由と、束になっていないこと
この論文は Hugging Face の Daily Papers で 144 の upvote を集めた。[2]本日選定した三本の中では最も多いが、upvote は読者が「読む価値がある」と投じた票であり、論文の主張が正しいことや、手法が優れていることを示す数ではない。
当サイトの選定では、この論文に立った signal は読者の票の系統だけだった。収集時点では公開リポジトリが登録されておらず、star は 0 で、報道の追随も確認されていない。同じ問いを扱う論文の束もできておらず、束の大きさは 1 である。
エージェントの学習データをどう作るかという問いは、当サイトでもここ数日、エージェントの課題作成や行動の検証を扱った論文で繰り返し出てきている。ただし、それらはこの論文と同じ束には入っていない。主題が一斉に動いていると言える段階ではなく、近い問いを持つ論文が別々に出ている、と見るのが正確である。
7. 製薬・規制の現場から見ると
製薬の現場の文書業務は、この論文の言う working agents が対象にする仕事そのものに近い。添付文書、試験報告書、資材、社内手順書といった多種類のファイルを読み合わせ、決まった形の成果物を作る。そこに使うエージェントを鍛えたり評価したりするとき、この論文の発想から借りられる点がある。
一つは、採点基準の各項目を、確かめに使う元の資料に結びつけておくことである。エージェントの出力を評価するとき、「良さそうに見えるか」ではなく「どの資料のどこに照らして正しいか」で判定できれば、評価の根拠が監査の場でも説明できる。もう一つは、課題を作った段階で一度走らせ、実行できない課題を直してから使うという手順で、評価用の課題集を社内で作るときにもそのまま当てはまる。
一方で、実在の社内文書を学習データに使うことには、機密や個人情報の扱いという別の問題が伴う。この論文が公開データとしてどのようなファイルを使ったかは abstract からは分からないので、社内での応用を考える際は、その点を先に確かめる必要がある。この論文はプレプリントであり、ここで述べた効果は製薬の文書業務では確かめられていない。