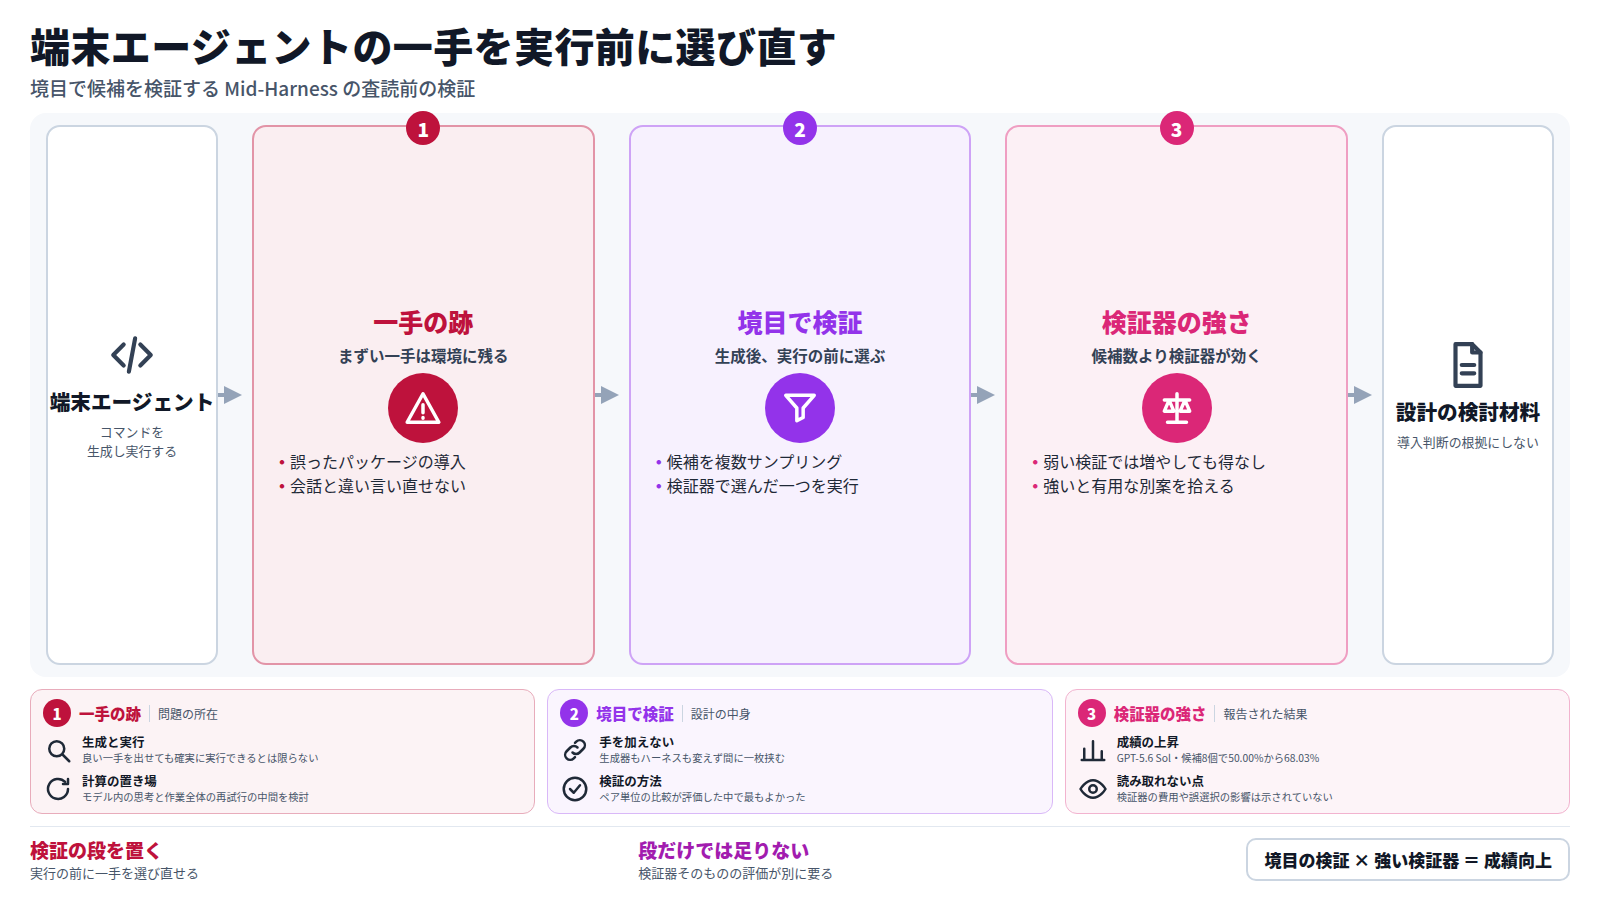
1. 一手のまずさが、その後の全部を左右する
端末エージェントは、シェルのコマンドを生成して実行し、その出力を読んで次のコマンドを決める。モデルの生成には確率的なゆらぎがあるので、同じ場面でも出てくるコマンドは毎回少しずつ違う。
著者らが問題にしているのは、役に立つ行動を生成できる力と、それを確実に実行できることは別だという点である。abstract では、間違ったパッケージのインストールが例に挙がっている。まずいコマンドは環境そのものを書き換えるので、モデルがもっとよい別案を出せたとしても、その後の進行が妨げられる。会話の応答なら次の発言で言い直せるが、端末の操作は環境に跡を残す。[1]
そこで著者らは、推論時の計算をどこに割り当てるかを問い直す。これまでの主な割り当て先は、モデルの中で長く考えさせることか、作業全体を何度もやり直して最もよい結果を選ぶことだった。この論文は、その中間にあたる一手ごとの選び直しに計算を割くことを検討している。一次情報は arXiv に公開されたプレプリントで、査読前の段階にある。
2. 提案の芯は、境目で候補を検証してから実行すること
Mid-Harness の芯は一つに絞れる。モデルが行動を生成してからハーネスが実行するまでのあいだに、行動の候補を複数サンプリングし、検証器で選んだ一つだけを実行に回すことである。
このとき、行動を生成するモデル(生成器)にも、コマンドを実行する仕組み(ハーネス)にも手を加えない。間に一枚挟むだけなので、既存のエージェントの構成を変えずに試せる、という設計になっている。
検証の方法は一つではない。abstract では、外部の強いモデルを検証器に使う場合と、生成器と同じモデルを検証器として使う場合が比べられている。後者では、候補を二つずつ比べるペア単位の検証が、評価した検証の方法の中で最もよかったとされる。さらに、強い検証器の応答を同じモデルに蒸留すると、生成器はそのままで成績が上がったという。
3. abstract の範囲で示されたこと
TMAX-9B を生成器に使った場合、検証が弱いと、行動のサンプリングを増やしてもほとんど得がなかった。一方、力のある検証器を使うと、同じ生成器が出した有用な別案を拾えるようになった、と著者らは報告している。
具体的な数値は一つ示されている。TerminalBench-Lite で、GPT-5.6 Sol を検証器にし、行動を 8 個サンプリングすると、Pass@1 は元のエージェントの 50.00% から 68.03% に上がった。Pass@1 は、一回の試行で課題を解けた割合である。
もう一つの主張は費用に関するものである。TMAX-9B で、行動の選び直しと作業全体のやり直しを組み合わせると、作業全体のやり直しだけを増やすよりも、推定したトークン費用が少ないまま高い成功率に届いたという。Mid-Harness はほかのモデル、ベンチマーク、ハーネスでも成績を上げたとされるが、その名前と数値は abstract には書かれていない。
4. 具体例で見る ── 解析環境の準備をエージェントに任せた場合
統計解析の作業環境を新しく用意し、必要なライブラリを入れて、手元の解析スクリプトが動くところまでをエージェントに任せる場面を考える。
元のエージェントの場合
エージェント: 必要なライブラリを入れます。(名前の似た別のパッケージを入れるコマンドを生成し、そのまま実行する)
エージェント: スクリプトが動きません。依存関係を直します。(入れたパッケージが別のライブラリの版を書き換えていて、直すたびに別の箇所が壊れる)
Mid-Harness を挟んだ場合
エージェント: インストールのコマンドを複数案生成します。
検証器: 案を比べると、一つは名前の似た別パッケージを指している。目的のライブラリを指す案を実行に回す。
エージェント: 指定した案を実行しました。スクリプトの実行に進みます。
この例で見ておきたいのは、生成器の力は変わっていないことである。正しいコマンドは、元のエージェントでも候補の中に出うる。違いは、どの候補を環境に触れさせるかを、実行の前に決めているかどうかにある。そして abstract の結果が示すとおり、その決め方が弱ければ、候補を増やしても得にならない。
5. 新しくない部分と、abstract から読み取れない限界
候補を複数生成して検証器で選ぶ考え方自体は新しくない。数学の文章題で、解答を多数生成して検証器に選ばせると成績が上がることは、以前から示されている。[4]推論と行動を交互に行うエージェントの基本形も、ReAct などで先に確立した枠組みである。[5]この論文の寄与は、その選び方を作業の単位ではなく一手の単位で、しかもモデルとハーネスの境目に置いて、何が効くかを調べた点にある、と読める。
限界もある。第一に、TerminalBench-Lite の課題の数と構成は abstract に書かれていない。名前は端末作業の評価基準 Terminal-Bench と近いが[3]、両者の関係は abstract からは確かめられない。第二に、最も大きな改善は外部の強いモデルを検証器にした場合のもので、検証器そのものの費用は「推定したトークン費用」の比較にどこまで含まれているのか、abstract からは読み取れない。第三に、検証器が誤った候補を選んだときに何が起きるか、たとえば取り返しのつかない操作を通してしまう割合は示されていない。第四に、実装リポジトリは収集の時点で登録されていない。
論文共有の場での支持票は 111、コメントは 5 で、GitHub のスターは 0 である。[2]支持票は読まれた程度を示すが、主張の正しさを示すものではない。第三者による再現も見当たらない。
6. この主題が今なぜ注目されているか ── 束になっていない一本として
今回の収集では、この論文は束の大きさが 1 で、立った系統は支持票の一つだけだった。つまり、同じ問いを扱う独立した論文が同時に現れた状態ではなく、一本の論文が票を集めた状態である。この記事は、その条件のもとで選ばれた一本として読んでほしい。
それでも、特徴語の並び(行動、ハーネス、スケーリング、端末)には、最近の流れが表れている。当サイトでもここ最近、エージェントを包むハーネスの設計や自己改善を扱うプレプリントを続けて取り上げてきた。推論時の計算をモデルの内側で使うか、作業全体の繰り返しに使うか、という二択に、ハーネスとの境目という第三の置き場所を加えたのがこの論文である。
同じ日に選ばれた他の二本も、長い作業の途中でエージェントが何を拠り所に次の手を決めるかを扱っている。ただし三本は互いに引用し合う束ではなく、偶然同じ時期に出た別々の論文である。
7. 製薬・規制の現場から見ると何が接続するか
一つ目の接点は、操作の前に確認を挟むという考え方そのものである。製薬の現場では、システムに変更を加える前に、承認された手順と照らして確認する段取りが当たり前に置かれている。Mid-Harness は、エージェントの一手ごとにそれに近い段を挟む。人の確認に置き換わるものではないが、エージェントを業務環境に入れるときに、どの操作の前に検証を置くかを設計する材料になる。
二つ目は、検証器の記録である。どの候補が出て、どれが選ばれ、なぜ他が退けられたかが残れば、後から操作の経緯を追える。記録の範囲は abstract には書かれていないので、使う側で残す仕組みを用意する必要がある。
三つ目は、検証器の質への依存である。この論文の範囲では、弱い検証器のもとでは候補を増やしても得がなかった。検証の段を置いたこと自体を安全の根拠にはできず、検証器そのものの評価が別に要る。査読前の段階の研究であることも踏まえ、この結果は、取り返しのつかない操作を含む業務への導入を判断する根拠としてではなく、設計の検討材料として扱うのが妥当である。