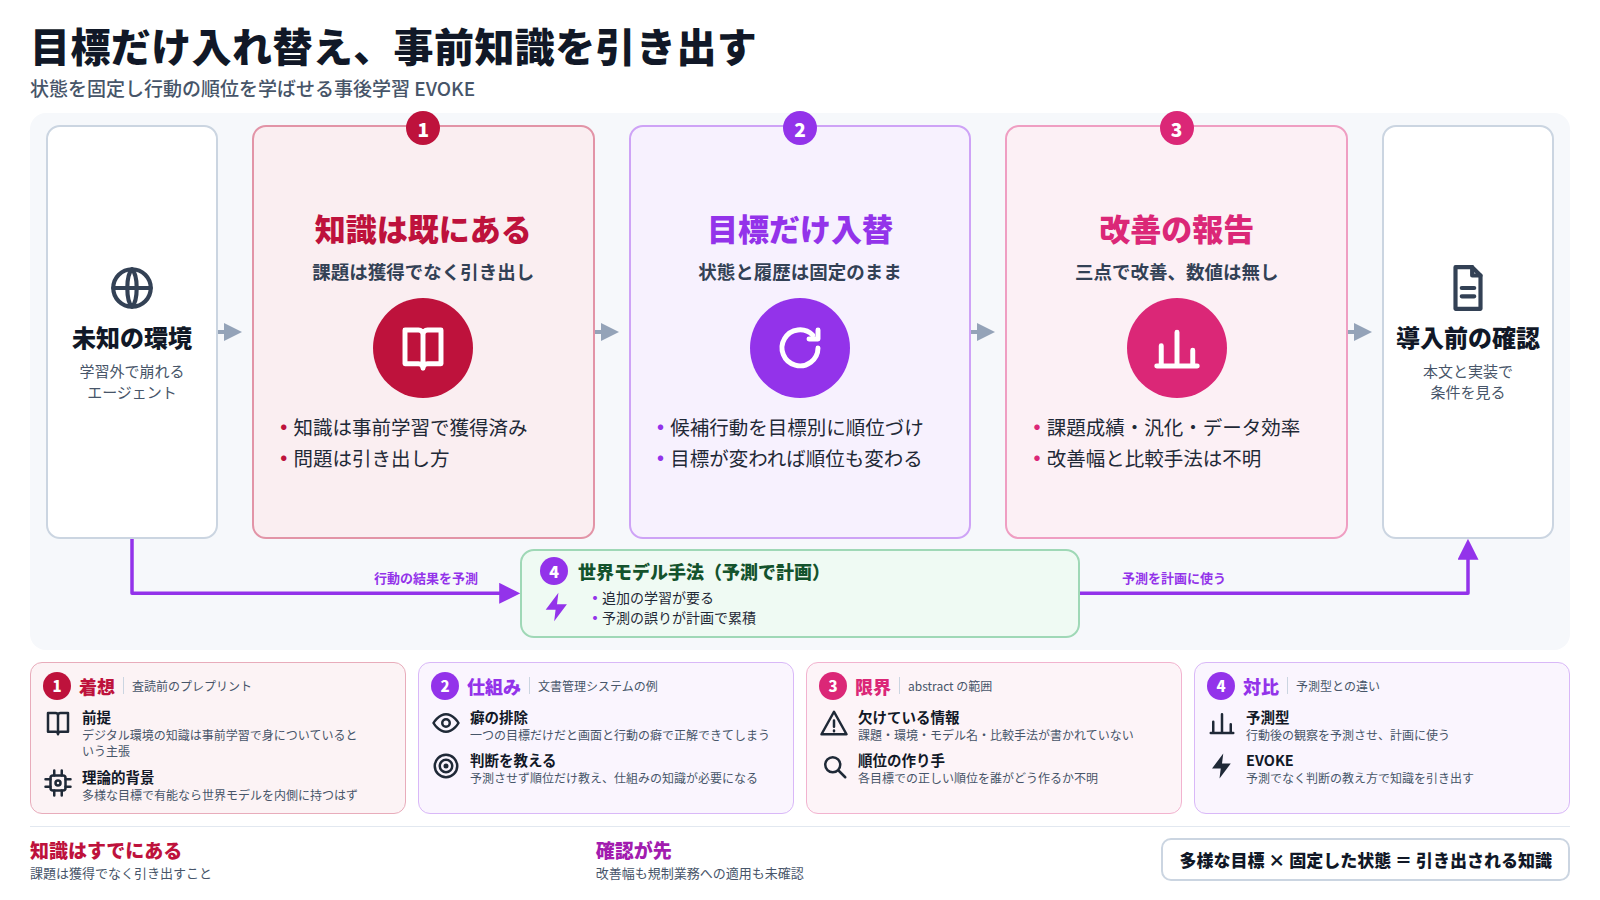
1. 学習した環境では動けても、外に出ると崩れる
LLM をエージェントとして使い、画面を操作したりウェブを巡ったりして、何段階もの判断を重ねる仕事をさせる場面が増えている。著者らが問題にしているのは、こうしたエージェントが見たことのない環境にうまく移れない点である。[1]
これに対する一つの答えが、世界モデルの手法だった。行動したら次に何が見えるかを予測するようエージェントを学習させ、その予測を計画に使う。ただし追加の学習が要り、予測の誤りは計画の中で積み重なっていく。
著者らはここで問いの向きを変える。デジタル環境で動く LLM エージェントの場合、そうした世界の知識の多くは事前学習のあいだにすでに身についている。だとすれば、課題は知識を獲得することではなく、引き出すことにある、という主張である。一次情報は arXiv に公開されたプレプリントで、査読前の段階にある。
2. 提案の芯は、状態を固定して目標だけを変えること
著者らの見立てでは、ふつうの事後学習は知識を引き出す圧力をほとんどかけていない。ある状態では一つの目標のもとで正しい行動を教えるだけなので、方策は、その文脈でよく出てくる行動をなぞる表面的な癖に頼っても正解できてしまう。
EVOKE の芯は一つに絞れる。環境の状態とやりとりの履歴を固定したまま、目標だけを入れ替え、同じ候補行動を目標ごとに順位づけさせることである。目標が変われば、どの行動がよいかの順位も変わる。文脈の癖や、一つの目標との相関だけに頼る方策では、この順位を正しく並べられない。
この設計の背景には理論がある。さまざまな目標で有能に振る舞えるエージェントは、その行動の好みから取り出せる形で世界モデルを内側に持っているはずだ、という主張である。EVOKE は世界を予測させる代わりに、判断そのものを教えることで、方策が事前学習で持っている世界の知識を判断に使うよう、間接的に促す。
3. abstract の範囲で示されたこと
EVOKE は、三種類のバックボーンで、さまざまな課題にわたって評価された。著者らは、課題の成績、見たことのない環境への汎化、データ効率の三つが改善したと報告している。
加えて、何がこの改善をもたらしているかを調べるための、条件を統制した分析も行ったとされる。
ただし、abstract には改善の幅を示す数値が一つも書かれていない。どの課題で、どのモデルを使い、どの手法と比べたのかも示されていない。このため、abstract の範囲で言えるのは「著者らは三つの点で改善を報告している」までであり、改善がどの程度の大きさなのかは確かめられない。
4. 具体例で見る ── 社内システムの同じ画面で、目標だけが違う場合
文書管理システムの、ある文書の詳細画面を開いた状態を考える。画面に出ている選択肢は、版の履歴を開く、承認の依頼を出す、文書を別名で複製する、検索に戻る、の四つだとする。
一つの目標だけで学習した場合
学習データでは、この画面に来たときは「承認の依頼を出す」が正解である例がほとんどだった。エージェントは、画面の様子と「承認の依頼」の組を癖として覚える。目標が「前の版と何が変わったかを確かめる」に変わっても、同じ画面ではまず承認の依頼を出そうとする。
EVOKE の考え方で学習した場合
同じ画面、同じ履歴のまま、目標を「承認を依頼する」「前の版との違いを確かめる」「別の文書を探す」と入れ替え、四つの選択肢の順位をそれぞれつけ直させる。画面の様子だけでは順位を当てられないので、エージェントは「版の履歴を開くと何が見えるか」といった、システムの仕組みについての知識を判断に使うよう促される。
この比較で見ておきたいのは、右の学習ではシステムの動きを予測させていないことである。教えているのは判断の順位だけで、仕組みについての知識は、順位を正しく並べるために必要になるから使われる、という設計になっている。
5. 新しくない部分と、abstract から読み取れない限界
さまざまな目標に対応できるエージェントは世界モデルを内側に持つ、という考え方は、この論文が初めて出したものではない。目標に条件づけられた課題をこなすエージェントは、その方策から環境の予測モデルを取り出せる形で持っていなければならない、という趣旨の主張は先行研究で示されている。[4]EVOKE の abstract は根拠とした理論の出典を名指ししていないが、この方向の議論を学習の手続きに落とし込んだのが寄与だと読める。目標を入れ替えてデータを増やす工夫も、強化学習の分野では以前から使われてきた。
限界は大きい。第一に、すでに述べたとおり、abstract には改善の大きさを示す数値がない。第二に、課題、環境、三種類のバックボーンの名前、比較した手法が書かれていない。第三に、同じ状態で目標を入れ替えるには、各目標のもとでの正しい順位が必要になるが、その順位を誰がどう作るのか、費用はどれほどかが abstract からは分からない。第四に、「事前学習で知識はすでに身についている」という前提は、デジタル環境を対象にした主張であり、事前学習で触れる機会の少ない専用システムにも当てはまるかは、abstract の範囲では示されていない。
実装はリポジトリとして公開されている。[2]論文共有の場での支持票は 69、コメントは 3、GitHub のスターは 6 である。[3]どれも話題の大きさの目安であり、主張の正しさを示すものではない。第三者による再現も見当たらない。
6. この主題が今なぜ注目されているか ── 束になっていない一本として
今回の収集では、この論文は束の大きさが 1 で、立った系統は支持票の一つだけだった。同じ問いを扱う独立した論文が同時に現れた状態ではなく、一本の論文が票を集めた状態である。この記事は、その条件のもとで選ばれた一本として読んでほしい。
特徴語には、エージェント、意思決定、引き出す、移せる、世界、知識が並ぶ。ここ最近、世界モデルをエージェントに持たせる研究は、未来の観察を予測させる方向で進んできた。この論文は、予測を学ばせるのではなく、すでに持っている知識を判断の教え方で引き出すという、反対側からの答えを示している点で目を引く。
同じ日に選ばれた他の二本は、推論時の文脈管理と、一手ごとの検証を扱っている。どれも、長い作業や見慣れない場面でエージェントが何を拠り所に判断するかを問うが、互いに引用し合う束ではない。
7. 製薬・規制の現場から見ると何が接続するか
一つ目の接点は、学習した環境の外での振る舞いである。製薬の現場で使うシステムは、社内の専用システムや、版が上がって画面の変わったシステムが多い。エージェントを導入するときに最も気になるのは、評価した環境と本番の環境がずれたときにどう振る舞うかである。EVOKE はこの問題を正面から扱っているが、abstract には改善の大きさが書かれていない。導入の根拠として使うには、本文と実装で条件を確かめる必要がある。
二つ目は、評価の作り方である。同じ画面で目標だけを変えたときに、エージェントの選ぶ行動が正しく変わるかを見る、という発想は、学習の方法としてだけでなく、評価の方法としても使える。目標を入れ替えても同じ行動を選び続けるなら、そのエージェントは場面の癖で動いている疑いがある。
三つ目は、「知識はすでにある」という前提の扱いである。一般向けのウェブやアプリについては成り立つかもしれないが、規制業務の手順や社内の取り決めは、事前学習でほとんど触れられていない可能性が高い。査読前の段階の研究であることも含め、この前提をそのまま業務の環境に持ち込むことはできない。