1. 長い調査レポートを AI に書かせると、どこで崩れるか
Web や文献を調べて、根拠付きの長いレポートにまとめる。この「deep research」と呼ばれる使い方は、LLM の用途として定着しつつある。ただし、レポートが長く、調べる範囲が広くなるほど、一つのモデルが一つの文脈の中で計画も調査も執筆も抱える形は無理が出やすい。
よくある崩れ方は二つある。一つは、調べているうちに当初の計画がぼやけ、節ごとの深さや観点がばらつくこと。もう一つは、直したい箇所が一部なのに、レポート全体を何度も書き直してしまい、良かった部分まで変わってしまうことである。
この技術報告は、Meituan の LongCat チームが、自社の LongCat モデルを強化したうえで多エージェントの作業手順と組み合わせた deep research システムを報告したものである。一次情報は arXiv に公開されたプレプリントで、査読前の段階にある。技術報告という性格上、開発元自身による評価である点も、読むときに意識しておきたい。[1]
2. 提案の芯は、全体の計画と節ごとの調査を切り離すこと
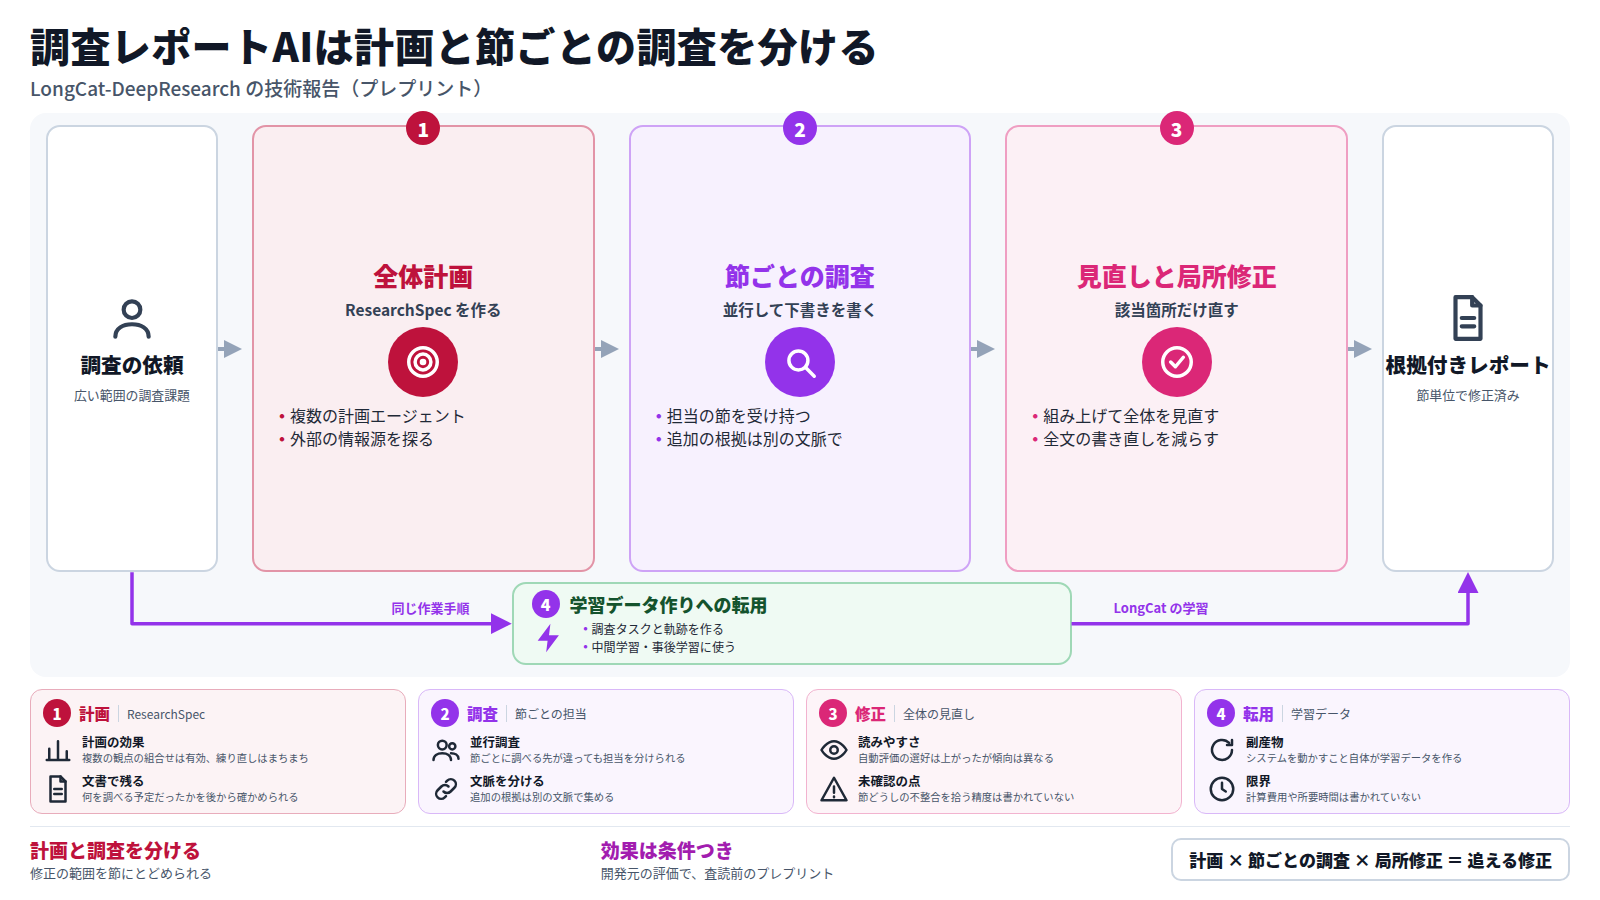
手法の芯を一つに絞ると、レポート全体の計画と、節ごとの詳しい調査を別々の役割に分け、修正も節単位で行うという設計である。
流れは三段に分かれる。まず複数の計画エージェントが外部の情報源を探り、実行できる形の調査計画を練り上げる。著者らはこれを ResearchSpec と呼んでいる。次に、調査エージェントがそれぞれ担当の節を受け持ち、並行して調べて下書きを書く。調べを進める中で追加の根拠が必要になれば、それぞれ別の文脈で集める。最後に、組み上がったレポートを全体として見直し、その結果に基づいて該当箇所だけを直す。これにより、レポート全体を繰り返し書き直すことへの依存を減らす、とされている。
もう一つの使い道として、著者らはこの作業手順を、汎用モデルの中間学習・事後学習に使う調査タスクと作業の軌跡を作るためにも使っている、と書いている。システムを動かすこと自体が、次の学習データを作る仕組みにもなっている。
3. abstract の範囲で示されたこと
公開ベンチマークでは、DeepResearchBench で 55.25、DeepResearchBench II で 51.35、ResearchRubrics で 79.83 と報告されている。社内のベンチマークでは 76.04 で、比べた四つのシステムの中で二番目だったという。[4]
開発用データでの分析では、複数の計画の観点を組み合わせることに効果が見られた一方、計画をさらに練り直すことの効果はまちまちだった、と著者らは書いている。また、最後の編集を加えると、二つのベンチマークで自動評価による読みやすさの選好が平均では上がったが、その傾向はベンチマークごとに異なった、とされる。
ここで目を留めておきたいのは、著者ら自身が「まちまち」「傾向が異なる」と書いている部分である。技術報告は良い結果を前に出しがちだが、この abstract は効かなかった部分にも触れている。どの工夫が、どの条件で効いたのかを分けて読む必要がある。
4. 具体例で見る ── ある疾患領域の公開情報を整理するレポート
ある疾患領域について、治療の選択肢、主要な臨床試験の公開結果、各国の規制当局の動きを一本のレポートにまとめる作業を考える。範囲が広く、節ごとに調べる先がまったく違う。
一つの文脈で全部を書く型
モデルが一つの流れの中で調べ、書き、最後に全体を見直す。規制当局の節に誤りが見つかると、直すためにレポート全体を書き直すことになり、問題の無かった臨床試験の節の言い回しや引用まで変わってしまう。どこが変わったのかを人が追うのも難しい。
計画と節ごとの調査を分ける型
最初に、どの節で何を調べ、どの観点で書くかを調査計画として書き出す。節ごとに別の担当が調べて下書きし、全体の見直しで規制当局の節に誤りが見つかれば、その節だけを直す。調査計画が文書として残るので、何を調べる予定だったかを後から確かめられる。
右の型の利点は、成果物の正しさそのものより、どこを、なぜ直したかが追える点にある。ただし、節どうしで同じ試験を別の言い方で紹介する、といった不整合は、全体の見直しで拾えるかどうかに依存する。その拾い方の精度は abstract には書かれていない。
5. 新しくない部分と、abstract から読み取れない限界
先に計画を立て、観点ごとに調べてから長い文章を組み立てる、という発想自体は新しくない。Wikipedia 風の記事を一から書かせる研究でも、複数の観点から質問を立てて下調べし、アウトラインを作ってから書く手順がすでに示されている。[5]多エージェントで役割を分ける構成も広く使われている。この報告の特徴は、それらを節単位の並行調査と局所修正にまとめ、さらに学習データの生成にもつなげた点にある、と読める。
限界も多い。第一に、公開ベンチマークの値は報告されているが、比較相手のシステム名と、その値との差は abstract に書かれていない。第二に、社内ベンチマークでは比べた中で二番目であり、最上位ではない。社内ベンチマークの中身は外部から確かめられない。第三に、読みやすさは自動評価による選好で測られており、人が読んで分かりやすいかとは別の指標である。第四に、「根拠付き」とうたうレポートで、引用した根拠が本当に主張を支えているかを、どう検証したのかは abstract の範囲では示されていない。第五に、計算費用や所要時間も書かれていない。
公開されているリポジトリは、言語モデル・Web 検索・ページ取得を利用者側で接続する作業手順の枠組みとして提供されており、出力には人の確認が必要だと明記している。[2]報告の数値は強化した LongCat モデルとの組み合わせでのものなので、別のモデルをつないで同じ結果が出るとは限らない。
6. この論文がいま目に留まった理由と、束になっていないこと
この報告は Hugging Face の Daily Papers で 66 の upvote を集め、公開リポジトリには 18 の star が付いている。[3]upvote は読者の票、star は実装に関心を持った人の票であり、どちらも話題性を示すにとどまる。報告の正しさや、システムの優劣を示す数ではない。
当サイトの選定では、この報告に立った signal は読者の票の系統だけだった。star の数は実装の追随とみなす目安に届いておらず、報道の追随も確認されていない。同じ主題の論文の束もできておらず、束の大きさは 1 である。この週の収集の範囲では、この報告と同じ問いに寄った論文はまとまって現れていない。
したがって、この報告は「deep research の作業手順をどう組むか」という問いへの一つの事例として読むのが妥当である。主題そのものが一斉に動いている証拠としては扱えない。
7. 製薬・規制の現場から見ると
製薬の現場には、広い範囲を調べて根拠付きの文書にまとめる仕事が多い。疾患領域の情報整理、規制動向の調査、安全性に関する文献の取りまとめなどである。ここに deep research 型のシステムを使う場合、この報告の設計には参考になる点がある。
一つは、調査計画を文書として先に書き出すことである。何を、どの観点で、どこまで調べるかが残っていれば、レビューする側は結論より先に計画の妥当性を確かめられる。社内手順書で調査の範囲を定めるやり方と相性が良い。もう一つは、修正を節単位にとどめることで、承認済みの節が意図せず書き換わるのを防げる点である。文書の版管理や変更履歴を重んじる現場では、全文の書き直しより扱いやすい。
一方で、引用した根拠が主張を本当に支えているかは、どの設計でも人が確かめる必要がある。この報告はプレプリントであり、医療・規制分野の文書で同じ性能が出るかは、この報告の範囲では確かめられていない。社内ベンチマークの結果を自社業務の性能の目安として読み替えるのも避けたい。