AIとがん研究 ── がん一般 ── 2026-10-05
がん一般の分子生物学の進展とAI
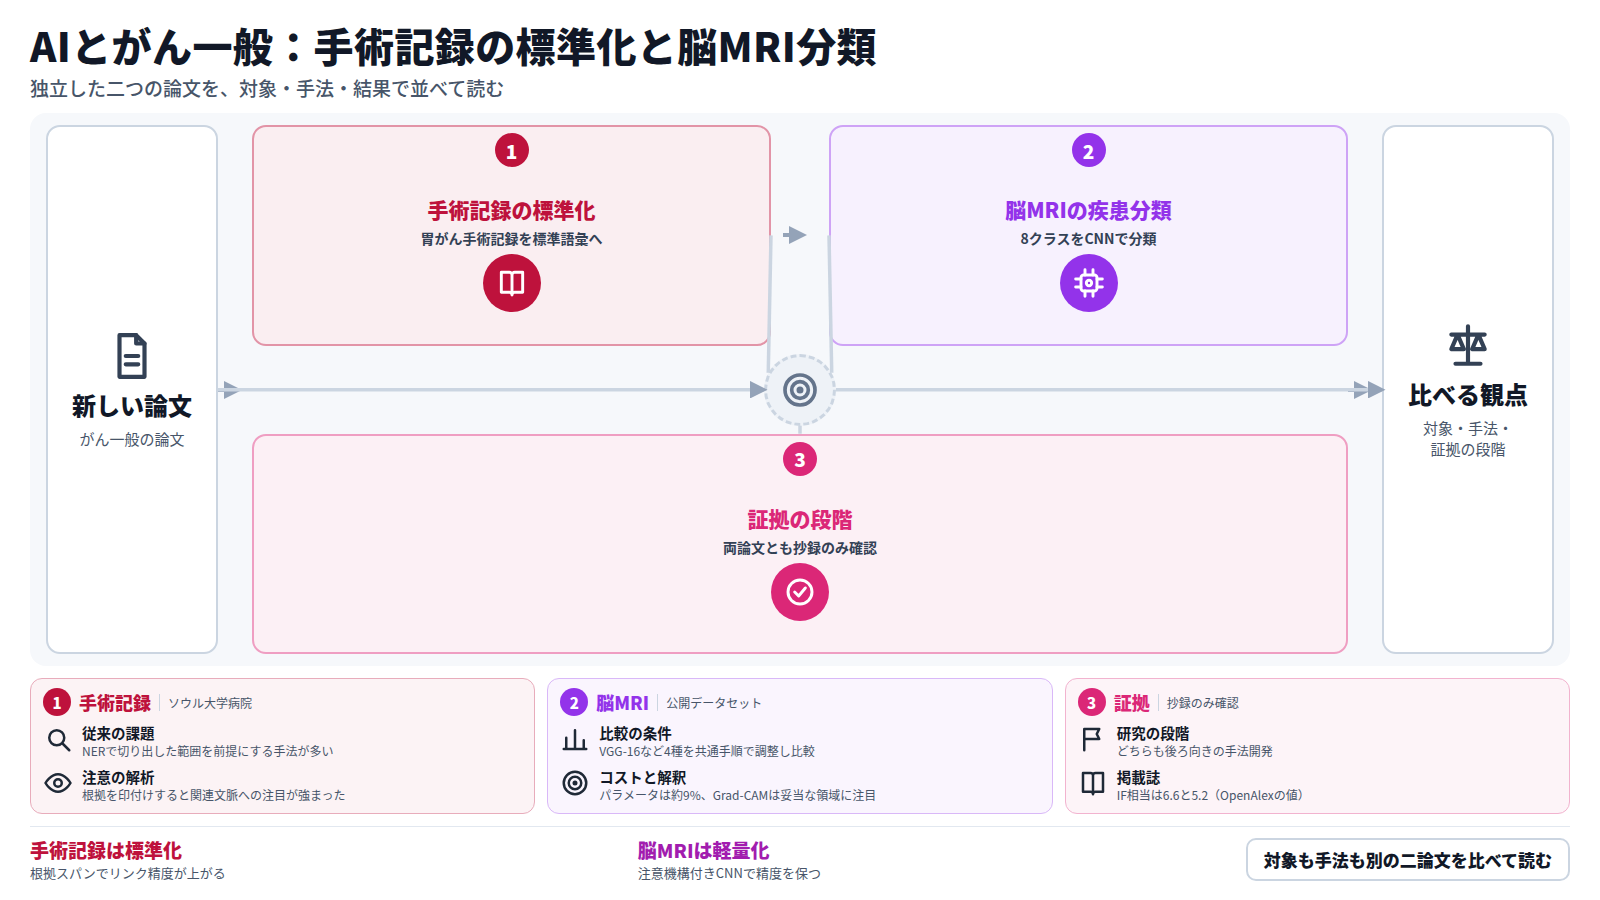
- Improving clinical data standardization in surgical notes through biomedical entity linking with contextual evidence from large language models抄録(全訳)
手術記録には、術後管理に欠かせない臨床情報が含まれる。しかし自由記述であり、施設ごとに書き方も異なる。そのため、標準化したデータとして表したり、二次解析に使ったりしにくい。生物医学エンティティリンキングは、さまざまな臨床表現を SNOMED-CT などの標準オントロジーに対応づける技術である。これは意味の相互運用性を支える。ただし既存の手法の多くは、固有表現抽出(NER)であらかじめ切り出した言及範囲を前提とする。この切り出しには手間がかかり、誤りが入り込むこともある。
ソウル大学病院の胃がん手術記録 9,051 件を解析した。オープンソースの大規模言語モデル(LLM)である LLaMA-3.1-8B を使う枠組みを開発した。LLM は、文脈上関連するテキストの部分を見つける。この部分を「根拠スパン(evidence span)」と呼び、オントロジーへのエンティティリンキングの手がかりとする。根拠スパンには明示的に印を付け、SapBERT のファインチューニングに使った。SapBERT は、埋め込み表現にもとづく事前学習済みの生物医学エンコーダーである。複数の入力形式を、従来のパイプラインや LLM を使う手法と比べた。LLM を使う手法には、文脈内学習(in-context learning)と再順位付け(re-ranking)が含まれる。
根拠スパンを加えると、どの指標でもエンティティリンキングの性能が上がった。生のテキストを入力した場合と比べ、Recall@1 は +2.7、上位 3 件での平均適合率の平均(mAP@3)は +2.2 改善した。根拠を手がかりにしたモデルは、ほかの LLM ベースの手法より性能が高かった。根拠マーカーのトークンをプーリング表現として使うと、さらに改善した。注意の解析では、根拠スパンを明示すると、モデルがオントロジーに関連する文脈への注目を強め、無関係なテキストへの注目を弱めることが示された。根拠スパンに明示的な印を付けると、モデルはオントロジーに関係する文脈へより強く注目した。一方、無関係なテキストへの注目は減った。
LLM で得た文脈上の根拠を使うと、生物医学エンティティリンキングの性能が上がる。その結果、臨床テキストをオントロジーにもとづいてより適切に表現できる。この手法は、構造化されていない手術記録を標準化する実用的な方法になる。実際の医療現場で、臨床データの二次利用の信頼性を高める助けにもなる。より広くみると、この枠組みは構造化されていない臨床テキストを標準オントロジーに対応づけることを支える。これは意味の相互運用性に寄与し、その後の臨床データの二次利用を可能にする。
掲載誌の IF 相当:6.6(OpenAlex の直近 2 年の平均被引用数・2026-10-04 時点の値、2026-10-05 に取得。正式な IF(Clarivate)ではない)書誌:Shin C, Eom D, You H, Kim K, Kim S, Yoon HJ. Improving clinical data standardization in surgical notes through biomedical entity linking with contextual evidence from large language models. BMC Med Inform Decis Mak. 2026 Oct 3 [Epub ahead of print]. doi:10.1186/s12911-026-03877-4.確認の範囲:抄録のみ確認 - An explainable vision transformer approach for automated neurological disorder classification from brain MRI scans抄録(全訳)
アルツハイマー病(AD)、多発性硬化症(MS)、脳腫瘍を手遅れになる前に診断するには、いまも脳 MRI に大きく頼っている。その脳 MRI の読影は放射線科医に頼るが、放射線科医はほぼどこでも不足している。畳み込みニューラルネットワーク(CNN)は、この問題で実際に成果を上げてきた。ただし、1 回の畳み込みで見えるのは画像の小さな範囲だけである。そのため、畳み込みだけのモデルでは、脳の広い範囲に散らばる病変をうまく結びつけにくい。
この研究は、この限界に二つの方向から同時に取り組んだ。一つは、確立された CNN のバックボーンを同じ手順で比べる対照比較である。もう一つは、そのうちの一つに軽量な注意機構を組み込むことである。
8 クラスの Multi-Class Neurological Disorder(MCND)データセット全体を分類した。8 クラスの内訳は、AD の MildDemented・ModerateDemented・VeryMildDemented、多発性硬化症、正常、脳腫瘍の 3 亜型である。3 亜型は、神経膠腫(glioma)、髄膜腫(meningioma)、下垂体腫瘍(pituitary)である。MRI 画像は 9,564 枚で、80:20 に分けた。学習用は 7,651 枚、テスト用は 1,913 枚である。
確立された CNN 4 種(VGG-16、ResNet-50、DenseNet121、EfficientNet-B0)を、共通の手順でファインチューニングした。これらを対照のベースラインとした。次に VGG-16 + CBAM を作った。VGG16 のバックボーンに、Convolutional Block Attention Module(CBAM)を組み込んだモデルである。VGG-16 本来の全結合層は、はるかに小さい分類ヘッドに置き換えた。学習は 15 エポックとし、最適化手法とデータ拡張の設定はベースラインと同じにした。
取り分けておいたテストセットでの成績は次のとおりである。正解率 98.90%、重み付き F1 スコア 0.9890、マクロ F1 0.9893 だった。マクロ平均の受信者動作特性曲線下面積(AUC-ROC)は 0.9997、マシューズ相関係数(MCC)は 0.9874 だった。この成績は、4 種のベースライン(正解率 98.12%〜98.85%)をすべて上回った。パラメータ数は 1,488 万で、VGG-16 の 1 億 3,429 万のおよそ 9% にとどまる。モデルサイズは 56.8 MB である。
各ベースラインについて、パラメータ数、モデルサイズ、FLOPs、GPU での推論時間、学習時間も報告した。精度の向上を、精度だけでなく実際の計算コストと照らして評価できるようにするためである。
8 クラスすべての Grad-CAM マップで、モデルは解剖学的に妥当な領域に注目していた。AD の各段階では脳室周囲と海馬、MS では白質に注目した。Grad-CAM では、各腫瘍亜型について腫瘍の中心部にモデルが注目していた。学習した特徴を t-SNE で射影すると、8 クラスはそれぞれ明確なクラスターを作り、ほとんど重ならなかった。
全体として、結果は次のことを示唆する。注意機構を加えた小さな CNN は、この課題で大きなバックボーンと同等以上の性能を、ずっと少ないコストで出せる。しかも、臨床医が信頼するのに必要な解釈可能性を失わない。
掲載誌の IF 相当:5.2(OpenAlex の直近 2 年の平均被引用数・2026-10-04 時点の値、2026-10-05 に取得。正式な IF(Clarivate)ではない)書誌:Alahmadi A, Asim N, Khan MZ, Sirshar M, Aljubayri I. An explainable vision transformer approach for automated neurological disorder classification from brain MRI scans. Sci Rep. 2026 Oct 2 [Epub ahead of print]. doi:10.1038/s41598-026-71565-4.確認の範囲:抄録のみ確認