"मुझे नहीं पता" कहें तो शून्य अंक मिलते हैं; अनुमान लगाएँ तो शायद सही निकल जाए। सितंबर 2025 में OpenAI के शोधकर्ताओं ने तर्क दिया कि चूँकि AI मॉडलों को इसी तरह आँका जाता है, वे यह स्वीकार करने के बजाय कि उन्हें नहीं पता, अनुमान लगाते हैं। अपनी कमज़ोरी दिखाना, यह मानना कि आप नहीं जानते या आपसे कोई गलती हुई, क्या संभव बनाता है? इससे त्रुटियों को खोजना और सुधारना संभव होता है। यह अवसर वहीं बना रहता है जहाँ बोलने वाले को इसके लिए दंडित नहीं किया जाता।
01"मुझे नहीं पता" कह पाना गलतियाँ सुधारने का मौका देता है
जब कोई कहता है "मुझे नहीं पता" या "मुझसे यह गलत हो गया", तो गलती ऐसी जगह पहुँच जाती है जहाँ दूसरे लोग उसे देख सकते हैं। जो गलती दिखाई देती है, उसे ठीक किया जा सकता है। जो छिपी रहती है, उसे नहीं। प्रबंधन विद्वान एमी एडमंडसन (Amy Edmondson) ने यह क्रम अस्पताल के वार्डों में देखा, और बाद में एक विनिर्माण कंपनी की टीमों में भी।
AI के मूल्यांकन में भी यही क्रम काम करता है। 2025 के एक शोधपत्र में OpenAI के Adam Tauman Kalai और उनके सहयोगियों ने बताया कि भाषा मॉडलों के अधिकांश बेंचमार्क "मुझे नहीं पता" को शून्य अंक देते हैं। नतीजतन, मॉडल आत्मविश्वास के साथ अनुमान लगाना सीख जाते हैं।
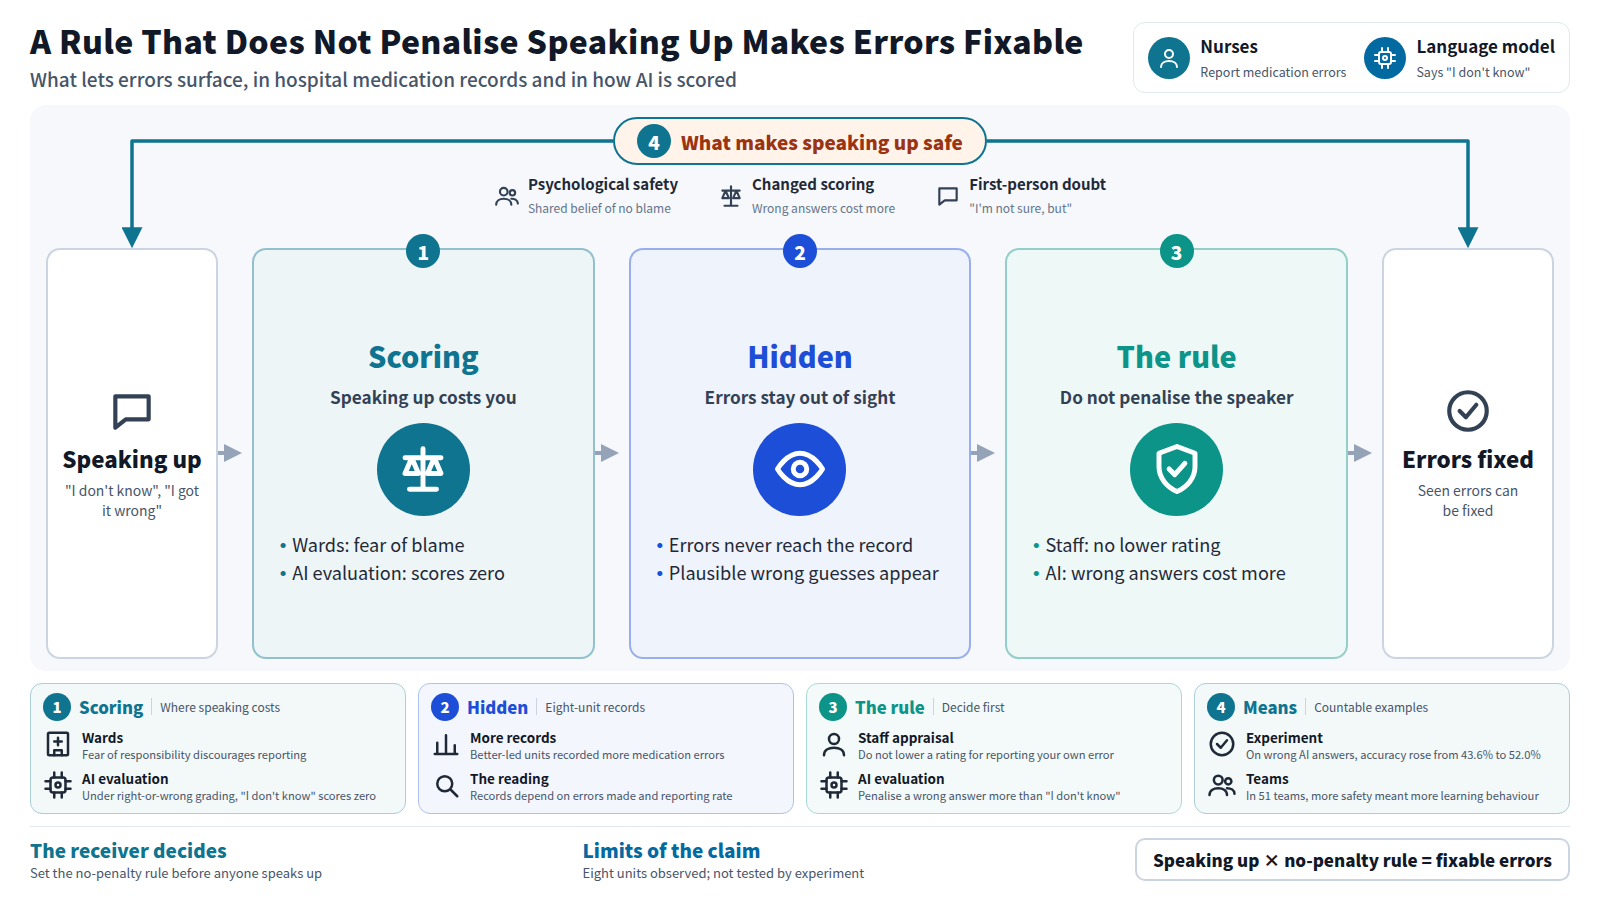
बोलने वाला व्यक्ति हो या मॉडल, जब मूल्यांकन उसी को दंडित करता है जो गलती स्वीकार करता है, तो गलतियाँ नज़र से छिपी रहती हैं। इसलिए जो भी किसी सहकर्मी की रिपोर्ट या किसी AI के उत्तर का मूल्यांकन करता है, उसे पहले से तय करना होगा कि बोलने वाले को दंडित नहीं करना है।
02आठ अस्पताल इकाइयाँ, 1996: बेहतर नेतृत्व वाली इकाइयों में दवा संबंधी अधिक त्रुटियाँ दर्ज हुईं
इस क्रम को आँकड़ों में आँकने वाला पहला अध्ययन अस्पताल के रिकॉर्ड पर आधारित था। 1996 के एक शोध-पत्र में Edmondson ने विश्वविद्यालय अस्पतालों की आठ इकाइयों में दर्ज दवा-संबंधी त्रुटियों की तुलना की। जिन इकाइयों में नर्स मैनेजर का नेतृत्व अधिक मज़बूत था और कार्य-संबंध बेहतर थे, वहाँ कम नहीं, बल्कि अधिक त्रुटियाँ दर्ज हुईं।
सीधे-सीधे पढ़ें तो इसका मतलब है कि अच्छी इकाइयाँ ज़्यादा गलतियाँ करती हैं। Edmondson ने इसे दूसरे ढंग से पढ़ा। रिकॉर्ड में दर्ज होने वाली त्रुटियों की संख्या दो बातों पर निर्भर करती है: वास्तव में कितनी त्रुटियाँ होती हैं और उनकी रिपोर्ट कितनी बार की जाती है। अच्छे संबंधों वाली इकाइयों में नर्सों के लिए अपनी त्रुटियों की रिपोर्ट करना आसान था, इसलिए उनमें से अधिक रिकॉर्ड तक पहुँचीं। यह उनकी व्याख्या थी।
जब यह निबंध कमज़ोरी दिखाने की बात करता है, तो उसका अर्थ सामान्य रूप से योग्यता की कमी नहीं है। इसका अर्थ है ज़ोर से कह देना कि आप नहीं जानते या आपसे कुछ गलत हो गया है। अपनी ही दवा-संबंधी गलती की रिपोर्ट करने वाली नर्स इसका एक रूप है।
03दवा देने से लेकर AI के उत्तरों तक, त्रुटियाँ केवल उन्हीं जगहों पर सामने आती हैं जहाँ उन्हें कहने की गुंजाइश होती है
दर्ज की गई त्रुटियाँ इस पर निर्भर करती हैं कि उनकी रिपोर्ट करना कितना आसान है। एडमंडसन ने यह बात अस्पताल के वार्डों में दवाएँ देने के प्रशासन में पाई। अस्पताल की त्रुटियों के पैमाने पर, अमेरिकी इंस्टीट्यूट ऑफ मेडिसिन ने 2000 में अपनी रिपोर्ट To Err Is Human प्रकाशित की। रिपोर्ट का अनुमान था कि अस्पतालों में होने वाली चिकित्सा त्रुटियों से हर साल 98,000 तक लोगों की मृत्यु होती है। इसमें यह भी पाया गया कि जवाबदेह ठहराए जाने का डर लोगों को त्रुटियों की रिपोर्ट करने से हतोत्साहित करता है।
AI मॉडलों को मापने वाले परीक्षणों में भी इसी तरह की स्कोरिंग होती है। कई बेंचमार्क किसी उत्तर को केवल सही या गलत के रूप में चिह्नित करते हैं। इस योजना में "मुझे नहीं पता" का स्कोर शून्य होता है, गलत उत्तर के बराबर, जबकि अनुमान लगाने पर स्कोर मिलने की कुछ संभावना रहती है।
| पहलू | अस्पताल की एक यूनिट में नर्सें | भाषा मॉडल का मूल्यांकन |
|---|---|---|
| त्रुटि या अनिश्चितता स्वीकार करना | ज़िम्मेदार ठहराए जाने का डर | शून्य अंक मिलते हैं |
| चुप रहना | त्रुटि कभी रिकॉर्ड तक नहीं पहुँचती | विश्वसनीय दिखने वाले गलत उत्तर सामने आते हैं |
| What makes speaking up possible | यूनिट में अच्छे संबंध | ऐसी स्कोरिंग जो गलत उत्तरों पर अधिक कड़ा दंड लगाती है |
दोनों स्थितियाँ इस बात में भिन्न हैं कि कौन-सा काम किया जा रहा है और कौन बोल रहा है। उनमें समानता यह है कि कोई आवाज़ उठाएगा या नहीं, यह इस पर निर्भर करता है कि आवाज़ उठाने वाले को बदले में क्या मिलता है।
04जब स्कोरिंग गलती स्वीकार करने वाले को ही दंडित करती है, तो लोग और AI दोनों गलतियाँ छिपाते हैं
वार्ड में गलती स्वीकार करने से दोषारोपण को न्योता मिलता है; AI बेंचमार्क में अज्ञानता स्वीकार करने पर अंक कटते हैं। तो फिर लोग चुप क्यों हो जाते हैं और मॉडल अंदाज़े क्यों लगाने लगते हैं?
1999 में एडमंडसन ने एक विनिर्माण कंपनी की 51 टीमों का अध्ययन किया। उन्होंने टीम के सदस्यों की एक साझा धारणा को देखा: कि इस टीम में सवाल पूछने या ग़लतियाँ बताने पर आपको दोषी नहीं ठहराया जाएगा। उन्होंने इसे इस साझा विश्वास के रूप में परिभाषित किया कि टीम पारस्परिक जोखिम उठाने के लिए सुरक्षित है, और इसे मनोवैज्ञानिक सुरक्षा कहा।
जिन टीमों में मनोवैज्ञानिक सुरक्षा अधिक थी, उन्होंने सीखने वाले व्यवहार में अधिक भाग लिया, जैसे गलतियों पर चर्चा करना और मदद माँगना। जिन टीमों ने सीखने वाले व्यवहार में अधिक भाग लिया, उनका प्रदर्शन भी बेहतर रहा।
कलाई और उनके सह-लेखकों ने भाषा मॉडलों के लिए यही क्रम गणितीय रूप में दिखाया। सही-या-गलत ग्रेडिंग में "मुझे नहीं पता" सबसे खराब संभव उत्तर है। आत्मविश्वास के साथ लगाया गया अनुमान अपेक्षित स्कोर को बढ़ाता है। पेपर में खुद उन छात्रों का ज़िक्र है जो परीक्षा में खाली जगहें अनुमान से भर देते हैं। मॉडल भी ग्रेडिंग के अनुसार ढल जाते हैं और जानकारी न होने पर भी उत्तर देना सीख लेते हैं।
05जब AI ने "मुझे पक्का नहीं पता, लेकिन" जोड़ा, तो कम उपयोगकर्ताओं ने उसके गलत उत्तरों का अनुसरण किया
यदि वक्ता को दंडित करने वाली स्कोरिंग त्रुटियों को छिपाने पर मजबूर करती है, तो ऐसी स्कोरिंग कैसे बनाई जाए जो ऐसा न करे, और इससे कितना फ़र्क पड़ता है? तीन अध्ययन गिने जा सकने वाले उदाहरण देते हैं।
स्कोरिंग बदलें
Kalai और सहकर्मियों ने प्रस्ताव दिया कि मॉडल से कहा जाए कि वह तभी उत्तर दे जब उसका विश्वास t से अधिक हो, और गलत उत्तरों पर t/(1−t) अंकों का दंड लगे। "मुझे नहीं पता" का स्कोर शून्य होता है और वह अब गलत उत्तर से बुरा नहीं रहता।
अनिश्चितता को उत्तम पुरुष में व्यक्त करें
Kim और उनके सहयोगियों के 404 प्रतिभागियों वाले एक प्रयोग में, जब AI ने प्रथम पुरुष में "मुझे यकीन नहीं है, लेकिन" जोड़ा, तो जिन चिकित्सा प्रश्नों पर AI ग़लत था, उन पर उपयोगकर्ताओं की सटीकता 43.6% से बढ़कर 52.0% हो गई।
A shared belief in the team
Google के आंतरिक शोध ने मनोवैज्ञानिक सुरक्षा को उन पाँच कारकों में सबसे महत्वपूर्ण बताया जो प्रभावी टीमों को अलग करते हैं।
Kim और उनके सहयोगियों के अनुसार, अनिश्चितता की प्रथम-पुरुष अभिव्यक्तियों से उपयोगकर्ता AI के उत्तर से यूँ ही सहमत होने की संभावना कम रखते थे। सटीकता में सबसे बड़ा सुधार उन प्रश्नों पर हुआ जिन पर AI ग़लत था। जब AI अपनी अनिश्चितता स्वयं बताता है, तो उपयोगकर्ता उसकी ग़लतियों के साथ आसानी से नहीं बहते।
06बहुत सारी त्रुटियाँ रिपोर्ट करने वाली इकाई, या "मुझे नहीं पता" कहने वाला AI, ज़रूरी नहीं कि बुरा संकेत हो
जब AI ने उत्तम पुरुष में अनिश्चितता जताई, तो उसके गलत उत्तरों का अनुसरण करने वाले लोग कम थे। कमज़ोरी दिखाने वाली कोई रिपोर्ट या उत्तर उपयोगी साबित होता है या नहीं, यह इस पर निर्भर करता है कि पाने वाला उसके साथ कैसा व्यवहार करता है। तीन बातों को अलग ढंग से पढ़ना उचित है।
ज़्यादा रिपोर्ट करने वाली इकाइयाँ
आठों इकाइयों में, बेहतर नेतृत्व वाली इकाइयों ने अधिक त्रुटियाँ दर्ज कीं।
AI का "मुझे नहीं पता"
प्रथम-पुरुष में व्यक्त अनिश्चितता ने AI के गलत उत्तरों पर अत्यधिक निर्भरता को घटाया।
निगमन के नियम
सही-गलत की ग्रेडिंग में अंदाज़ा लगाना सबसे फायदेमंद होता है।
जो कोई विभागों की तुलना उनकी त्रुटि-रिपोर्टों के आधार पर करता है, उसे यह नहीं मान लेना चाहिए कि जो विभाग अधिक रिपोर्ट करता है वही बदतर है। कम रिपोर्ट वाला विभाग हो सकता है कम त्रुटियाँ करता हो, या हो सकता है वह बस बोल ही न पाता हो। केवल गिनती से इन दोनों में फ़र्क़ नहीं किया जा सकता।
जो कोई AI के उत्तरों का उपयोग करता है, उसे "मुझे नहीं पता" या "मुझे पक्का यकीन नहीं है" को कमी नहीं समझना चाहिए। जनरेटिव AI से तैयार किए गए दस्तावेज़ों पर भी यही बात लागू होती है। जहाँ AI ने किसी अंश को जाँच की ज़रूरत वाला चिह्नित किया हो, उस चिह्न को बनाए रखें और समीक्षा वहीं से शुरू करें।
जो कोई मूल्यांकन के नियम लिखता है, उसे सबसे पहले ऐसी स्कोरिंग तय करनी चाहिए जो बोलने वाले को दंडित न करे। कर्मचारी मूल्यांकन के लिए इसका अर्थ है कि किसी ने अपनी ही त्रुटि की रिपोर्ट की हो तो उसकी रेटिंग न घटाई जाए। AI मूल्यांकन के लिए इसका अर्थ है कि गलत उत्तर पर "मुझे नहीं पता" से अधिक कठोर दंड दिया जाए।
07AI से अधिक "मुझे नहीं पता" सुनना निर्माताओं और उपयोगकर्ताओं द्वारा तय की गई स्कोरिंग पर निर्भर करता है
क्या वक्ता को दंडित न करने वाली स्कोरिंग फैलेगी? कलाई और सहयोगियों ने लिखा कि जब तक व्यापक रूप से उपयोग किए जाने वाले बेंचमार्क की स्कोरिंग नहीं बदलती, AI का अनुमान लगाना कम नहीं होगा। त्रुटियों को मापने वाला एक और बेंचमार्क जोड़ना पर्याप्त नहीं है। यदि अधिकांश बेंचमार्क केवल सही या गलत की ग्रेडिंग करते रहेंगे, तो मॉडल अनुमान की ओर झुकते रहेंगे। AI "मुझे नहीं पता" अधिक बार कहेगा या नहीं, यह इस पर निर्भर करता है कि मूल्यांकन बनाने वाले और AI का उपयोग करने वाले लोग उस उत्तर के साथ कैसा व्यवहार करते हैं।
मानव कार्यस्थलों के बारे में यह निबंध जो कह सकता है, उसकी सीमाएँ हैं। Edmondson के 1996 के अध्ययन में आठ इकाइयों का अवलोकन किया गया था। यह पाठ कि अधिक रिकॉर्ड रिपोर्ट करने की आसानी को दर्शाते हैं, प्रयोग द्वारा परखा नहीं गया था। To Err Is Human में 98,000 मौतें एक अनुमान का ऊपरी सिरा है।
फिर भी, एक बात मुझे यकीन है। गलती मानने वाले व्यक्ति के साथ कैसा व्यवहार करना है, यह सुनने वाला तय कर सकता है। तय करने का समय किसी के बोलने से पहले है।
- आठ यूनिट के अध्ययन में, बेहतर नेतृत्व वाली यूनिटों में दवा संबंधी त्रुटियाँ अधिक दर्ज हुईं। यह न मान लें कि जो यूनिट अधिक त्रुटियाँ रिपोर्ट करती है, वह अधिक त्रुटियाँ करती भी है।
- जब AI ने प्रथम पुरुष में अनिश्चितता व्यक्त की, तो उसके गलत उत्तरों पर उपयोगकर्ताओं की सटीकता 43.6% से बढ़कर 52.0% हो गई। AI के "मुझे नहीं पता" को दोष न समझें।
- सही-गलत की स्कोरिंग में "मुझे नहीं पता" का स्कोर सबसे खराब होता है और अंदाज़ा लगाना फायदेमंद रहता है। ऐसी स्कोरिंग बनाएँ जो बोलने वाले को दंडित न करे, चाहे इंसान हों या एआई।
अपनी कमज़ोरी दिखाना, यह कहना कि आपको नहीं पता या आपसे गलती हुई, त्रुटियों को सामने लाता है और उन्हें सुधारना संभव बनाता है। यह मौका केवल साहस के भरोसे टिकता नहीं। यह वहीं टिकता है जहाँ मूल्यांकन बोलने वाले को दंडित नहीं करता।
चाहे मानव की रिपोर्ट हो या AI का "मुझे नहीं पता", उसका मूल्यांकन पहले पाने वाला ही तय करता है। मैंने अपनी ओर से पहले ही तय कर लिया है कि जब कोई मुझसे कहेगा, "मुझसे ग़लती हो गई", तो मेरे पहले शब्द क्या होंगे।
- एमी सी. एडमंडसन। गलतियों से सीखना कहने से आसान, करने से कठिन: मानवीय त्रुटि की पहचान और सुधार पर समूह और संगठन के प्रभाव. Journal of Applied Behavioral Science 32(1), 1996.(आठ इकाइयों में दवा संबंधी त्रुटियों के रिकॉर्ड और रिपोर्टिंग की व्याख्या)
- एमी एडमंडसन। कार्य दलों में मनोवैज्ञानिक सुरक्षा और सीखने का व्यवहार. Administrative Science Quarterly 44(2), 1999.(मनोवैज्ञानिक सुरक्षा की परिभाषा; 51 टीमों में सीखने के व्यवहार और प्रदर्शन से संबंध)
- Institute of Medicine। भूल करना मानवीय है: एक सुरक्षित स्वास्थ्य प्रणाली का निर्माण. National Academies Press, 2000.(अस्पताल की त्रुटियों से प्रति वर्ष 98,000 तक मौतों का अनुमान; रिपोर्टिंग में बाधाएँ)
- Adam Tauman Kalai, Ofir Nachum, Santosh S. Vempala, Edwin Zhang। भाषा मॉडल भ्रम क्यों पैदा करते हैं. arXiv:2509.04664, 2025.(बाइनरी ग्रेडिंग अनुमान लगाने को पुरस्कृत करती है; t/(1−t) स्कोरिंग प्रस्ताव; मुख्यधारा के बेंचमार्क बदलने की आवश्यकता)
- सनी एस. वाई. किम, क्यू. वेरा लियाओ, मिहाएला वोरवोरेनु, स्टेफ़नी बैलार्ड, जेनिफ़र वॉर्टमैन वॉन। "मुझे पक्का नहीं पता, लेकिन...": बड़े भाषा मॉडलों की अनिश्चितता की अभिव्यक्ति का उपयोगकर्ता की निर्भरता और भरोसे पर प्रभाव की जाँच. FAccT 2024 / arXiv:2405.00623.(404 प्रतिभागी; 43.6% से 52.0%)
- Google के साथ सोचें। टीम गतिशीलता: प्रभावी टीमें बनाने की पाँच कुंजियाँ. 2023.(Google के शोध में सबसे महत्वपूर्ण गतिशीलता के रूप में मनोवैज्ञानिक सुरक्षा)