1. 有些胸部 X 光判讀無法僅憑目視就下定論
判讀胸部 X 光片,不只是說出看得到什麼。摘要正是從這一點出發。判讀往往需要將視覺發現與該任務特有的證據結合,而不是僅僅依賴直接的視覺辨識。[1]
工具增強型醫療代理一直是對此的一種解答。代理會將部分工作交給外部模組,例如裁切某個區域以便仔細觀察,或分割器官以測量大小,然後將結果納入其推理。針對胸部 X 光,先前的研究提出了一種串接這類工具進行多步驟推理的代理,以及名為 ChestAgentBench 的評測集。[3]
能呼叫工具,不等於能把工具用好。作者指出現有代理的兩個缺口。第一,缺乏明確的機制來學習何時真正需要輔助證據。第二,缺乏一種方式,阻止不適用於該影像的量化證據進入診斷推理。第一個缺口會導致過度頻繁呼叫工具,或完全不呼叫。第二個更危險:一個數字僅僅因為它是數字,就可能為錯誤的結論增添分量。
2. 核心概念:將尋找證據與接受測量結果分開
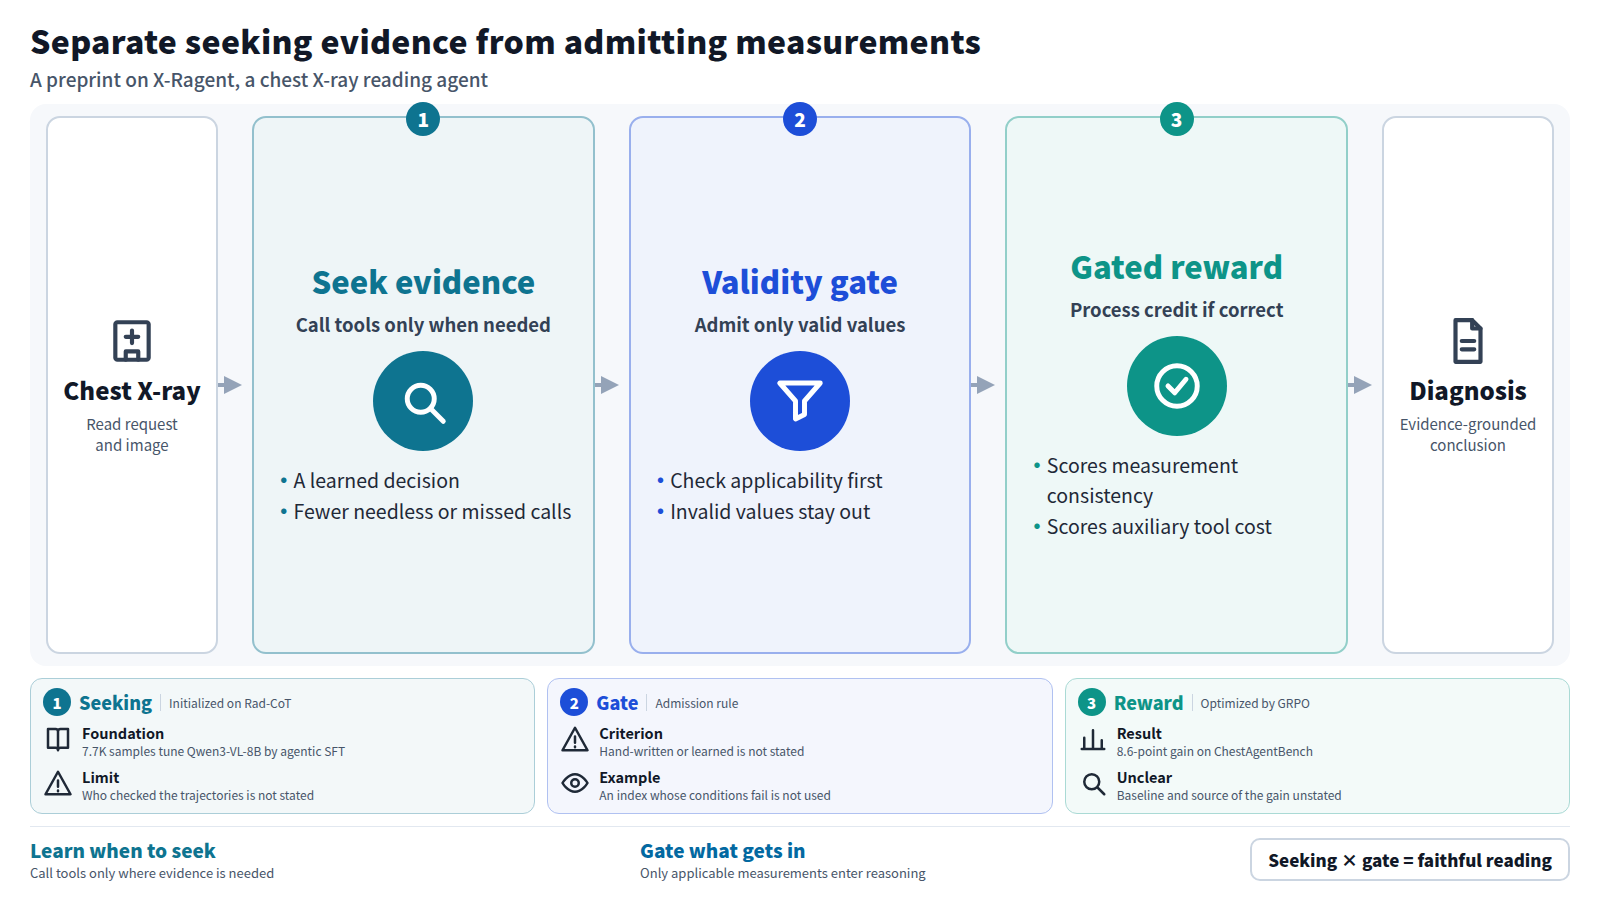
X-Ragent 是一個用於工具增強式強化學習的後訓練框架。其核心設計選擇,是將兩種行為解耦。其一是決定是否要去尋找輔助證據,這由模型自行學習。其二是效度閘門,在量化測量值被納入推理之前,先檢查該測量是否適用於這張影像。前者是學習而來的決策,後者則是數值的准入規則。
訓練分為兩個階段。作者首先建構 Rad-CoT,這是一個包含 7.7K 個樣本的語料庫,將依因果順序排列的工具使用軌跡與以放射科報告風格撰寫的診斷推理配對。他們以此透過代理式監督微調來初始化 Qwen3-VL-8B。
接著他們以群組相對策略最佳化(GRPO)來最佳化策略,這是一種既有方法,會針對同一問題取樣多個答案,並從每個答案與群組其餘答案的比較中學習。[4] 貢獻在於獎勵設計。過程層級的項目——一項針對測量一致性、一項針對使用輔助工具的成本——僅套用於診斷正確的軌跡。作者稱之為準確度閘控獎勵。其目的是避免看似合理的過程行為彌補錯誤的診斷。
3. 摘要所報告的內容
- 資料:Rad-CoT,7.7K 筆樣本,結合工具使用軌跡與報告式推理。
- 訓練:以代理式 SFT 初始化的 Qwen3-VL-8B,再於準確度門檻獎勵下以 GRPO 進行最佳化。
- 結果:在三項胸部 X 光基準測試中取得最佳成績,其中在完全未納入訓練的 ChestAgentBench 上提升了 8.6 個百分點。
- 作者的閱讀:藉由選擇性地尋找證據,並且只採納有效的測量值,系統能支援更忠實、以證據為基礎的推理。
有幾點值得查證。摘要並未說明 8.6 個百分點的提升是以什麼為比較基準,是基礎模型還是其他代理。摘要也只點出三項基準測試中的一項。「最強結果」取決於選擇了哪些系統來比較。而且摘要也沒有顯示獎勵設計的哪個部分帶來了改善。
4. 實際範例:決定不採用某項測量
要了解「不適用的測量」是什麼意思,可以考慮一個判讀情境。此範例用於說明概念;論文是否涵蓋這種情況,無法從摘要判斷。在胸部 X 光片上,病患的姿勢與射線方向會改變心臟的呈現方式,標準的心臟大小指標未必適用於每一張影像。
請求: 評估這張胸部 X 光是否顯示心臟肥大。
代理: (檢視影像)正在檢視肺野與縱隔。尺寸測量有助於評估心臟輪廓,因此我將呼叫測量工具。
代理: (檢查閘門)攝影條件不符合此指標背後的假設,該測量值不會進入推理。
代理: 我將根據可見的影像表現判斷,不採用該數值,並記錄該測量值已遭拒絕。
重點在於,呼叫工具與接受其輸出是兩個獨立的步驟。獎勵機制也做出了同樣的區分。把這兩種訓練訊號並排來看,就能看出差異。
一律加計過程獎勵
即使診斷錯誤,仔細的測量與節省的工具使用仍然能得分。一條軌跡可能因為看起來有條不紊而被強化,最終卻得出錯誤的答案。
準確度門檻獎勵(X-Ragent)
測量一致性與工具成本,僅針對診斷正確的軌跡計分。診斷錯誤的話,不論步驟多麼整齊,都得不到過程分數。結論必須先正確。
5. 哪些並非新事物,以及其侷限所在
先從並非新穎之處說起。工具使用型醫療代理在早期研究中便已存在,而 ChestAgentBench 本身就源自這類研究。[3] GRPO 是一種成熟的方法,在監督式微調之後進行強化學習,也是語言模型後訓練中常見的做法。新穎之處在於將尋求證據與測量值採信分開,以及將過程獎勵僅限於正確軌跡的獎勵設計。
有幾項限制。首先,是衡量是否適用的判準。摘要並未說明閘門(gate)檢視的是什麼,也沒說明其規則是由人撰寫還是學習而來。視其建構方式而定,它可能與放射科醫師的判斷不一致。
第二,評估的範圍。基準測試分數通常是針對結構化問題的準確率。摘要中並未提及完整報告的品質、遺漏了哪些類型的發現,以及對臨床決策的影響,也沒有說明這三項基準測試背後的醫院或影像條件。
第三,Rad-CoT 的建構。摘要將軌跡描述為依因果排序,但並未說明由誰、如何查核。訓練用推理中含有的任何偏見,模型都會一併學進去。
第四,可重現性。所選資料顯示 GitHub 星數為零,且沒有公開的程式碼庫。本文尚未確認是否能取得程式碼或資料。
6. 受到關注的原因,以及這個群體仍然很小的原因
篩選流程將這篇論文歸入「推理與學習」。其群集大小為 1:在本次收錄期間內,沒有找到其他探討相同問題的論文,唯一觸發的訊號是 Hugging Face 論文頁面上的投票,共有 67 個讚、1 則留言,以及 0 個 GitHub 星標。[2] 讚數只顯示研究人員注意到這篇論文,並不代表其主張成立,也不代表具有臨床價值。
這篇論文的關鍵字仍可看出它的定位:工具增強式強化學習、GRPO、代理式監督微調、以證據為基礎的推理。這些術語在近期的代理研究中反覆出現。本站最近曾報導過兩類論文:一類探討代理在證據尚未完整時就採取行動,另一類探討如何向人們呈現代理採取行動的依據。
X-Ragent 將這一系列研究帶入醫學影像這個特定領域。問題正從「代理能否使用工具?」轉變為「代理何時該信任工具回傳的結果?」不過,一篇論文並不足以構成一個主題。這個方向是否會發展成一個研究群,值得在未來幾週持續關注。
7. 這與製藥及法規實務的交會點
輔助影像診斷的軟體可被列為醫療器材加以監管。其審查不僅涵蓋效能數據,也包括可使用與不可使用的條件。將不適用的測量值排除在推論之外,這個想法與使用條件的概念相符。一個能判斷測量工具何時不適用,並記錄該判斷的系統,所產生的資料可以作為說明的依據。
以準確度作為門檻的獎勵機制,也類似品質保證的原則。遵循流程並不能取代正確的結果。必須先確認結果正確,才會評估流程。製造與檢測領域中的常規做法,在這裡被改寫成獎勵設計。
預印本中的基準測試結果不能等同於臨床表現。製藥公司最有可能在臨床試驗中接觸到這類技術,用於輔助影像判讀,或檢查這些判讀的一致性。即便在這種情況下,也必須留存哪些測量結果被採納、哪些被駁回的紀錄,最終決定權仍須掌握在醫師手中,且紀錄必須開放供日後審查。能應用到實務上的,與其說是某個具體數字,不如說是這項設計理念:把尋找證據與接受證據視為兩個不同的決策。