1. 「是不是 AI?」與「是不是真的?」是兩個不同的問題
近期的影像驗證研究多聚焦於一個問題:這張圖片是否由生成式模型所產出?摘要開頭即指出,這並未回答實務上真正重要的問題。知道影像是否為 AI 生成,並不能確立其所描繪的情境是否有事實依據。[1]
更棘手的是一般的情況。一張真實的照片被重新張貼,卻被說成是另一天或另一個地點。畫面是真的,但附帶的說法是假的。反過來也會發生:經過編輯的圖像仍可能傳達準確的資訊。在許多這類案例中,只會告訴你「真實」或「生成」的偵測工具並沒有幫助。
還有第二個難處。多數事實查核系統會收到一則書面主張,例如「這張照片顯示的是 X」,然後加以檢驗。本論文去除了這項主張:系統只拿到影像和一道通用的查證指令,必須自行判斷哪些內容值得查核。
2. 核心概念:在調查中修正問題
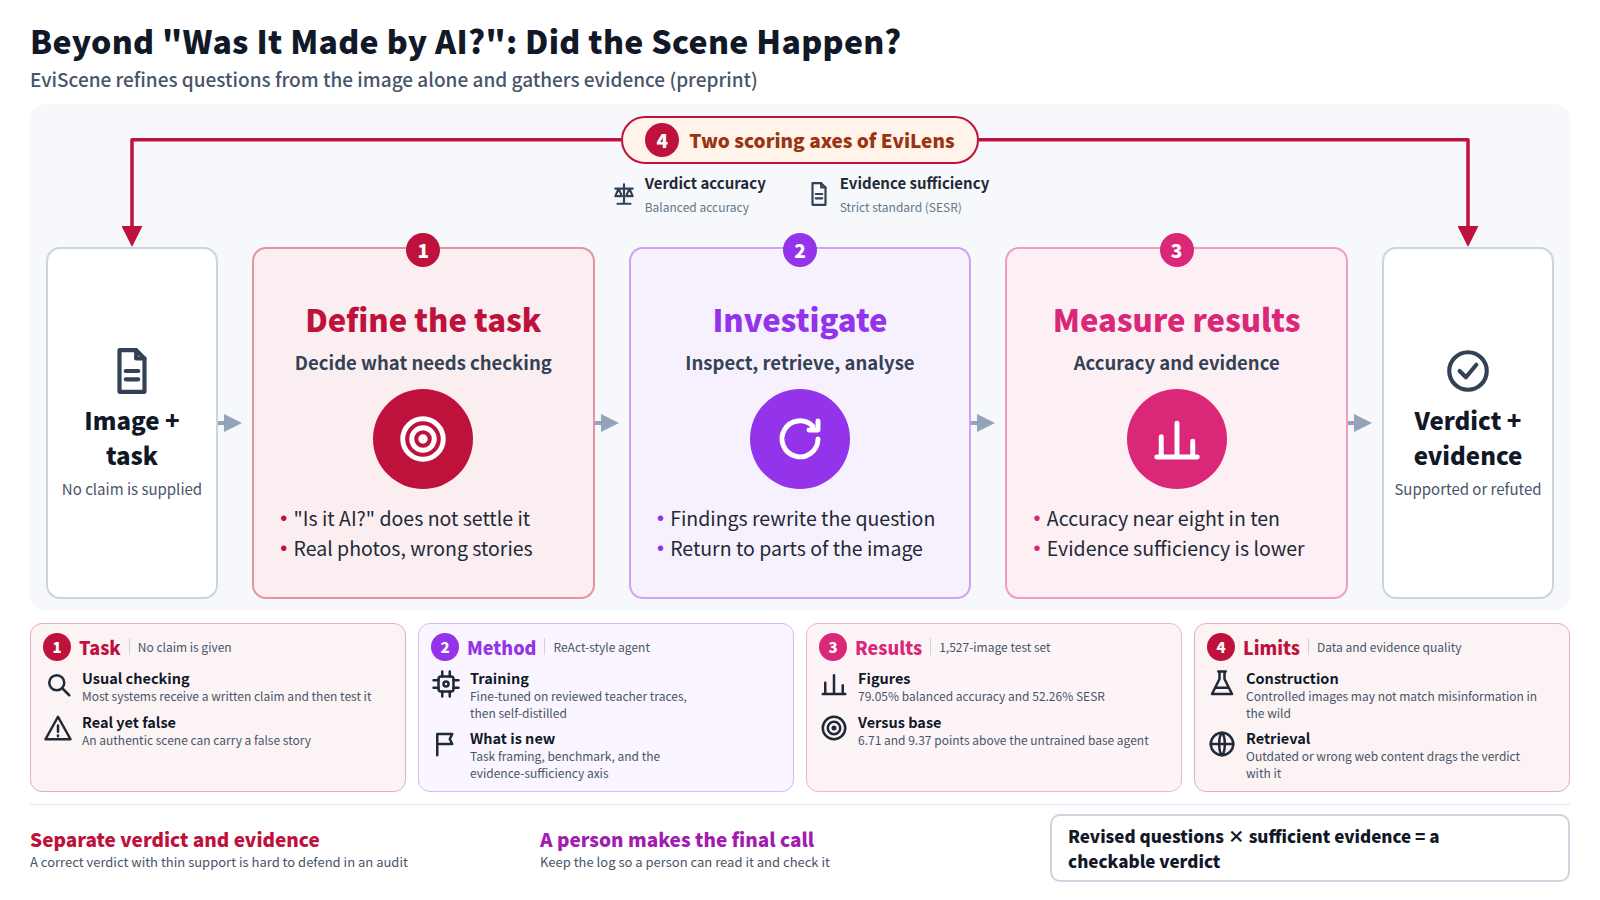
作者將任務定義如下:給定一張圖像與一則通用的查證指示,系統會回傳判定結果(受支持或遭反駁),並附上以證據為基礎的說明。由於未提供任何主張,系統必須隨著調查進行而逐步縮小其事實性問題,並將找到的外部證據與圖片中的具體情境相對應。
EviScene 正是為此任務而打造。根據摘要,它是 ReAct 風格的多模態代理人,會交替執行三種動作:檢視圖像、檢索外部資訊,以及分析證據。ReAct 是較早期的框架,讓語言模型在推理步驟與搜尋等動作之間交錯進行。[4]
這篇評論將方法收斂為一點:代理人利用新發現來改寫其問題,並回頭查看影像中的相關部分,而不是一直用最初的問題持續搜尋。作者主張,在沒有可作為搜尋依據的主張時,這種反覆往返的過程決定了判斷的品質。
訓練方法也有說明。首先,以人類審閱過的教師模型調查軌跡,對一個小型策略模型進行微調;接著,再針對其自身調查中可被驗證的決策,以特權式同策略自我蒸餾(privileged on-policy self-distillation)進行訓練。摘要中並未說明「特權」資訊具體包含什麼。
3. 摘要所報告的內容
- 基準(EviLens): 10,174 張經專家審查、被證實與被駁斥的圖像,來源包括受控建構與網路蒐集。涵蓋十二種事實錯誤類型,並同時評量判定的準確度與所引用證據是否充分。
- 模型: 一個以 Qwen3.5-9B 為骨幹訓練而成的代理。
- 結果: 在包含 1,527 張影像的測試集上,經過訓練的代理達到 79.05% 的平衡準確率,以及 52.26% 的嚴格證據充分率(SESR)。
- 比較: 這些數值比同一骨幹模型上未經訓練的基礎代理分別高出 6.71 與 9.37 個百分點。其 SESR 被描述為所評估代理中最高的。
有一項落差特別突出。證據充分性遠低於判決準確度,這表示正確的判決往往附帶著經不起嚴格審查的證據。摘要中並未指出其比較的其他代理,也未說明差距有多大。
4. 實例解析:一張在公司內部流傳的照片
試想一個貼近藥品工作的情境。內部聊天群組中貼出一張照片,顯示藥局貨架上一個陌生的包裝,大家開始詢問這是不是仿冒品。以下的交流僅為說明而套用 EviScene 的做法;摘要並未說明該論文是否包含此類影像。
工作人員: 請查證這張照片是否屬實。
代理: (檢視圖片) 我看到包裝標籤、貨架價籤,以及店內的告示。我首先要問的是,這個包裝是否與目前的正品設計相符。
代理: (搜尋) 製造商網站上有一則包裝變更的公告,新設計與照片相符。
代理: (修正問題) 接下來:這張照片被宣稱是在何時、何地拍攝的?我再看一次店內告示上的文字。
代理:判定:屬實。官方公告與包裝相符,因此仿冒品的說法並無依據。我無法確認照片的拍攝地點。
這個例子的重點在於,第一個問題(這是假的嗎?)與修正後的問題(這是何時、在何處拍攝的?)是不同的。論文之所以將證據充分性與準確性分開評分,原因就在於:在給出判定結果的同時,也一併回報無法確認的部分。
5. 哪些並非新事物,以及其侷限所在
有些部分並不陌生。將推理與搜尋交錯進行,承襲 ReAct 一系的研究;以外部證據查核主張,也有悠久的研究歷史;把教師模型的推理軌跡蒸餾到較小的模型,更是標準技術。其貢獻較適合視為任務設定(在未提供主張的情況下檢驗事實性)、基準測試,以及不僅檢視結論是否正確、也檢視證據是否充分的評估方式。
限制有數項。首先是 EviLens 的建構方式。在受控建構下產生的圖像讓錯誤類型易於整理,但可能與錯誤資訊在真實世界中的散布方式不符。摘要並未說明專家審查的範圍有多廣。
其次是證據本身的品質。代理程式仰賴檢索。如果它找到的網路內容已過時、有誤或遭人刻意植入,結論就會跟著走偏。摘要並未說明搜尋範圍或搜尋日期是如何確定的。
第三,是如何解讀這些數字。平衡準確率接近八成,也意味著該代理在大約每五個案例中就有一個判斷錯誤,而證據充分性則更低。這並非可以不再需要人工審查的水準,作者也並未如此主張。
第四,可重現性。摘要中提到程式碼、模型與資料將會釋出。這只是一項公開宣告的計畫;本評論並未查證是否已經釋出。
6. 為何此議題現在會形成集群
篩選流程將這篇論文歸入規模為2的「Agents and Autonomy」群集。另一篇論文「Beyond the Verdict」研究在不耗用正式提交次數的情況下,對競賽程式解答進行評判與診斷,並將生成的反例視為可檢驗的證據。[3]
圖像與程式是截然不同的素材。這兩篇論文的共通之處,在於都不滿足於僅給出對或錯的判定。兩者都要求系統產出第三方可以查驗的證據。隨著代理被賦予更多決策,問題從判定是否正確,轉變為事後是否有人能夠稽核,而兩篇論文都把這項要求納入了評估之中。
先說明一下,這些訊號並不大。在 Hugging Face 論文頁面上,這項研究有 44 個讚和 1 則留言,其 GitHub 儲存庫則有 0 顆星。[2]按讚數只能顯示研究人員注意到這篇論文,並不能說明其主張是否成立,也無法說明它在實務上是否有用。兩篇構成的群集規模很小,現在就稱之為已成形的趨勢還言之過早。
7. 與藥品及法規業務的關聯
製藥公司時常收到來源不明的圖片:社群媒體上的產品照片、可能是仿冒品的包裝、附在不良事件詢問中的圖片,以及擬用於宣傳資料、需確認來源的照片。這些情況都無法單靠詢問圖片是否為生成來解決。重要的是圖中所呈現的情況是否真實。
與實務最相關的設計選擇,是將判定結果與其證據是否充分分開處理。在受監管的決策中,結論是如何得出的紀錄,往往與結論本身同樣重要。判定正確但佐證薄弱,在稽核時難以辯護。將證據充分性獨立成一個評分軸,可為在查核工作中導入 AI 時如何訂定驗收標準提供思考方向。
即便如此,這類代理人的定位仍是初步分流與調查紀錄草稿的層級。由於其結果取決於特定時刻檢索所回傳的內容,因此其判定也與該時刻綁定。紀錄應當保存,最終裁斷仍應留給人,而且該人應能閱讀紀錄並加以核對。現階段從這篇預印本中可以汲取的,與其說是具體的效能數字,不如說是將判定與證據分開記錄的設計習慣。