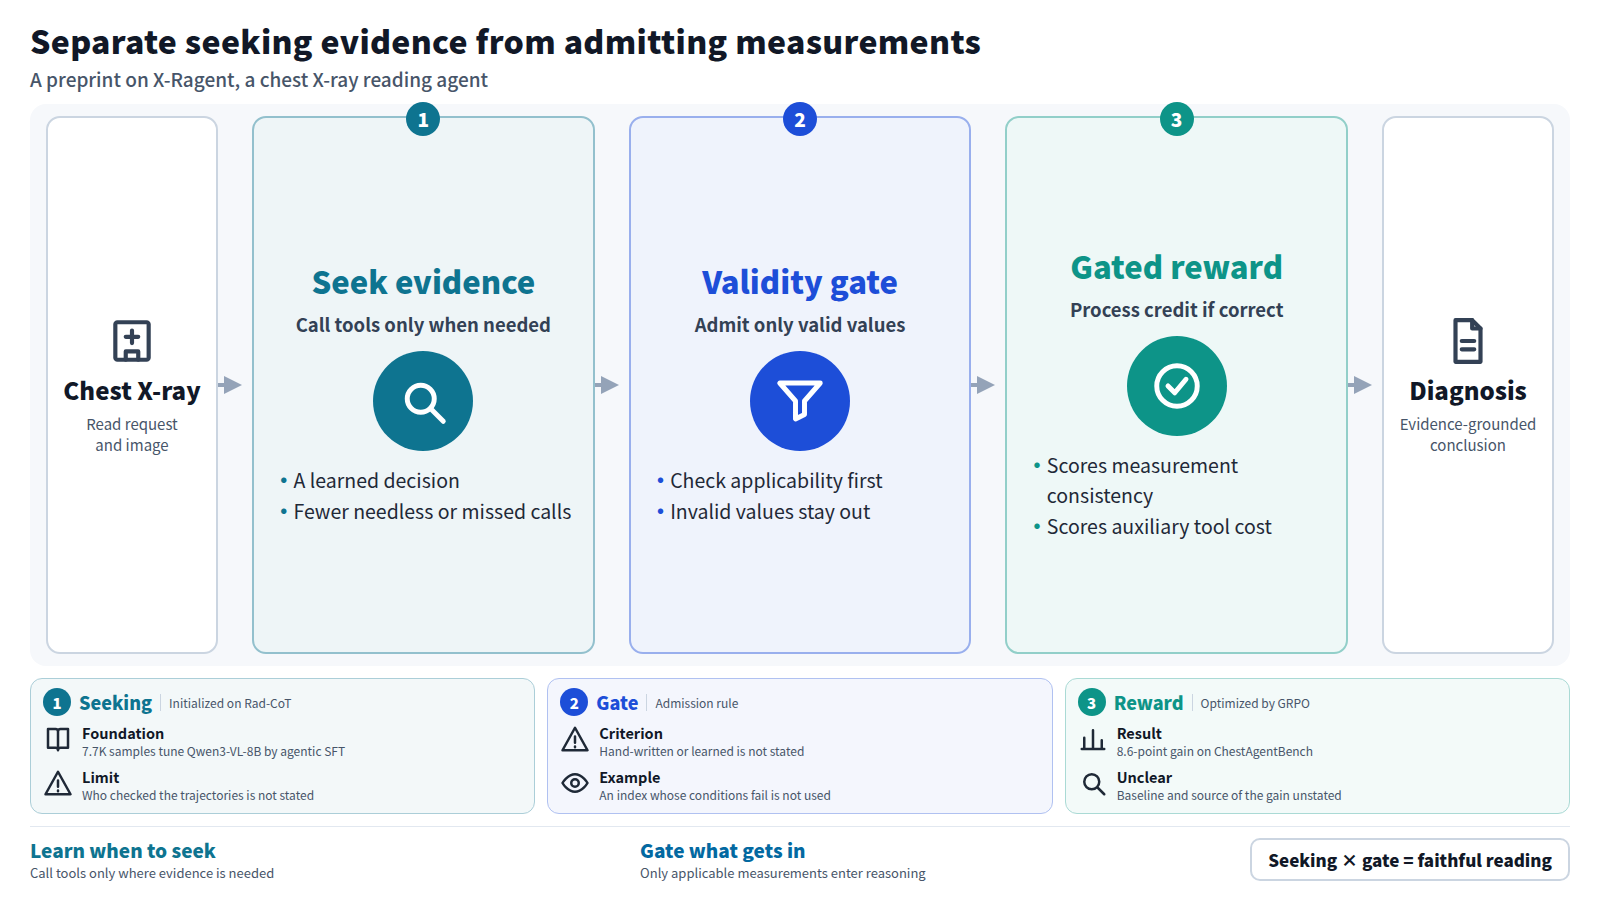
1. 有些胸部 X 光片的判读无法仅凭观察来确定
阅读胸部 X 光片不仅仅是说出可见的内容。摘要正是从这一点出发。解读往往需要将视觉发现与特定任务的证据相结合,而不是仅仅依赖直接的视觉识别。[1]
工具增强型医疗智能体是应对这一问题的一种方案。智能体将部分工作交给外部模块,例如裁剪某个区域以便仔细查看,或分割器官以测量其大小,然后将结果整合进自己的推理中。对于胸部X光片,早期研究提出过一种将此类工具串联起来进行多步推理的智能体,并配有名为 ChestAgentBench 的评测集。[3]
能够调用工具并不等于善于调用工具。作者指出现有智能体存在两方面的不足。第一,它们缺乏明确的机制来学习何时真正需要辅助证据。第二,它们缺乏一种方式,来阻止不适用于该图像的定量证据进入诊断推理。前者会导致工具调用过多或完全不调用。后者更危险:一个数字仅仅因为是数字,就可能让错误的结论显得更有分量。
2. 核心思路:将寻找证据与采纳测量结果分开
X-Ragent 是一个用于工具增强强化学习的后训练框架。其核心设计是将两种行为解耦:一是决定是否去寻找辅助证据,这由模型学习;二是有效性门控,在定量测量结果进入推理之前,检查该测量是否适用于当前图像。前者是习得的决策,后者是针对数值的准入规则。
训练分为两个阶段。作者首先构建了 Rad-CoT,这是一个包含 7.7K 个样本的语料库,将按因果顺序排列的工具使用轨迹与以放射学报告风格撰写的诊断推理配对。他们利用该语料库,通过智能体式监督微调来初始化 Qwen3-VL-8B。
随后,他们使用组相对策略优化(GRPO)来优化策略。这是一种现有方法,会针对同一问题采样多个答案,并根据每个答案与组内其余答案的比较结果进行学习。[4] 其贡献在于奖励设计。过程层面的两项奖励,一项针对测量一致性,另一项针对使用辅助工具的成本,仅应用于诊断正确的轨迹。作者称之为准确率门控奖励。其目的是防止看似合理的过程行为弥补错误的诊断。
3. 摘要报告了什么
- 数据:Rad-CoT,7.7K个样本,将工具使用轨迹与报告式推理相结合。
- 训练:以Qwen3-VL-8B为基础,先用智能体式SFT初始化,再在准确率门控奖励下用GRPO进行优化。
- 结果:在三个胸部X光基准测试中取得最强结果,其中在完全未参与训练的ChestAgentBench上提升了8.6个百分点。
- 作者的阅读:通过有选择地寻找证据,并且只接受有效的测量值,该系统支持更忠实、以证据为依据的推理。
有几点值得核实。摘要没有说明8.6个点的提升是相对什么衡量的,是基础模型还是其他智能体。它只点出了三个基准测试中的一个。“最强结果”取决于选择哪些系统作比较。而且摘要没有显示奖励设计的哪一部分带来了这一改进。
4. 一个实例:决定不使用某项测量
要理解不适用的测量意味着什么,不妨设想一个读片场景。此例仅用于说明思路;论文是否涵盖这种情况,无法从摘要中判断。在胸部 X 光片上,患者体位和射线方向会改变心脏的呈现方式,心脏大小的标准指数未必对每张影像都有效。
请求: 评估这张胸部 X 光片是否显示心脏肥大。
智能体:(查看影像)正在查看肺野和纵隔。对心影而言,尺寸测量会有所帮助,因此我将调用测量工具。
智能体:(检查门控)采集条件不符合该指标背后的假设,该测量结果将不会进入推理。
智能体: 我将根据可见的表现做出判断,不使用该数值,并记录该测量结果已被拒绝。
关键在于,调用工具与接受其输出是两个独立的步骤。奖励机制也做了同样的区分。把这两种训练信号并排放在一起,差异便一目了然。
始终加入过程奖励
即使诊断有误,认真测量和节约使用工具仍能得分。一条轨迹可能因为看起来有条不紊而得到强化,即便最终答案是错的。
准确率门控奖励(X-Ragent)
测量一致性和工具成本仅针对诊断正确的轨迹进行评分。诊断错误则无论步骤多么整齐,都得不到过程分。结论必须首先正确。
5. 哪些并不新鲜,以及局限何在
先说不新的部分。使用工具的医疗智能体在早期研究中已经存在,ChestAgentBench本身就来自此类研究。[3] GRPO 是一种成熟的方法,在监督微调之后运行强化学习是语言模型后训练中的常见做法。新的部分在于将寻求证据与采纳测量结果分开,以及将过程奖励仅限于正确轨迹的奖励设计。
存在若干局限。首先,是某项测量是否适用的判定标准。摘要没有说明这道“关卡”究竟查看什么,也没有说明其规则是由人编写的还是通过学习得到的。取决于其构建方式,它可能与放射科医生的判断不一致。
其次是评估范围。基准测试得分通常是结构化问题的准确率。摘要没有说明完整报告的质量、漏掉的发现类型,以及对临床决策的影响,也没有介绍这三个基准测试背后的医院或影像条件。
第三,Rad-CoT 的构建。轨迹被描述为按因果顺序排列,但摘要没有说明由谁检查、如何检查。训练推理中存在的任何偏差,模型都会一并学到。
第四,可复现性。入选数据显示 GitHub 星标为零,也没有公开的代码仓库。本文未能确认代码或数据是否可获取。
6. 为何引发关注,以及为何这一群体规模仍然很小
筛选流程将这篇论文归入“推理与学习”类别。其聚类规模为 1:在本次收集时间窗口内,没有发现关于同一问题的其他论文,触发的唯一信号是 Hugging Face 论文页面上的投票,共 67 个点赞、1 条评论和 0 个 GitHub 星标。[2] 点赞数表明研究人员注意到了这篇论文,但并不能说明其结论是否成立,也不能说明其是否具有临床价值。
这篇论文的关键词仍然显示了它所处的位置:工具增强的强化学习、GRPO、智能体式监督微调、基于证据的推理。这些术语在近期的智能体研究中反复出现。本站近期报道过的论文,涉及智能体在证据尚不完整时就采取行动,以及向人们展示智能体行动依据的问题。
X-Ragent 将这一系列研究带入了一个具体领域——医学影像。问题正从“智能体能否使用工具?”转向“智能体何时应当信任工具返回的结果?”不过,一篇论文还不足以构成一个主题。这一方向是否会发展成一个研究集群,值得在未来几周持续关注。
7. 这与制药和监管实务的交汇之处
辅助影像诊断的软件可以作为医疗器械受到监管。其评估不仅涵盖性能数据,还包括可以使用和不可使用的条件。将不适用的测量排除在推理之外,这一想法与使用条件的概念相吻合。一个能够判断测量工具何时不适用并记录该判断的系统,可以产生支持解释的材料。
以准确性为门槛的奖励机制也类似于一种质量保证原则:遵循流程并不能替代正确的结果。只有在确认结果正确之后,才会对流程进行评估。制造和测试领域的常规做法,在这里被改写成了一种奖励设计。
预印本中的基准测试结果不能当作临床表现来解读。制药公司最可能在临床试验的影像判读支持中,或在核查这些判读的一致性时接触到这类技术。即便如此,也必须保留哪些测量被采纳、哪些被拒绝的记录,最终决定权必须留给医生,且记录必须可供日后审查。能够应用到实践中的,与其说是某个具体数字,不如说是这一设计思路:把寻找证据和采纳证据视为两个不同的决策。