১. "এটা কি AI?" আর "এটা কি সত্যি?" — দুটি আলাদা প্রশ্ন
ছবি যাচাই নিয়ে সাম্প্রতিক কাজের বড় অংশ একটি প্রশ্নে কেন্দ্রীভূত: এই ছবিটি কি কোনো জেনারেটিভ মডেল তৈরি করেছে? অ্যাবস্ট্র্যাক্টের শুরুতেই উল্লেখ করা হয়েছে, বাস্তবে যে প্রশ্নটি গুরুত্বপূর্ণ, এটি তার উত্তর দেয় না। ছবিটি এআই-নির্মিত কি না তা জানলেই প্রমাণ হয় না যে ছবিতে দেখানো পরিস্থিতি তথ্যের দ্বারা সমর্থিত।[১]
কঠিনতর ক্ষেত্রগুলো সাধারণ ঘটনাই। একটি আসল ছবি এমনভাবে পুনঃপোস্ট করা হয় যেন তা অন্য দিন বা অন্য স্থানের। দৃশ্যটি খাঁটি, কিন্তু তার সঙ্গে জুড়ে দেওয়া গল্পটি মিথ্যা। উল্টোটিও ঘটে: সম্পাদিত ছবিও সঠিক কিছু জানাতে পারে। এমন অনেক ক্ষেত্রে, "আসল" বা "তৈরি" বলা কোনো ডিটেক্টর সাহায্য করে না।
দ্বিতীয় একটি অসুবিধাও আছে। বেশিরভাগ ফ্যাক্ট-চেকিং সিস্টেম একটি লিখিত দাবি পায়, যেমন "এই ছবিতে X দেখা যাচ্ছে", এবং তারপর সেটি যাচাই করে। এই গবেষণাপত্র সেই দাবিটি সরিয়ে দেয়। সিস্টেম শুধু ছবিটি এবং এটি যাচাই করার একটি সাধারণ নির্দেশ পায়। কোন বিষয়টি যাচাই করার মতো, তা তাকে নিজেকেই ঠিক করতে হয়।
2. মূল ধারণা: অনুসন্ধানের সময় প্রশ্নটি সংশোধন করা
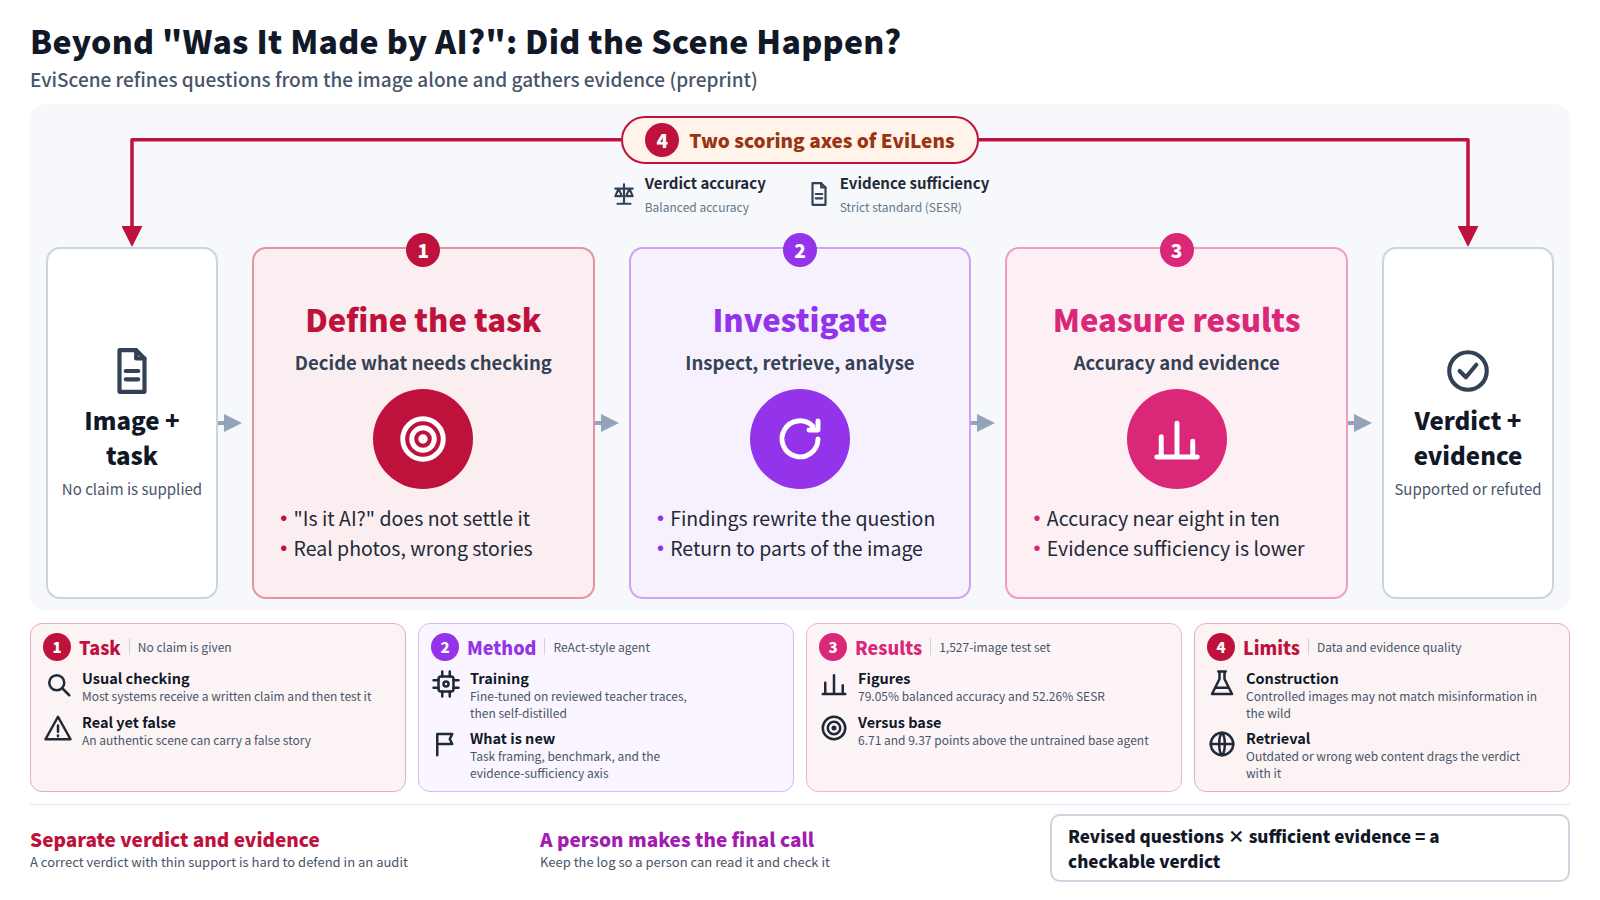
লেখকেরা কাজটিকে এভাবে সংজ্ঞায়িত করেছেন: একটি ছবি এবং একটি সাধারণ যাচাইকরণ নির্দেশ দেওয়া হলে সিস্টেম প্রমাণভিত্তিক ব্যাখ্যাসহ একটি রায় দেয়—সমর্থিত অথবা খণ্ডিত। যেহেতু কোনো দাবি দেওয়া হয় না, তাই তদন্ত এগোনোর সাথে সাথে সিস্টেমকে তার তথ্যগত প্রশ্নগুলো সংকুচিত করতে হয় এবং খুঁজে পাওয়া বাইরের প্রমাণকে ছবির নির্দিষ্ট পরিস্থিতির সঙ্গে মেলাতে হয়।
EviScene এই কাজের জন্যই তৈরি। অ্যাবস্ট্রাক্ট অনুযায়ী, এটি ReAct ধাঁচের একটি মাল্টিমোডাল এজেন্ট, যা তিনটি কাজ পর্যায়ক্রমে করে: ছবি পরীক্ষা, বাইরের তথ্য সংগ্রহ এবং প্রমাণ বিশ্লেষণ। ReAct একটি পূর্ববর্তী কাঠামো, যেখানে একটি ভাষা মডেল যুক্তির ধাপের সঙ্গে সার্চের মতো কাজ পালাক্রমে করে।[৪]
এই পর্যালোচনা পদ্ধতিটিকে একটি বিন্দুতে সংকুচিত করেছে: এজেন্ট নতুন প্রাপ্ত তথ্য ব্যবহার করে তার প্রশ্ন নতুন করে লেখে এবং ছবির প্রাসঙ্গিক অংশে ফিরে যায়। শুরুতে যে প্রশ্ন নিয়ে যাত্রা করেছিল, তা দিয়েই অনুসন্ধান চালিয়ে যায় না। লেখকদের যুক্তি, অনুসন্ধানকে নোঙর করার মতো কোনো দাবি না থাকলে এই আগুপিছু যাতায়াতই রায়ের মান নির্ধারণ করে।
প্রশিক্ষণ পদ্ধতিরও বর্ণনা দেওয়া হয়েছে। প্রথমে একটি কমপ্যাক্ট পলিসিকে একটি টিচার মডেলের তদন্ত ট্রেসের ওপর ফাইন-টিউন করা হয়, যা মানুষ পর্যালোচনা করেছে। এরপর এটিকে নিজের তদন্তের এমন সিদ্ধান্তগুলোর ওপর privileged on-policy self-distillation দিয়ে প্রশিক্ষণ দেওয়া হয়, যেগুলো যাচাই করা সম্ভব হয়েছিল। "privileged" তথ্য কী নিয়ে গঠিত, তা অ্যাবস্ট্রাক্টে উল্লেখ করা হয়নি।
৩. সারসংক্ষেপে কী জানানো হয়েছে
- বেঞ্চমার্ক (EviLens): বিশেষজ্ঞদের পর্যালোচিত 10,174টি সমর্থিত ও খণ্ডিত ছবি, যা নিয়ন্ত্রিত নির্মাণ ও ওয়েব সংগ্রহ উভয় থেকে নেওয়া। এটি বারো ধরনের তথ্যগত ভুল কভার করে এবং রায়ের নির্ভুলতা ও উদ্ধৃত প্রমাণ যথেষ্ট কি না, উভয়ের স্কোর দেয়।
- মডেল: Qwen3.5-9B ব্যাকবোনের ওপর প্রশিক্ষিত একটি এজেন্ট।
- ফলাফল: 1,527টি ছবির টেস্ট সেটে প্রশিক্ষিত এজেন্ট 79.05% ব্যালান্সড অ্যাকিউরেসি এবং 52.26% স্ট্রিক্ট এভিডেন্স সাফিশিয়েন্সি রেট (SESR) অর্জন করেছে।
- তুলনা: একই ব্যাকবোনে অপ্রশিক্ষিত বেস এজেন্টের তুলনায় এগুলো 6.71 ও 9.37 শতাংশ পয়েন্ট বেশি। এর SESR মূল্যায়িত এজেন্টদের মধ্যে সর্বোচ্চ বলে বর্ণিত হয়েছে।
একটি ফারাক চোখে পড়ে। প্রমাণের পর্যাপ্ততা রায়ের নির্ভুলতার তুলনায় অনেক কম, অর্থাৎ সঠিক রায়ের সঙ্গে প্রায়ই এমন প্রমাণ থাকে যা কঠোর পর্যালোচনায় টিকবে না। সারসংক্ষেপে তুলনা করা অন্য এজেন্টদের নাম বলা হয়নি, পার্থক্য কতটা বড় ছিল তাও বলা হয়নি।
4. একটি কার্যকর উদাহরণ: একটি কোম্পানির ভেতরে ঘুরে বেড়ানো একটি ছবি
ওষুধ-সংক্রান্ত কাজের কাছাকাছি একটি ঘটনা ভাবুন। একটি অভ্যন্তরীণ চ্যাটে ফার্মেসির তাকে রাখা একটি অচেনা প্যাকেজের ছবি পোস্ট করা হয়েছে এবং লোকজন জানতে চাইছে এটি জাল কি না। নিচের আদান-প্রদানে শুধু ব্যাখ্যার জন্য EviScene-এর পদ্ধতি প্রয়োগ করা হয়েছে; অ্যাবস্ট্র্যাক্টে বলা নেই গবেষণাপত্রে এই ধরনের ছবি ছিল কি না।
কর্মী: অনুগ্রহ করে যাচাই করুন এই ছবিটি তথ্যভিত্তিক কি না।
এজেন্ট: (ছবিটি পরীক্ষা করছে) আমি প্যাকেজের লেবেল, তাকের দামের ট্যাগ এবং দোকানের একটি নোটিশ দেখতে পাচ্ছি। আমার প্রথম প্রশ্ন, এই প্যাকেজটি কি বর্তমান আসল ডিজাইনের সঙ্গে মেলে?
এজেন্ট: (অনুসন্ধান করছে) প্রস্তুতকারকের সাইটে প্যাকেজিং পরিবর্তনের একটি নোটিশ আছে, এবং নতুন ডিজাইনটি ছবির সঙ্গে মেলে।
এজেন্ট: (প্রশ্নটি সংশোধন করছে) এরপর: ছবিটি কখন এবং কোথায় তোলা হয়েছে বলে উপস্থাপন করা হচ্ছে? আমি দোকানের নোটিশের লেখাটি আবার দেখব।
এজেন্ট: রায়: সমর্থিত। সরকারি বিজ্ঞপ্তি প্যাকেজের সঙ্গে মেলে, তাই জাল পণ্যের গল্পটি সমর্থিত নয়। ছবিটি কোথায় তোলা হয়েছিল তা আমি নিশ্চিত করতে পারিনি।
উদাহরণটির মূল কথা হলো, প্রথম প্রশ্ন (এটি কি জাল?) এবং সংশোধিত প্রশ্ন (এটি কখন ও কোথায় তোলা হয়েছিল?) আলাদা। রায়ের পাশাপাশি যা নিশ্চিত করা যায়নি তা-ও ফেরত দেওয়া থেকেই বোঝা যায়, কেন পেপারটি প্রমাণের পর্যাপ্ততাকে নির্ভুলতা থেকে আলাদাভাবে মূল্যায়ন করে।
৫. যা নতুন নয়, এবং সীমাবদ্ধতা কোথায়
কিছু অংশ পরিচিত। যুক্তি-বিশ্লেষণের সঙ্গে অনুসন্ধানকে মিশিয়ে চলা ReAct ধারার কাজ অনুসরণ করে। বাইরের প্রমাণের সঙ্গে দাবি যাচাই করার গবেষণার ইতিহাস দীর্ঘ। শিক্ষকের ট্রেস ছোট মডেলে ডিস্টিল করা একটি প্রচলিত কৌশল। এর অবদান বরং টাস্কের কাঠামো (কোনো দাবি না দিয়ে তথ্যনিষ্ঠতা যাচাই), বেঞ্চমার্ক এবং এমন একটি মূল্যায়ন, যা শুধু রায় সঠিক কি না নয়, প্রমাণ যথেষ্ট কি না তাও জিজ্ঞাসা করে।
সীমাবদ্ধতা কয়েকটি। প্রথমত, EviLens কীভাবে তৈরি হয়েছে। নিয়ন্ত্রিত নির্মাণে তৈরি ছবিতে ত্রুটির ধরন সাজানো সহজ, কিন্তু বাস্তবে ভুল তথ্য যেভাবে ছড়ায় তার সঙ্গে তা নাও মিলতে পারে। অ্যাবস্ট্রাক্টে বিশেষজ্ঞ পর্যালোচনা কতটা বিস্তৃত ছিল তা বর্ণনা করা হয়নি।
দ্বিতীয়ত, প্রমাণের মানই। এজেন্ট নির্ভর করে তথ্য-অনুসন্ধানের ওপর। সে যে ওয়েব কনটেন্ট পায় তা পুরোনো, ভুল বা ইচ্ছাকৃতভাবে বসানো হলে সিদ্ধান্তও সেটিকেই অনুসরণ করবে। অ্যাবস্ট্র্যাক্টে বলা নেই অনুসন্ধানের পরিধি বা অনুসন্ধানের তারিখ কীভাবে নির্ধারণ করা হয়েছিল।
তৃতীয়ত, সংখ্যাগুলো কীভাবে পড়তে হবে। দশে আটের কাছাকাছি ব্যালান্সড অ্যাকুরেসির অর্থ হলো এজেন্ট প্রায় পাঁচটির মধ্যে একটি ক্ষেত্রে ভুল করে, আর প্রমাণের পর্যাপ্ততা (evidence sufficiency) আরও কম। এটি এমন একটি স্তর নয় যেখানে মানুষের পর্যালোচনা বাদ দেওয়া যায়, এবং লেখকেরাও তা দাবি করেননি।
চতুর্থত, পুনরুৎপাদনযোগ্যতা। অ্যাবস্ট্রাক্টে বলা হয়েছে কোড, মডেল ও ডেটা প্রকাশ করা হবে। এটি একটি ঘোষিত পরিকল্পনা; প্রকাশ হয়েছে কি না তা এই পর্যালোচনায় যাচাই করা হয়নি।
৬. এই বিষয়টি এখন কেন গুচ্ছবদ্ধ হচ্ছে
নির্বাচন পাইপলাইন এই গবেষণাপত্রটিকে আকার 2-এর একটি "Agents and Autonomy" ক্লাস্টারে রেখেছে। অপর গবেষণাপত্র "Beyond the Verdict" অফিসিয়াল সাবমিশন খরচ না করে প্রতিযোগিতামূলক প্রোগ্রামিং সমাধান বিচার ও নির্ণয় নিয়ে কাজ করে, এবং তৈরি করা কাউন্টারএগজাম্পলগুলোকে যাচাইযোগ্য প্রমাণ হিসেবে গণ্য করে।[৩]
ছবি ও প্রোগ্রাম সম্পূর্ণ ভিন্ন ধরনের উপাদান। দুটি গবেষণাপত্রের মধ্যে মিল হলো, কেবল সঠিক-বেঠিক রায়ে থেমে না যেতে অস্বীকার করা। দুটিই সিস্টেমের কাছে এমন প্রমাণ চায় যা তৃতীয় পক্ষ যাচাই করতে পারে। এজেন্টদের হাতে যত বেশি সিদ্ধান্ত দেওয়া হচ্ছে, প্রশ্নটি ততই সরে যাচ্ছে রায় সঠিক কি না থেকে পরে কেউ তা নিরীক্ষা করতে পারে কি না-র দিকে, এবং দুটি গবেষণাপত্রই এই প্রয়োজনীয়তাকে তাদের মূল্যায়নে অন্তর্ভুক্ত করেছে।
নথির জন্য বলা যায়, সংকেতগুলো সামান্যই। Hugging Face-এর পেপার পেজে কাজটির ৪৪টি আপভোট ও ১টি মন্তব্য রয়েছে, আর এর GitHub রিপজিটরিতে স্টার ০টি।[২] আপভোট দেখায় যে গবেষকরা পেপারটি লক্ষ্য করেছেন। এর দাবি টেকে কি না বা বাস্তবে কাজে লাগে কি না, সে সম্পর্কে এটি কিছুই বলে না। দুটির একটি গুচ্ছ ছোট, এবং একে পূর্ণাঙ্গ প্রবণতা বলা অকালপক্ব হবে।
7. ওষুধশিল্প ও নিয়ন্ত্রক কাজের সঙ্গে এর সংযোগ কোথায়
ফার্মাসিউটিক্যাল কোম্পানিগুলো সারাক্ষণই অনিশ্চিত উৎসের ছবি পায়: সোশ্যাল মিডিয়ায় পণ্যের ছবি, জাল হতে পারে এমন প্যাকেজিং, প্রতিকূল ঘটনার অনুসন্ধানের সঙ্গে সংযুক্ত ছবি, এবং প্রচার সামগ্রীতে ব্যবহারের প্রস্তাবিত ছবি যার উৎস যাচাই করা দরকার। ছবিটি তৈরি করা কি না, তা জিজ্ঞেস করে এর কোনোটিরই সমাধান হয় না। আসল বিষয় হলো ছবিতে দেখানো পরিস্থিতিটি বাস্তব কি না।
চর্চার ক্ষেত্রে সবচেয়ে প্রাসঙ্গিক নকশাগত সিদ্ধান্ত হলো রায় এবং তার প্রমাণের পর্যাপ্ততার মধ্যে বিভাজন। নিয়ন্ত্রিত সিদ্ধান্তে সিদ্ধান্তে পৌঁছানোর নথি প্রায়ই সিদ্ধান্তের মতোই গুরুত্বপূর্ণ। দুর্বল ভিত্তিসহ সঠিক রায় অডিটে রক্ষা করা কঠিন। প্রমাণের পর্যাপ্ততাকে আলাদা মানদণ্ডে মূল্যায়ন করলে যাচাইয়ের কাজে AI যুক্ত করার সময় গ্রহণযোগ্যতার মানদণ্ড নিয়ে ভাবার একটি উপায় পাওয়া যায়।
তবুও, এই ধরনের একটি এজেন্ট প্রাথমিক বাছাই (first-pass triage) এবং একটি খসড়া তদন্ত-লগের স্তরেই থাকবে। কোনো নির্দিষ্ট মুহূর্তে রিট্রিভাল কী ফেরত দেয় তার ওপর নির্ভর করে বলে এর সিদ্ধান্তগুলো সেই মুহূর্তের সঙ্গেই বাঁধা। লগটি রাখা উচিত, চূড়ান্ত সিদ্ধান্ত একজন মানুষের হাতেই থাকা উচিত, এবং সেই ব্যক্তি যেন লগটি পড়ে যাচাই করতে পারেন। এই পর্যায়ে একটি প্রিপ্রিন্ট থেকে যা নেওয়া যায়, তা নির্দিষ্ট পারফরম্যান্সের সংখ্যা নয়, বরং সিদ্ধান্ত ও প্রমাণ আলাদাভাবে লিপিবদ্ধ করার নকশাগত অভ্যাসটি।