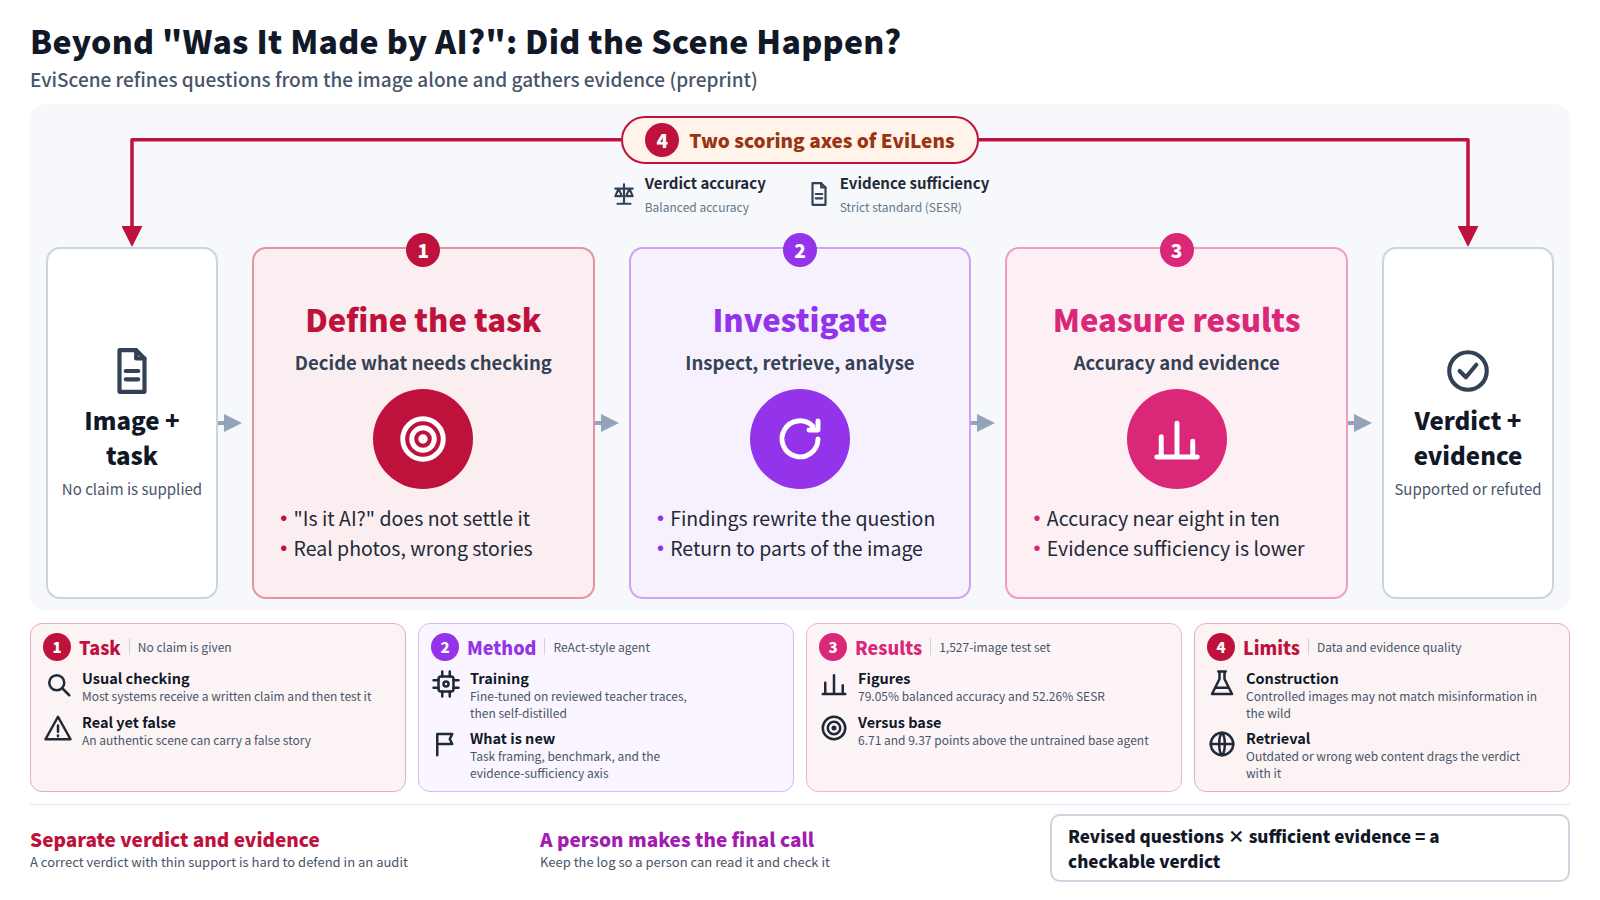
1. “是AI吗?”和“是真的吗?”是不同的问题
近来图像核查方面的大量工作都集中在一个问题上:这张图片是否由生成式模型制作?摘要开篇即指出,这并不能回答实践中真正重要的问题。知道一张图像是否由AI生成,并不能确定它所描绘的情境是否有事实依据。[1]
更难处理的是普通的情形。一张真实的照片被重新发布,仿佛拍的是另一天或另一个地方。场景是真实的,但附在上面的说法是虚假的。反过来也会发生:经过编辑的图像仍可能传达准确的信息。在许多此类情形中,只告诉你“真实”或“生成”的检测器并没有帮助。
还有第二个难点。大多数事实核查系统接收的是一条书面主张,例如“这张照片显示的是X”,然后对其进行检验。本文去掉了这条主张。系统只得到图像和一条通用的核实指令,必须自行判断什么值得核查。
2. 核心理念:边调查边修正问题
作者将该任务定义如下:给定一张图像和一条通用的核查指令,系统返回一个结论(受支持或被驳斥),并附上基于证据的解释。由于没有提供具体主张,系统必须在调查过程中逐步缩小其事实性问题的范围,并将找到的外部证据与图片中的具体情形相匹配。
EviScene正是为这一任务而构建的。根据摘要,它是一个ReAct风格的多模态智能体,在三种动作之间交替进行:检视图像、检索外部信息和分析证据。ReAct是一种早期框架,让语言模型将推理步骤与搜索等动作交替进行。[4]
这篇综述把方法归结为一点:智能体利用新的发现来改写自己的问题,并回到图像的相关部分。它不会一直用最初的问题继续搜索。作者认为,当没有可作为搜索依据的论断时,这种来回往复决定了判断的质量。
训练方法同样有说明。首先,在经人工审核的教师模型调查轨迹上,对一个紧凑的策略模型进行微调。随后,针对其自身调查中可以验证的决策,采用特权式在线策略自蒸馏(privileged on-policy self-distillation)对其进行训练。摘要中没有说明“特权”信息具体包括什么。
3. 摘要报告了什么
- 基准测试(EviLens): 10,174 张经专家审核的受支持与被驳斥的图像,来自受控构建和网络收集两种方式。涵盖十二种事实错误类型,并同时对判定准确性及所引证据是否充分进行评分。
- 模型: 一个基于Qwen3.5-9B骨干网络训练的智能体。
- 结果:在一个包含1,527张图像的测试集上,经过训练的智能体达到了79.05%的平衡准确率和52.26%的严格证据充分率(SESR)。
- 对比:这些数值比同一骨干模型上未经训练的基础智能体分别高出6.71和9.37个百分点。其 SESR 被描述为所评估智能体中最高的。
有一处差距十分突出:证据充分性远低于结论准确率,这意味着正确的结论往往附带着经不起严格审查的证据。摘要中没有指出其对比的其他智能体是哪些,也没有说明这些差距有多大。
4. 实例演示:在公司内部流传的一张照片
来看一个贴近制药工作的案例。内部聊天中有人发了一张照片,显示药房货架上一个陌生的包装,大家开始询问这是否是假药。下面的交流应用了 EviScene 的方法,仅作示意;摘要并未说明该论文是否包含此类图像。
员工:请核实这张照片是否属实。
智能体:(检查图片)我能看到包装标签、货架价签和店内的一则告示。我的第一个问题是,这个包装是否与当前正品设计一致。
智能体:(搜索)制造商网站上有一则关于包装变更的公告,新设计与照片相符。
智能体:(修正问题)接下来:这张照片被说成是何时、何地拍摄的?我再看一下店内告示上的文字。
智能体: 结论:成立。官方通知与包装相符,因此假冒之说缺乏依据。我无法确认照片的拍摄地点。
这个例子的要点在于,第一个问题(它是伪造的吗?)与修正后的问题(它是何时何地拍摄的?)并不相同。在给出结论的同时一并给出无法确认的内容,正反映了该论文将证据充分性与准确性分开评分的原因。
5. 哪些并不新鲜,以及局限何在
有些部分并不陌生。将推理与搜索交织属于 ReAct 一脉的研究。用外部证据核查论断也有悠久的研究历史。将教师模型的轨迹蒸馏到较小模型中是一种标准技术。其贡献更适合理解为任务设定(无需提供论断的事实性判断)、基准测试,以及不仅询问结论是否正确、还询问证据是否充分的评估方式。
局限有几点。第一,EviLens的构建方式。在受控构建下生成的图像便于归类错误类型,但可能与现实中传播的错误信息不相符。摘要没有说明专家审核的范围有多广。
其次,是证据本身的质量。该智能体依赖检索。如果它找到的网络内容已过时、有误或是被人植入的,结论就会随之出错。摘要没有说明搜索范围或搜索日期是如何确定的。
第三,如何解读这些数字。平衡准确率接近八成,也意味着智能体大约每五个案例就会出错一次,而证据充分性则更低。这个水平还不足以取消人工审核,作者也并未声称可以取消。
第四,可复现性。摘要称代码、模型和数据将会发布。这只是已声明的计划;本评述尚未核实发布是否已经完成。
6. 为何该话题现在集中出现
筛选流程将这篇论文归入了规模为2的“智能体与自主性”聚类。另一篇论文“Beyond the Verdict”研究在不消耗正式提交次数的情况下,对竞赛编程解答进行评判和诊断,并将生成的反例视为可检验的证据。[3]
图像和程序是截然不同的材料。这两篇论文的共同之处,在于都拒绝止步于一个简单的对错判定。两者都要求系统给出第三方可以核查的证据。随着智能体被赋予更多决策,问题从判定是否正确,转向事后是否有人能够审计,而两篇论文都把这一要求写入了各自的评估。
需要说明的是,这些信号并不强。在 Hugging Face 论文页面上,这项工作有 44 个点赞和 1 条评论,其 GitHub 仓库有 0 个星标。[2] 点赞数只表明研究人员注意到了这篇论文,并不说明其论断是否成立,也不说明其在实践中是否有用。仅有两篇构成的集群规模很小,就称之为已完全成形的趋势还为时过早。
7. 这与制药和监管工作的交汇之处
制药公司随时都会收到来源不明的图片:社交媒体上的产品照片、可能是假冒的包装、附在不良事件咨询中的图片,以及被提议用于宣传材料、需要核查来源的照片。这些问题都不能靠询问图片是否为生成来解决。关键在于图中所描绘的情形是否真实。
与实践最相关的设计选择,是将结论与其证据的充分性分开。在受监管的决策中,得出结论的过程记录往往与结论本身同样重要。一个正确但依据薄弱的结论,在审计中很难站得住脚。把证据充分性放在单独的维度上评分,为在核查工作中引入AI时如何思考验收标准提供了一种思路。
即便如此,这样的智能体也只能停留在初筛分诊和调查日志草稿的层面。由于它依赖于检索在特定时刻返回的内容,其判定结果与该时刻绑定。日志应当保留,最终裁决仍应交由人来做,而且这个人应当能够阅读日志并加以核查。现阶段从这篇预印本中能够借鉴的,与其说是具体的性能数字,不如说是将判定与证据分开记录的设计习惯。