1. この論文は何を問題にしているか
問題は、医療 AI の評価が、医療の現場で必要とされる仕事の一部にしか届いていないことである。著者らは、包摂的な医療に役立つ AI を進めるには、医療の中のさまざまな役割、課題、診療の場面にわたって評価する必要があるのに、既存のベンチマークの覆う範囲には偏りがある、と書いている[1]。
偏りの指摘そのものは以前からある。医師国家試験のような試験問題でほぼ満点に近い点が出ても、実際の診療の複雑さは映らない、という指摘は、医療向けの言語モデルを幅広い課題で評価しようとした MedHELM でもなされていた[3]。試験問題は作りやすく、採点しやすい。そのぶん評価が集まりやすく、患者への説明や、限られた資源の中での判断のような仕事は手薄になる。
この論文が問うのは、どの役割のどの能力が測られていて、どこが空白なのかを、地図の形で見えるようにできないか、ということである。本記事が扱うのは arXiv に公開された査読前のプレプリントであり、以下はすべて著者らの主張として読む。
2. 何を提案しているか
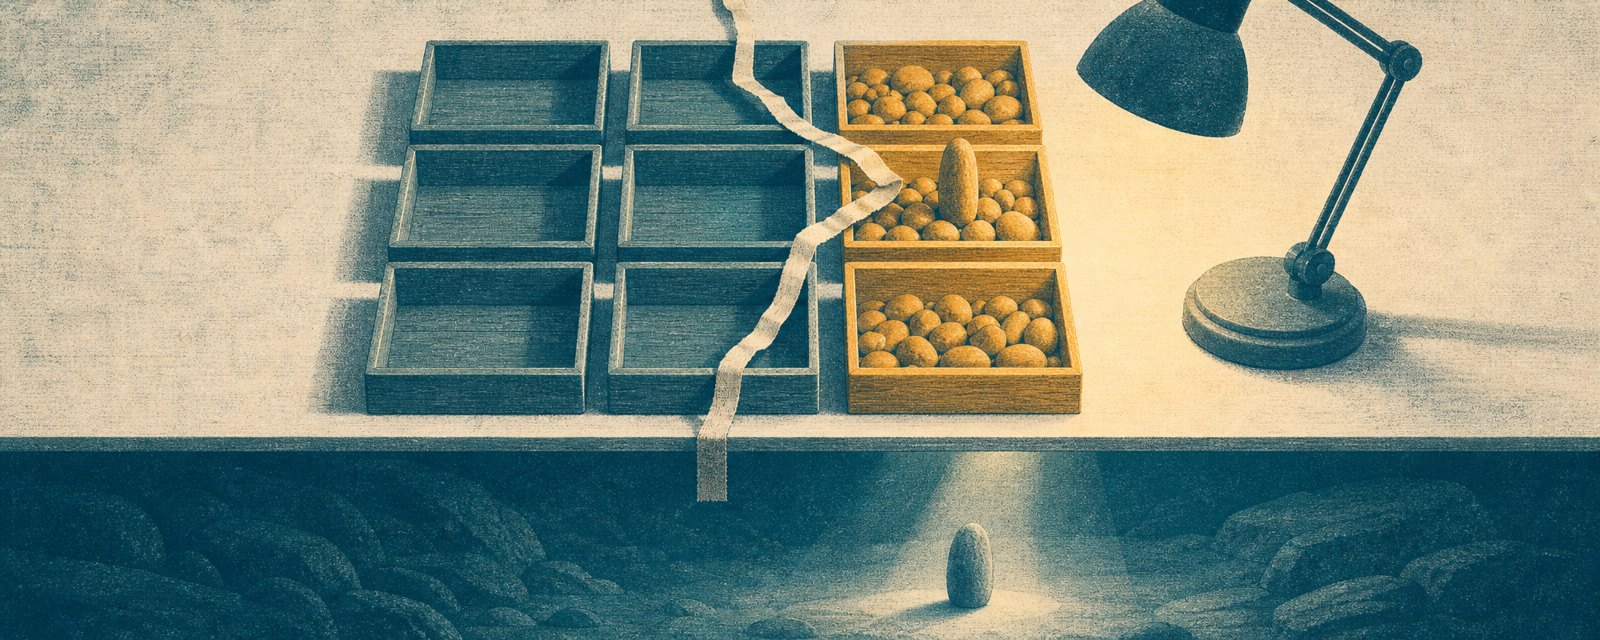
手法の芯は、ベンチマークを「医療の役割」と「AI の能力」の格子に並べ、どこが測られていてどこが空白かを示すことである。著者らはこの格子を InclusionMed Atlas と呼ぶ。役割が三つ、能力が三つで、九つの区画からなる[1]。abstract の範囲では、三つの役割と三つの能力がそれぞれ何を指すのかは書かれていない。
格子に入れるベンチマークは、構造化した監査と、独立した再現を経て選ぶ。公開されたベンチマークをそのまま並べるのではなく、中身を点検し、別の手で結果を再現できたものだけを採る、という手順である。これに、著者らが独自に作った非公開の診断推論ベンチマーク InclusionMed-DxFiles を加える。
各モデルの成績は InclusionMed Index という一つの指標にまとめられる。ただし Index は総合点だけでなく、役割ごと、能力ごとの点も報告する。一つの数字で順位を付けるための仕組みというより、区画ごとの違いを見せるための仕組みとして設計されている。著者らはこれを、共同作業と外部からの貢献で広げていく公開の取り組みと位置づけており、GitHub にリポジトリがある[2]。
3. 何を示したか ── abstract に書かれた範囲だけ
abstract に書かれた結果は、次の三点にまとまる[1]。
- 地図の空白:最初の公開版では、388 の候補から構造化した監査と独立した再現を経て、公開ベンチマーク四つを選んだ。非公開の DxFiles を加えて五つになるが、それでも九つの区画のうち覆えたのは三つだけである。
- 順位は見る区画で変わる:最先端の大規模言語モデルを評価した Index の総合点は、100 点満点で 17.5 から 49.1 の範囲だった。役割や能力ごとに見ると、モデルの順位は入れ替わった。
- 得意と不得意の向き:課題ごとのタグを使ったベンチマーク内の分析では、Index の上位十モデルはいずれも、臨床の意思決定より患者とのコミュニケーションで高い点を取った。Index の点が近いモデルどうしでも、推定した推論の費用には大きな差があった。
読みどころは一つめである。三百を超える候補から監査と再現を通ったものが四つしか残らず、それでも九区画の三つしか埋まらなかった。医療 AI の評価がどれほど偏っているかを、件数そのものが示している。総合点の上限が 49.1 にとどまったことも、測られている範囲の課題でさえ、モデルが十分にこなせていないことを示すと読める。
著者らはここから、より多様な医療の必要を覆う評価と、場面に応じたモデルの選択が必要だ、と結論している。この結論は、順位が区画で変わったという結果に支えられている。ただし「どのモデルをどの場面で使うべきか」の具体的な推奨は、abstract には書かれていない。
4. 具体例で見る
医療機関向けの情報提供を担う部署が、問い合わせ対応の下書きに使う言語モデルを選ぶ場面を考える。以下は説明のための仮定であり、論文の実験ではない。
総合点だけで選ぶ
公開されている順位表を見て、総合点がいちばん高いモデルを採る。選定の説明は簡単で、社内の稟議も通りやすい。ところが問い合わせの多くは、医療者が個々の患者について判断に迷った場面のものである。総合点を押し上げていたのが患者向けの説明のうまさだった場合、判断を支える回答の質は、総合点ほどには高くない。費用が同程度の別のモデルのほうが、この用途には合っていた可能性がある。
用途の区画で選ぶ
まず、自部署の仕事が役割と能力の格子のどこに当たるかを決める。その区画の点を比べ、推論の費用も並べる。その区画を覆うベンチマークが無ければ、無いことを記録し、自前の確認用の問題で補う。選定の説明は手間がかかるが、何を確かめて、何を確かめていないかが残る。後から誤りが見つかったとき、どこで判断を誤ったのかをたどれる。
二つの違いは、選ばれるモデルが変わるかどうかだけではない。評価の空白を知ったうえで選んだのか、知らずに選んだのかが記録に残るかどうかにある。InclusionMed の地図が役に立つのは、この空白を見える形にする点である。
5. 何が新しくないか/限界はどこか
医療向けの言語モデルを一つの試験ではなく多くの課題で評価する発想は、新しくない。MedHELM は臨床医が確かめた課題の分類を作り、多くのベンチマークでモデルを比べ、費用と性能の関係も分析していた[3]。InclusionMed の位置は、候補のベンチマークを監査と独立の再現でふるいにかけた点と、「包摂的な医療」という観点から役割と能力の格子を置き、空白を明示した点にある。
限界は abstract の範囲でもいくつか見える。第一に、九区画のうち六つは空白のままである。Index の総合点は、覆えている三区画だけの成績であり、医療 AI 全体の出来を表すものではない。第二に、五つのうち一つは非公開のベンチマークである。非公開にすれば学習データへの混入は防ぎやすいが、外部の者が問題の質を確かめることはできない。第三に、「包摂的」が何を意味するのか、たとえばどの国や言語、どの資源の水準の医療を想定しているのかは、abstract の範囲では示されていない。
第四に、患者とのコミュニケーションで点が高いという結果は、モデルの得意不得意を表しているとも、課題ごとの難しさの差を表しているとも読める。abstract はこの二つを区別していない。関連があることと、モデルの能力が原因であることは、別の事柄である。第五に、評価したモデルの名前、Index の重み付け、推論の費用の推定方法は、abstract には書かれていない。第六に、査読前である。この論文の範囲で言えるのは、著者らの監査を通ったベンチマークでは、医療 AI の評価に大きな空白があり、モデルの順位は見る区画で変わった、というところまでである。
6. この主題が今なぜ束になっているか
選定の記録では、この論文は束を作っていない。束のサイズは 1 で、同じ問いを扱う関連論文は記録されていない。採用されたのは、母集団の違う二つの系統が立ったためである。Hugging Face の論文ページでの upvote は 61、GitHub の star は 27 だった。upvote は読者が「読む価値がある」と投じた票であり、star は実装者が関心を示した数である。どちらも話題になったかどうかを示す数であって、評価の設計が正しいかどうかを示す数ではない。
キーワードには「診断推論ベンチマーク」「推論の費用」「課題ごとのタグ」が並ぶ。順位を一つ付けるよりも、どの課題で、どの費用で、どの程度できるのかを分けて示すことに関心が向いている。医療 AI の評価をめぐっては、試験問題の点数だけでは足りないという議論が以前から続いてきた[3]。今回の論文はその延長にあり、評価の範囲そのものを地図にした点が新しい。ただし束が 1 本である以上、主題として大きく立ち上がっていると言える段階ではない。
7. 製薬・規制の現場から見ると何が接続するか
製薬の現場に最も近いのは、言語モデルを選ぶときに「どの用途で確かめたのか」を残す、という考え方である。医療機関からの問い合わせへの対応、患者向けの資材の下書き、文献の要約など、製薬企業が言語モデルを試す用途は、役割も求められる能力も異なる。公開の順位表の総合点は、そのどれとも一致しない可能性がある。
WHO は医療での大規模マルチモーダルモデルについてのガイダンスで、包摂性の確保を倫理の原則の一つに挙げ、大規模に使われるモデルについては独立した第三者による監査や影響評価を求めている[4]。InclusionMed の監査と独立の再現という手順は、この考え方と方向が一致する。評価の空白を明示することも、どこまで確かめたかを説明する材料になる。
ただし、論文はこの接続を検証していない。評価は医療機関の側の役割を想定したものであり、製薬企業の業務での成績は示されていない。患者とのコミュニケーションで点が高かったことは、患者向けの情報提供にそのまま使ってよいことを意味しない。製薬企業が患者や医療者に向けて出す情報には、表現や根拠についての固有のルールがある。実務で使うなら、自社の用途が格子のどこに当たるかを決め、その区画の確認を自前で行い、確かめていない範囲を記録しておくことが前提になる。