法務 AI の会社 Ivo は 2026 年 10 月 1 日、契約の仕事向けに追加で訓練した AI モデル Ivo Sage を無償で公開し、契約の課題で採点項目の通過率が 0.701 から 0.913 に上がったと発表した。法務向け AI の「91%」は、契約の審査を任せてよい水準を示すのか。示さない。すべての採点項目を満たした契約の課題は 16.4% にとどまり、点をつけたのも AI だった。この点数で言えるのは、弁護士が見直す前の下書きの出来までである。
01Ivo Sage の 91% が測ったのは採点項目の通過率だけだ
Ivo は米サンフランシスコにある法務 AI の会社だ。Ivo Sage は、DeepSeek のモデル DeepSeek V4 Flash を土台にし、Ivo が契約の仕事向けに追加で訓練したモデルである。Ivo はこのモデルの重みを MIT ライセンスで公開した。誰でも無料で使え、手を加えることもできる。
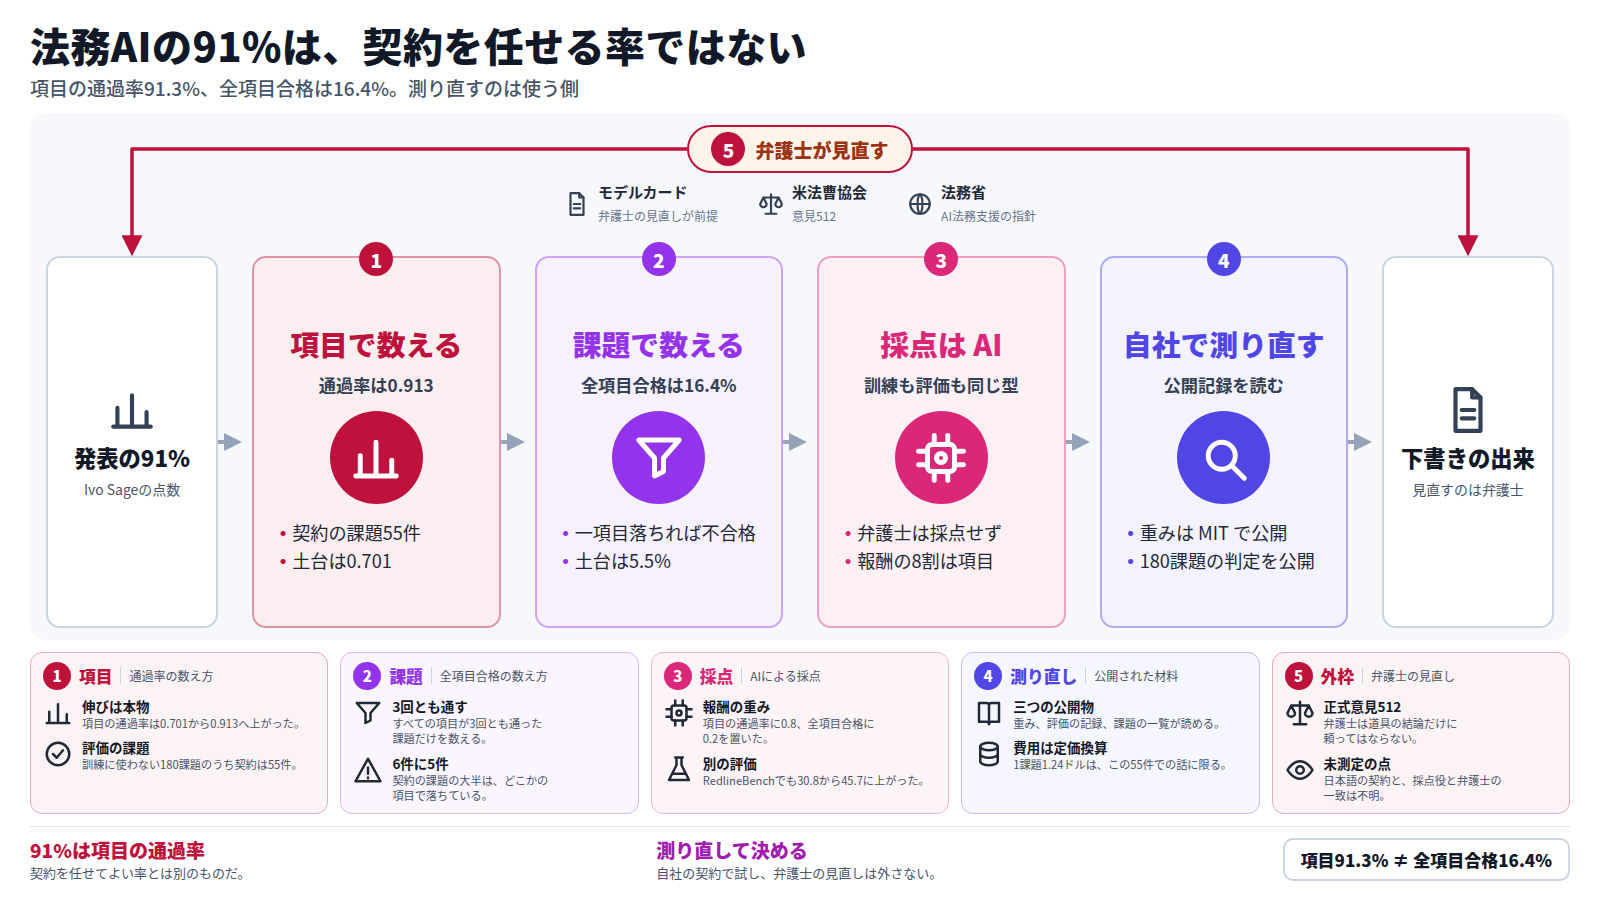
発表には二つの数字がある。Ivo Sage に契約の課題を解かせると、採点項目の 91.3% を満たした。ところが、一つの課題の項目をすべて満たせたのは、課題全体の 16.4% だった。点をつけたのは採点役の AI で、弁護士は採点していない。
私は、この点数で言えるのは、弁護士が見直す前の下書きの出来までだと考える。契約の審査に AI を入れたい人は、点数をうのみにせず、公開された記録を使って自社の契約で測り直すことになる。
0291.3% と 16.4% は、同じ採点の別の数え方
二つの数字は、同じ評価から出ている。違うのは数え方である。
Ivo は Hugging Face にモデルの説明書(モデルカード)を載せている。このモデルカードによると、Ivo は訓練に使っていない 180 の課題で Ivo Sage を試した。このうち 55 件が契約の課題である。採点役の AI は、課題ごとの採点基準に沿って、成果物を 3 回ずつ採点した。モデルカードでは、この採点役を LLM の判定者と呼んでいる。
91.3% は、採点基準に並ぶ項目のうち、合格した項目の割合である。16.4% は、全項目に合格した課題の割合だ。3 回採点し、そのすべてで全項目に合格した課題だけを数えている。項目が一つでも落ちれば、その課題は全項目合格に数えない。私は、全項目合格のほうが、成果物をそのまま弁護士に渡せるかに近い数え方だと考える。
Ivo Sage は DeepSeek V4 Flash をもとに作られた。DeepSeek V4 Flash を同じ課題で試すと、項目の合格率は 70.1%、全項目合格は 5.5% だった。Ivo Sage では、項目の合格率が 21 ポイント上がり、全項目合格の割合は 3 倍近くになった。伸びは本物である。それでも、契約の課題では 6 件のうち 5 件が、どこかの項目で落ちている。
評価に使った LAB は、法務 AI の会社 Harvey が公開している評価用の課題集だ。LAB は Legal Agent Benchmark の略で、実際の法務の仕事に近い課題で AI を試すために作られた。
03モデルカードと米法曹協会の文書によれば、契約の出力を見直すのは弁護士
契約の課題のうち、すべての項目を満たした課題は 16.4% しかなかった。残りの 8 割あまりの課題では、採点役の AI がどこかの項目を不合格とした。その箇所は人が見直す必要がある。契約の審査でその箇所を直すのは、弁護士である。
Ivo Sage のモデルカードには、用途として「資格のある弁護士が見直す成果物を作る」と書かれている。Ivo 自身が、弁護士の見直しを前提にしている。
米法曹協会は 2024 年 7 月 29 日、正式意見 512 を出した。生成 AI を使う弁護士に向けた意見である。National Law Review の要約によれば、弁護士は使う道具を見極め、その出力を確かめなければならない。道具の結論だけに頼ってもならない。意見 512 のもとでは、弁護士が自分の判断を AI に任せることも許されない。
日本では、法務省が 2026 年 8 月 21 日に、AI などで法務の仕事を助けるサービスについて新しいガイドラインを出した。このガイドラインは、AI による契約審査の支援が弁護士法 72 条とどう関係するかを扱う。私はガイドラインの本文をまだ読んでいないので、中身には立ち入らない。
ここで扱う範囲は、契約と法務の現場に限る。ほかの分野の審査に同じことが当てはまるかは、この記事の資料からは判断できない。
04Ivo Sage の訓練では、報酬の 8 割を項目の通過率が占めた
評価で点をつけたのは採点役の AI だった。訓練でも、採点役の AI が評価と同じやり方で答えに点をつけた。その点を報酬として使っている。
モデルカードによると、Ivo Sage は LAB の課題 1,040 個を使って強化学習で訓練された。強化学習では、モデルの答えに点をつけ、点が上がる方向へモデルを少しずつ変えていく。この訓練でも、答えに点をつけたのは採点役の AI だ。
報酬の式は、項目の通過率に 0.8、全項目に合格したかどうかに 0.2 の重みをかけている。このため、モデルは全項目の合格を狙うより、項目を一つでも多く通すほうが報酬を増やしやすい。
訓練の後、項目の通過率は 21 ポイント上がったが、全項目合格の割合は 16.4% にとどまった。報酬の 8 割を項目の通過率で決めていたのだから、この伸び方は意外ではない。ただし、重みが原因だと確かめた資料は無い。私に言えるのは、重みの配分から予想される伸び方と実際の伸び方が一致している、というところまでだ。
偏った見方にならないよう、別の数字も書いておく。訓練に使っていない RedlineBench という評価でも、Ivo Sage の点は 30.8 から 45.7 に上がった。この結果を見る限り、Ivo Sage は訓練の採点役 AI の好みに合わせただけで点を伸ばしたとは言えない。
05重みと 180 課題の記録を公開、利用者が採点を確かめられる
採点役の AI が付けた点数をうのみにしなくても、使う側には確かめる材料がある。Ivo は、評価の記録をまとめて公開した。
Hugging Face のデータセットには、検証に使った課題の一覧が載っている。課題ごとの作業記録と成果物、採点役の AI の判定も読める。Ivo Sage の重みは誰でもダウンロードできる。利用者は、土台となる DeepSeek V4 Flash にこの重みを足して使う。
重み
MIT ライセンスで誰でも使える。土台のモデルに足す追加の重みとして配られている。
評価の記録
検証に使った全課題について、作業記録と成果物、採点役の判定を読める。
課題の一覧
訓練と検証に使った課題の一覧も載っている。利用者は、自社の契約の仕事と重なるかを確かめられる。
モデルカードには、ほかのモデルとの比較も載っている。表の費用は、各モデルが使ったトークンの量を、各社の定価で金額に換算したものである。
| 見るところ | Ivo Sage | DeepSeek V4 Flash(土台) | Fable 5.1 |
|---|---|---|---|
| 項目の通過率 | 0.913 | 0.701 | 0.941 |
| 全項目合格 | 16.4% | 5.5% | 29.1% |
| 1 課題あたりの費用 | 1.24 ドル | 1.33 ドル | 142.39 ドル |
全項目に合格した割合は、Fable 5.1 が 29.1% で、Ivo Sage の倍に近い。その代わり、Fable 5.1 の 1 課題あたりの費用は 142.39 ドルで、Ivo Sage の 1.24 ドルの 100 倍を超える。同じ表で、GPT-6 Astra は全項目合格が Ivo Sage と同じ割合で、費用は 74.29 ドルだった。
この費用は定価で換算した額で、実際の契約の仕事でかかる額とは異なる。安い費用で同じ点を出せるというのは、あくまでこの 55 件の課題に限った話である。
06点数は数え方で変わり、採点したのも AI。自社で試す材料は公開されている
モデルの重みも作業記録も費用の表も、すべて公開された。ここまでの節で示した事実をもとに、点数の読み方について三つのことを述べる。
発表の「91%」を見たら、まず数え方を確かめる
対象は同じ 55 の契約課題である。項目単位で数えた通過率は 0.913 で、全項目に合格した課題の割合は 16.4% だった。どちらの数字を見出しに使うかで、読む人の受け取り方は大きく変わる。法務 AI の点数を見たら、項目で数えたのか、課題で数えたのかを先に確かめる。数え方が分かるまで、点数は比べられない。
点数は、採点役の AI がつけたものである
評価の点数をつけたのも、訓練で与える報酬を決めたのも、採点役の AI である。読む側は、この点数と、弁護士が合格と判断した割合とを区別して扱う必要がある。採点役の AI が下した判定も、道具が出した結論の一つだ。米法曹協会は正式意見 512 で、道具の結論だけに頼らないよう弁護士に求めている。
導入を決める前に、自社の契約で同じ評価を試せる
Ivo が公開したのは、モデルの重み、作業記録、採点の判定である。これを使えば、導入を考える会社は、同じ評価を自社の契約で実行できる。Ivo の CEO、Min-Kyu Jung は発表で、法務チームの文書や手引き、仕事の進め方をモデルに渡せば良い成果が出ると述べている。自社の契約で試せば、渡した文書の内容がモデルの出力に表れているかどうかも、会社が自ら確かめられる。
07日本語の契約と自社の型での正確さは、公開資料に数字がない
測り直すための材料は公開された。それでも、Ivo Sage には公開資料で測られていない点が残っている。
Ivo Sage は英語だけで訓練された。日本語の契約でどれだけ正確かは、モデルカードに書かれていない。導入する会社が使う契約の型に Ivo Sage が合うかどうかも、まだ分からない。社内の雛形や、社内でこれまで加えてきた修正の癖を Ivo Sage が拾えるかどうかを示した資料も無い。
採点役の AI の判定と、人の弁護士の判定がどれだけ一致するかも、モデルカードには書かれていない。技術報告書の中身までは、私は読んでいない。
日本語の契約
訓練は英語だけで、日本語の契約での点数は示されていない。
採点役と弁護士の一致
採点役の AI の判定と、人の弁護士の判定の一致度は、モデルカードに書かれていない。
日本の会社が Ivo Sage を契約の審査に試すなら、自社で日本語の契約を使い、一から測ることになる。日本の会社がそうして測った結果は、私がこの記事のために調べた資料には見当たらなかった。
次に私は、採点役の AI の判定と弁護士の判定を突き合わせた数字を探す。それが見つかれば、採点役の AI がつけた 91% という点を、弁護士の採点と並べて比べられる。
- 契約の課題で、Ivo Sage は採点項目の 91.3% を満たした。一方、すべての項目を満たした課題の割合は 16.4% だった。発表された数字を見たら、まず何を対象に、どう数えたのかを確かめる。
- 評価の点数も訓練の報酬も、採点役の AI がつけた。報酬の 8 割分は、満たした項目の割合で決まった。この点数は、弁護士が下す合否とは別物として読む。
- Ivo はモデルの重みと、検証に使った全課題の作業記録と判定を公開した。導入するかどうかは、自社の契約で測り直したうえで決められる。
91% という点を見て、法務向け AI に契約の審査を任せてよいと判断することはできない。この 91% は、採点役の AI が項目ごとにつけた点である。すべての項目を満たした契約の課題は、先に挙げた割合にとどまった。
導入は自社の契約で測り直してから決める。測り直した後も、弁護士による見直しは外さない。私は AI の点数を見たら、まず誰がどう数えたかを確かめる。
- LawFuel. Legal AI – Ivo Becomes The First Legal AI Company to Publish a Free Open-Source Model Post-Trained for Long-Horizon Contract Work. 2026-10-01.
- Ivo AI. Ivo Sage(Hugging Face のモデルカード). 2026-10-01.
- Ivo AI. Ivo Sage training artifacts(Hugging Face のデータセット). 2026-10-01.
- Harvey. harvey-labs: Legal Agent Benchmark (LAB). GitHub, 2026-10-05 閲覧.
- The National Law Review. American Bar Association Issues Formal Opinion on Use of Generative AI Tools. 2024-08-14.
- 法務省. 弁護士法(その他)── AI等法務業務支援サービス. 2026-08-21.