১. বুকের এক্স-রের কিছু রিড শুধু দেখে নিশ্চিত করা যায় না
বুকের এক্স-রে পড়া মানে শুধু যা দেখা যাচ্ছে তার নাম বলা নয়। অ্যাবস্ট্র্যাক্টটি এই বিন্দু থেকেই শুরু হয়। ব্যাখ্যার জন্য প্রায়ই শুধু সরাসরি চাক্ষুষ শনাক্তকরণের ওপর নির্ভর না করে, দৃশ্যমান findings-কে কাজ-নির্দিষ্ট প্রমাণের সঙ্গে মেলাতে হয়।[১]
টুল-সহায়িত মেডিকেল এজেন্ট এর একটি উত্তর হয়ে এসেছে। এজেন্ট কাজের কিছু অংশ বাহ্যিক মডিউলের হাতে তুলে দেয়, যেমন কাছ থেকে দেখার জন্য একটি অঞ্চল ক্রপ করা বা আকার মাপতে একটি অঙ্গ সেগমেন্ট করা, এবং তারপর ফলাফল নিজের যুক্তির সঙ্গে মিলিয়ে নেয়। বুকের এক্স-রের জন্য, আগের একটি কাজ বহু-ধাপের যুক্তির জন্য এমন টুল শৃঙ্খলবদ্ধ করা একটি এজেন্টের প্রস্তাব দিয়েছিল, সঙ্গে ChestAgentBench নামে একটি মূল্যায়ন সেটও।[৩]
টুল কল করতে পারা আর ভালোভাবে কল করতে পারা এক নয়। লেখকেরা বিদ্যমান এজেন্টগুলোর দুটি ঘাটতির কথা বলেছেন। প্রথমত, কখন সহায়ক প্রমাণ সত্যিই প্রয়োজন, তা শেখার কোনো সুস্পষ্ট ব্যবস্থা এগুলোর নেই। দ্বিতীয়ত, ছবির ক্ষেত্রে প্রযোজ্য নয় এমন পরিমাণগত প্রমাণকে রোগনির্ণয়ের যুক্তিতে ঢুকতে বাধা দেওয়ার কোনো উপায় এগুলোর নেই। প্রথম ঘাটতির ফলে টুল হয় অতিরিক্ত কল করা হয়, নয়তো একেবারেই করা হয় না। দ্বিতীয়টি আরও ঝুঁকিপূর্ণ: একটি সংখ্যা শুধু সংখ্যা হওয়ার কারণেই ভুল সিদ্ধান্তকে ওজন দিতে পারে।
2. মূল ধারণা: প্রমাণ অনুসন্ধান ও পরিমাপ গ্রহণকে আলাদা করা
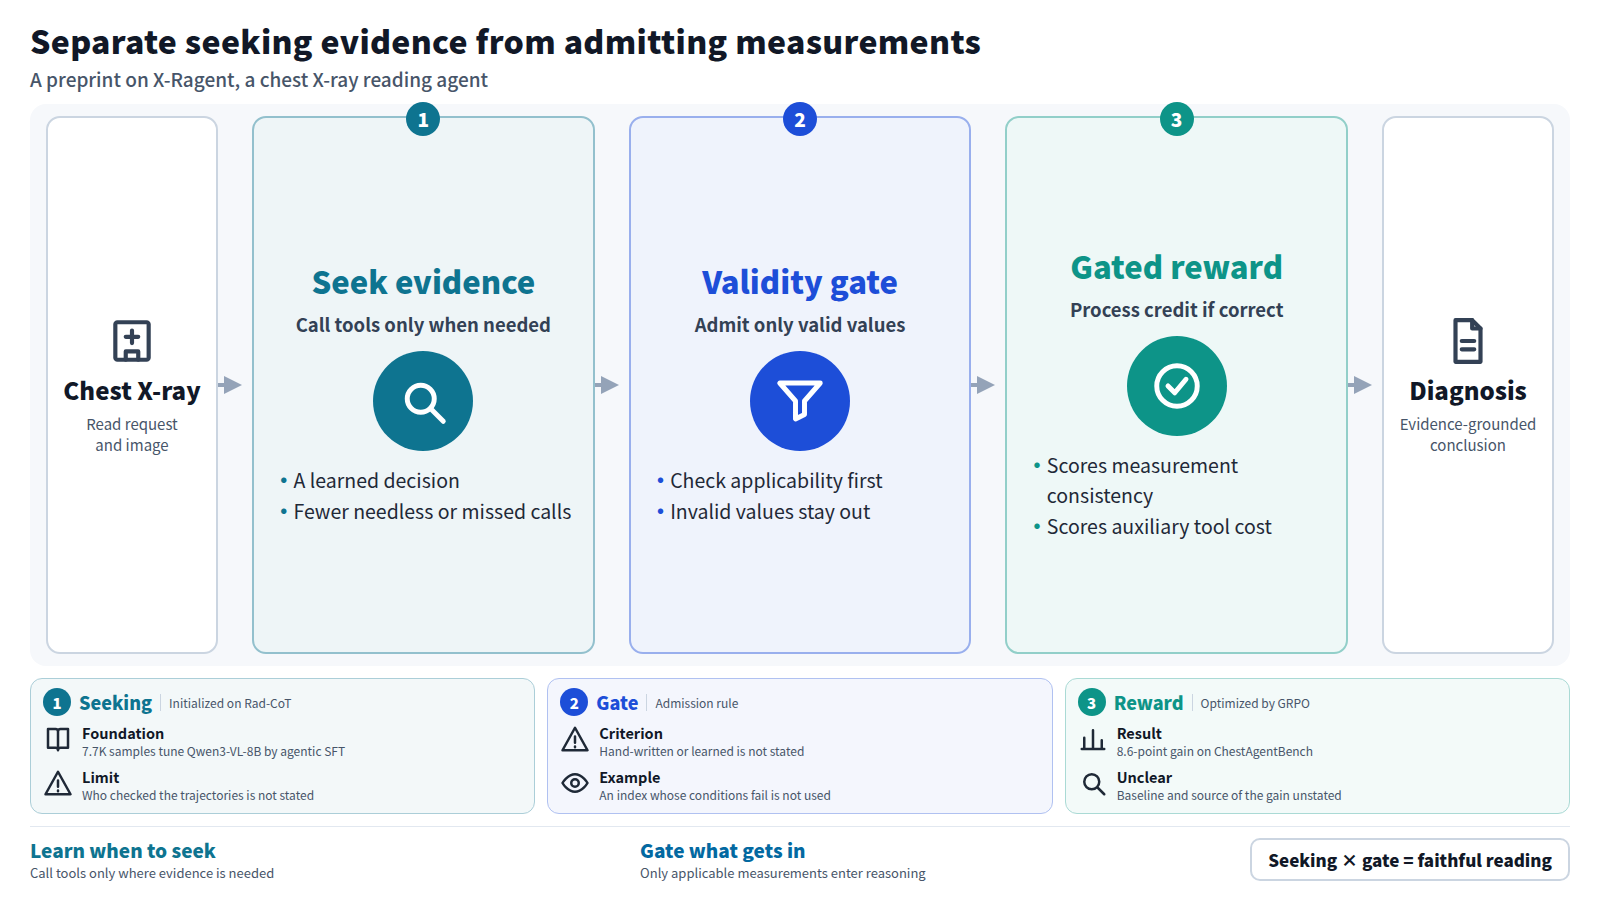
X-Ragent হলো টুল-সহায়িত রিইনফোর্সমেন্ট লার্নিংয়ের জন্য একটি পোস্ট-ট্রেনিং কাঠামো। এর মূল নকশাগত সিদ্ধান্ত হলো দুটি আচরণকে আলাদা করা। একটি হলো সহায়ক প্রমাণ খুঁজতে যাওয়া হবে কি না তা ঠিক করা, যা মডেল শেখে। অন্যটি হলো একটি বৈধতা-ফটক, যা পরিমাণগত মাপ এই ছবিতে প্রযোজ্য কি না তা যাচাই করে, তারপর মাপটিকে যুক্তিতে ঢুকতে দেওয়া হয়। প্রথমটি শেখা সিদ্ধান্ত; দ্বিতীয়টি সংখ্যার জন্য প্রবেশাধিকারের নিয়ম।
প্রশিক্ষণ দুই ধাপে হয়। লেখকরা প্রথমে Rad-CoT নামে 7.7K নমুনার একটি কর্পাস তৈরি করেন, যেখানে কার্যকারণ-ক্রমে সাজানো টুল-ব্যবহারের ট্রাজেক্টরির সঙ্গে রেডিওলজি রিপোর্টের ধাঁচে লেখা রোগনির্ণয়ভিত্তিক যুক্তি জোড়া থাকে। এটি দিয়ে তারা এজেন্টিক সুপারভাইজড ফাইন-টিউনিংয়ের মাধ্যমে Qwen3-VL-8B শুরু করেন।
এরপর তারা Group Relative Policy Optimization (GRPO) দিয়ে নীতি অপ্টিমাইজ করে। এটি একটি বিদ্যমান পদ্ধতি, যা একই প্রশ্নের একাধিক উত্তর নমুনা হিসেবে নেয় এবং প্রতিটি উত্তর গোষ্ঠীর বাকিদের সঙ্গে কেমন তুলনীয় তা থেকে শেখে।[৪] অবদানটি পুরস্কারে নিহিত। প্রক্রিয়া-পর্যায়ের দুটি পদ—একটি পরিমাপের সামঞ্জস্যের জন্য, অন্যটি সহায়ক টুল ব্যবহারের খরচের জন্য—শুধু সেই ট্রাজেক্টরিতে প্রয়োগ করা হয় যাদের রোগনির্ণয় সঠিক। লেখকেরা একে অ্যাকুরেসি-গেটেড রিওয়ার্ড বলেন। এর উদ্দেশ্য হলো, বিশ্বাসযোগ্য দেখতে প্রক্রিয়াগত আচরণ যেন ভুল রোগনির্ণয়ের ক্ষতিপূরণ করতে না পারে।
৩. সারসংক্ষেপে কী জানানো হয়েছে
- ডেটা: Rad-CoT, 7.7K নমুনা, যেখানে টুল-ব্যবহারের গতিপথ এবং রিপোর্ট-ধাঁচের যুক্তি একত্র করা হয়েছে।
- প্রশিক্ষণ: Qwen3-VL-8B-কে এজেন্টিক SFT দিয়ে শুরু করা হয়েছে, তারপর নির্ভুলতা-নিয়ন্ত্রিত পুরস্কারের অধীনে GRPO দিয়ে অপ্টিমাইজ করা হয়েছে।
- ফলাফল: তিনটি বুকের এক্স-রে বেঞ্চমার্কে সবচেয়ে শক্তিশালী ফলাফল, যার মধ্যে ChestAgentBench-এ 8.6 পয়েন্টের উন্নতি রয়েছে, যেটি প্রশিক্ষণ থেকে সম্পূর্ণ বাদ রাখা হয়েছিল।
- লেখকদের পাঠ: বেছে বেছে প্রমাণ খুঁজে এবং শুধু বৈধ পরিমাপ গ্রহণ করে, সিস্টেমটি আরও বিশ্বস্ত, প্রমাণভিত্তিক যুক্তিকে সমর্থন করে।
কয়েকটি বিষয় যাচাই করা দরকার। অ্যাবস্ট্র্যাক্টে বলা নেই ৮.৬ পয়েন্টের উন্নতি কীসের তুলনায় মাপা হয়েছে, বেস মডেল নাকি অন্য কোনো এজেন্ট। এটি তিনটি বেঞ্চমার্কের মাত্র একটির নাম উল্লেখ করেছে। "সবচেয়ে শক্তিশালী ফলাফল" নির্ভর করে তুলনার জন্য কোন সিস্টেমগুলো বেছে নেওয়া হয়েছে তার ওপর। আর রিওয়ার্ড ডিজাইনের কোন অংশ উন্নতির কারণ, তা অ্যাবস্ট্র্যাক্টে দেখানো হয়নি।
4. একটি বাস্তব উদাহরণ: কোনো পরিমাপ ব্যবহার না করার সিদ্ধান্ত
অপ্রযোজ্য পরিমাপ বলতে কী বোঝায় তা বুঝতে একটি পাঠ-পরিস্থিতি বিবেচনা করুন। এই উদাহরণটি ধারণাটি ব্যাখ্যা করে; পেপারটি এই পরিস্থিতি কভার করে কি না তা অ্যাবস্ট্রাক্ট থেকে নির্ধারণ করা যায় না। বুকের এক্স-রেতে রোগীর অবস্থান ও রশ্মির দিক হৃৎপিণ্ডের চেহারা বদলে দেয়, এবং হৃৎপিণ্ডের আকারের একটি প্রচলিত সূচক প্রতিটি ছবির জন্য বৈধ নাও হতে পারে।
অনুরোধ: এই বুকের এক্স-রেতে কার্ডিওমেগালি আছে কি না, তা মূল্যায়ন করুন।
এজেন্ট: (ছবি পরীক্ষা করছে) ফুসফুসের ক্ষেত্র ও মিডিয়াস্টিনাম দেখছি। হৃদপিণ্ডের ছায়ারেখার জন্য আকারের পরিমাপ সহায়ক হবে, তাই পরিমাপ টুলটি ডাকব।
এজেন্ট: (গেট যাচাই করছে) ধারণের পরিস্থিতি এই সূচকের পেছনের অনুমানগুলো পূরণ করে না। পরিমাপটি যুক্তিপ্রক্রিয়ায় ঢুকবে না।
এজেন্ট: সংখ্যাটি ছাড়াই আমি দৃশ্যমান লক্ষণ থেকে বিচার করব, এবং পরিমাপটি প্রত্যাখ্যাত হয়েছে তা নথিভুক্ত করব।
মূল কথা হলো, একটি টুল ডাকা এবং তার আউটপুট গ্রহণ করা আলাদা দুটি ধাপ। রিওয়ার্ডও একই বিভাজন করে। দুটি প্রশিক্ষণ সংকেত পাশাপাশি রাখলে পার্থক্যটি বোঝা যায়।
প্রক্রিয়া পুরস্কার সবসময় যুক্ত
রোগনির্ণয় ভুল হলেও সতর্ক পরিমাপ ও সাশ্রয়ী সরঞ্জাম ব্যবহারে এখনও পয়েন্ট মেলে। ভুল উত্তরে পৌঁছালেও পদ্ধতিগত দেখানোর জন্য একটি গতিপথকে শক্তিশালী করা যেতে পারে।
নির্ভুলতা-নিয়ন্ত্রিত পুরস্কার (X-Ragent)
পরিমাপের সামঞ্জস্য ও টুলের খরচ কেবল সেই ট্রাজেক্টরিগুলোর জন্য স্কোর করা হয় যেখানে রোগ নির্ণয় সঠিক। ভুল রোগ নির্ণয়ে ধাপগুলো যত গোছানোই হোক, প্রক্রিয়ার জন্য কোনো নম্বর মেলে না। আগে সিদ্ধান্তটি সঠিক হতে হবে।
৫. যা নতুন নয়, এবং সীমাবদ্ধতা কোথায়
যা নতুন নয় তা দিয়ে শুরু করা যাক। টুল-ব্যবহারকারী চিকিৎসা এজেন্ট আগের কাজেও ছিল, এবং ChestAgentBench নিজেও সেরকম কাজ থেকেই এসেছে।[৩] GRPO একটি প্রতিষ্ঠিত পদ্ধতি, আর তত্ত্বাবধানকৃত ফাইন-টিউনিংয়ের পর রিইনফোর্সমেন্ট লার্নিং চালানো ভাষা-মডেলের পোস্ট-ট্রেনিংয়ে একটি প্রচলিত ধরন। নতুন অংশ হলো প্রমাণ খোঁজা ও পরিমাপ গ্রহণের বিভাজন, এবং সেই পুরস্কার যা প্রক্রিয়াগত স্বীকৃতি শুধু সঠিক ট্রাজেক্টরিতে সীমাবদ্ধ রাখে।
বেশ কয়েকটি সীমাবদ্ধতা রয়েছে। প্রথমত, কোনো পরিমাপ প্রযোজ্য কি না তার মানদণ্ড। অ্যাবস্ট্র্যাক্টে বলা নেই গেটটি কী দেখে, বা তার নিয়মগুলো মানুষ লিখেছে নাকি শেখা হয়েছে। কীভাবে তৈরি হয়েছে তার ওপর নির্ভর করে, এটি রেডিওলজিস্টের বিচারের সঙ্গে ভিন্নমত হতে পারে।
দ্বিতীয়ত, মূল্যায়নের পরিধি। বেঞ্চমার্কের স্কোর সাধারণত কাঠামোবদ্ধ প্রশ্নে নির্ভুলতা। অ্যাবস্ট্র্যাক্টে সম্পূর্ণ রিপোর্টের মান, কোন ধরনের ফলাফল বাদ পড়েছে, বা ক্লিনিক্যাল সিদ্ধান্তের ওপর প্রভাব সম্পর্কে কিছু বলা নেই, আর তিনটি বেঞ্চমার্কের পেছনের হাসপাতাল বা ইমেজিংয়ের পরিস্থিতিও বর্ণনা করা হয়নি।
তৃতীয়ত, Rad-CoT নির্মাণ। ট্র্যাজেক্টরিগুলোকে কার্যকারণ ক্রমে সাজানো বলে বর্ণনা করা হয়েছে, কিন্তু অ্যাবস্ট্র্যাক্টে বলা নেই কে বা কীভাবে সেগুলো যাচাই করেছে। প্রশিক্ষণের যুক্তিতে যে পক্ষপাতই থাকুক, মডেল তার সঙ্গে সেটিও শিখে নেবে।
চতুর্থত, পুনরুৎপাদনযোগ্যতা। নির্বাচিত ডেটায় GitHub স্টারের সংখ্যা শূন্য এবং কোনো পাবলিক রিপোজিটরি নেই। কোড বা ডেটা পাওয়া যায় কি না, এই নিবন্ধে তা নিশ্চিত করা হয়নি।
6. কেন এটি নজর কেড়েছে, আর কেন ক্লাস্টারটি এখনও ছোট
নির্বাচন পাইপলাইন এই গবেষণাপত্রটিকে Reasoning & Learning-এর অধীনে রেখেছে। এর ক্লাস্টারের আকার 1: এই সংগ্রহ-সময়কালে একই প্রশ্নে আর কোনো গবেষণাপত্র পাওয়া যায়নি, এবং একমাত্র যে সংকেতটি সক্রিয় হয়েছে তা হলো Hugging Face পেপার পেজের ভোট, যেখানে 67টি আপভোট, 1টি মন্তব্য এবং 0টি GitHub স্টার রয়েছে।[২] আপভোট দেখায় যে গবেষকেরা পেপারটি লক্ষ্য করেছেন। এর দাবিগুলো টেকে কি না বা এর ক্লিনিক্যাল মূল্য আছে কি না, সে বিষয়ে এগুলো কিছু বলে না।
গবেষণাপত্রটির কীওয়ার্ডগুলো থেকে এখনো বোঝা যায় এটি কোথায় অবস্থান করে: টুল-সমৃদ্ধ রিইনফোর্সমেন্ট লার্নিং, GRPO, এজেন্টিক সুপারভাইজড ফাইন-টিউনিং, প্রমাণভিত্তিক যুক্তি। সাম্প্রতিক এজেন্ট গবেষণায় এই শব্দগুলো বারবার আসে। এই সাইট সম্প্রতি এমন গবেষণাপত্র নিয়ে লিখেছে যেখানে এজেন্ট প্রমাণ সম্পূর্ণ হওয়ার আগেই কাজ করে, এবং যেখানে এজেন্টের কাজের ভিত্তি মানুষকে দেখানো হয়।
X-Ragent এই ধারার কাজকে একটি নির্দিষ্ট ক্ষেত্রে, চিকিৎসা ইমেজিংয়ে, নিয়ে এসেছে। প্রশ্নটি এখন "এজেন্ট কি টুল ব্যবহার করতে পারে?" থেকে সরে "টুল যা ফেরত দেয় তা কখন বিশ্বাস করা উচিত?"-তে এসেছে। তবে একটি গবেষণাপত্র দিয়ে একটি বিষয় তৈরি হয় না। এই দিকটি একটি গুচ্ছে পরিণত হবে কি না, তা আগামী কয়েক সপ্তাহে লক্ষ্য রাখার বিষয়।
7. ওষুধ ও নিয়ন্ত্রক অনুশীলনের সঙ্গে এর সংযোগ কোথায়
চিত্র-নির্ণয়ে সহায়তাকারী সফটওয়্যারকে চিকিৎসা সরঞ্জাম হিসেবে নিয়ন্ত্রণ করা যেতে পারে। এর মূল্যায়নে শুধু কার্যকারিতার সংখ্যা নয়, কোন শর্তে এটি ব্যবহার করা যাবে আর কোন শর্তে যাবে না, তাও অন্তর্ভুক্ত। প্রযোজ্য নয় এমন পরিমাপকে যুক্তির ধারা থেকে বাইরে রাখার ধারণাটি ব্যবহারের শর্তের এই ধারণার সঙ্গে মেলে। যে ব্যবস্থা ঠিক করে কখন একটি পরিমাপ-সরঞ্জাম প্রযোজ্য নয় এবং সেই সিদ্ধান্ত লিপিবদ্ধ করে, সে এমন উপাদান তৈরি করে যা ব্যাখ্যাকে সমর্থন করতে পারে।
নির্ভুলতা-নির্ভর পুরস্কার ব্যবস্থা একটি মান-নিশ্চিতকরণ নীতির মতোও দেখায়। পদ্ধতি অনুসরণ করা মানেই সঠিক ফলাফল পাওয়া নয়। ফলাফল সঠিক কি না তা নিশ্চিত করার পরই পদ্ধতির মূল্যায়ন করা হয়। উৎপাদন ও পরীক্ষায় যা নিয়মিত চর্চা, এখানে তা পুরস্কার নকশা হিসেবে নতুন করে লেখা হয়েছে।
প্রিপ্রিন্টের বেঞ্চমার্ক ফলাফলকে ক্লিনিক্যাল কার্যকারিতা হিসেবে পড়া যায় না। ওষুধ কোম্পানিগুলো সম্ভবত এই ধরনের প্রযুক্তির মুখোমুখি হবে ক্লিনিক্যাল ট্রায়ালে ছবি পাঠে সহায়তায়, অথবা সেই পাঠগুলোর সামঞ্জস্য যাচাইয়ে। সেখানেও কোন পরিমাপ গৃহীত হয়েছে আর কোনটি বাতিল হয়েছে, তার রেকর্ড রাখতে হবে, চূড়ান্ত সিদ্ধান্ত চিকিৎসকদের হাতেই থাকতে হবে, এবং রেকর্ড পরবর্তী পর্যালোচনার জন্য উন্মুক্ত থাকতে হবে। বাস্তবে যা কাজে লাগে তা কোনো নির্দিষ্ট সংখ্যা নয়, বরং নকশার ধারণাটি: প্রমাণ খোঁজা আর প্রমাণ গ্রহণ করাকে দুটি আলাদা সিদ্ধান্ত হিসেবে দেখা।