1. بعض قراءات الأشعة السينية للصدر لا يمكن حسمها بالنظر وحده
قراءة صورة الأشعة السينية للصدر ليست مجرد تسمية ما هو مرئي. يبدأ الملخص من هذه النقطة. فالتفسير يتطلب غالبًا الجمع بين الملاحظات البصرية والأدلة الخاصة بالمهمة، بدلًا من الاعتماد على التعرف البصري المباشر وحده.[1]
كان الوكلاء الطبيون المعزَّزون بالأدوات أحد الحلول لذلك. فالوكيل يسلّم أجزاء من العمل إلى وحدات خارجية، مثل اقتطاع منطقة لفحصها عن كثب أو تجزئة عضو لقياس حجمه، ثم يدمج النتائج في استدلاله. وبالنسبة للأشعة السينية للصدر، اقترحت أعمال سابقة وكيلًا يربط مثل هذه الأدوات للاستدلال متعدد الخطوات، إلى جانب مجموعة تقييم تسمى ChestAgentBench.[3]
القدرة على استدعاء الأدوات لا تعني استدعاءها بشكل جيد. يحدد المؤلفون فجوتين في الوكلاء الحاليين. أولًا، تفتقر إلى آلية صريحة لتعلّم متى تكون الأدلة المساعدة مطلوبة فعلًا. ثانيًا، تفتقر إلى وسيلة لمنع الأدلة الكمية التي لا تنطبق على الصورة من الدخول في الاستدلال التشخيصي. تؤدي الأولى إلى الإفراط في استدعاء الأدوات أو عدم استدعائها إطلاقًا. أما الثانية فهي أكثر خطورة: فقد يمنح الرقم وزنًا لاستنتاج خاطئ لمجرد أنه رقم.
2. الفكرة الأساسية: الفصل بين البحث عن الأدلة وقبول القياسات
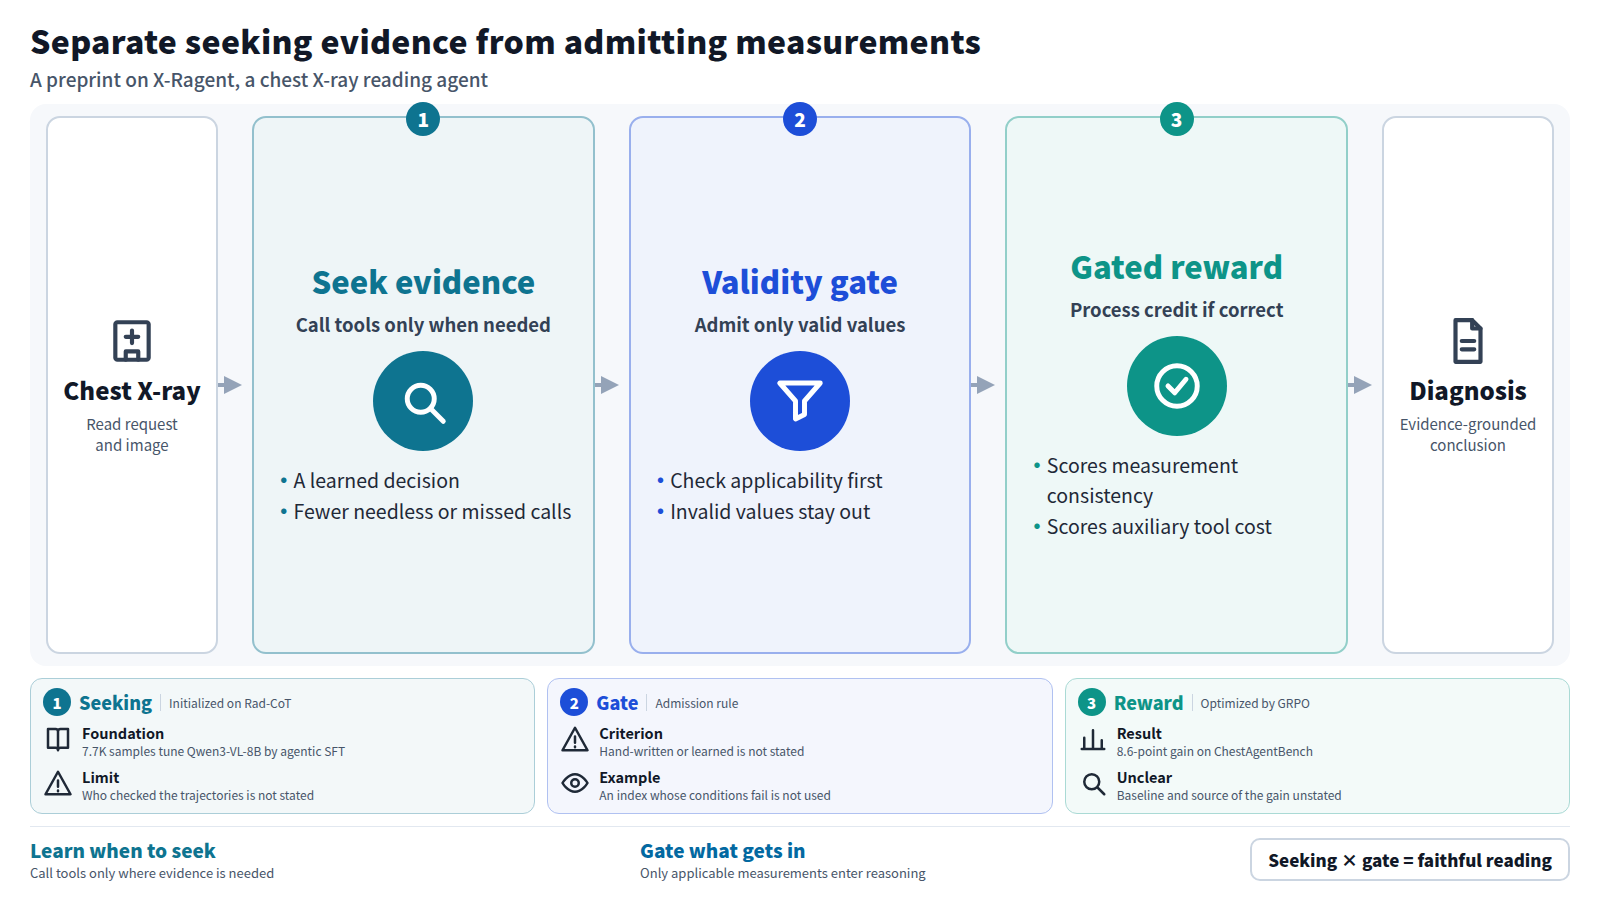
X-Ragent هو إطار لما بعد التدريب في التعلم المعزز المعزَّز بالأدوات. يقوم خياره التصميمي المحوري على فصل سلوكين. الأول هو تقرير ما إذا كان ينبغي البحث عن أدلة مساعدة، وهذا ما يتعلمه النموذج. والثاني هو بوابة صلاحية تتحقق مما إذا كان القياس الكمي ينطبق على هذه الصورة قبل السماح بإدخاله في عملية الاستدلال. الأول قرار متعلَّم، والثاني قاعدة قبول للأرقام.
يتكون التدريب من مرحلتين. يبني المؤلفون أولًا Rad-CoT، وهي مجموعة بيانات من 7.7K عينة تقرن مسارات استخدام الأدوات المرتبة سببيًا باستدلال تشخيصي مكتوب بأسلوب تقرير الأشعة. ثم يستخدمونها لتهيئة Qwen3-VL-8B عبر الضبط الدقيق الخاضع للإشراف بأسلوب الوكلاء.
ثم يحسّنون السياسة باستخدام Group Relative Policy Optimization (GRPO)، وهي طريقة قائمة تأخذ عينات من عدة إجابات للسؤال نفسه وتتعلم من مقارنة كل إجابة ببقية المجموعة.[4] تكمن المساهمة في المكافأة. فحدّان على مستوى العملية، أحدهما لاتساق القياس والآخر لتكلفة استخدام الأدوات المساعدة، يُطبَّقان فقط على المسارات التي يكون تشخيصها صحيحًا. يسمي المؤلفون ذلك مكافأة مشروطة بالدقة. وغايتها منع السلوك الذي يبدو معقولًا في العملية من تعويض تشخيص خاطئ.
3. ما يورده الملخص
- البيانات: Rad-CoT، 7.7K عينة تجمع بين مسارات استخدام الأدوات واستدلال بأسلوب التقارير.
- التدريب: نموذج Qwen3-VL-8B مُهيَّأ بضبط دقيق خاضع للإشراف الوكيلي (agentic SFT)، ثم مُحسَّن باستخدام GRPO في ظل مكافأة مشروطة بالدقة.
- النتائج: أقوى النتائج عبر ثلاثة اختبارات معيارية للأشعة السينية للصدر، بما في ذلك تحسّن بمقدار 8.6 نقطة في ChestAgentBench، الذي استُبعد كليًا من التدريب.
- قراءات المؤلفين: من خلال البحث عن الأدلة بشكل انتقائي وقبول القياسات الصالحة فقط، يدعم النظام استدلالًا أكثر دقة وقائمًا على الأدلة.
هناك عدة أمور تستحق التحقق. فالملخص لا يوضح ما الذي يُقاس به تحسّن الـ8.6 نقطة، أهو النموذج الأساسي أم وكيل آخر. ولا يسمّي سوى واحد من معايير الأداء الثلاثة. كما أن "أقوى النتائج" تعتمد على الأنظمة التي اختيرت للمقارنة. ولا يبيّن الملخص أي جزء من تصميم المكافآت يفسّر هذا التحسن.
4. مثال عملي: قرار عدم استخدام قياس ما
لفهم ما يعنيه القياس غير القابل للتطبيق، لنتأمل سيناريو قراءة واحدًا. هذا المثال يوضح الفكرة؛ أما هل تغطي الورقة هذه الحالة فلا يمكن تحديده من الملخص. في الأشعة السينية للصدر، يغيّر وضع المريض واتجاه الشعاع مظهر القلب، وقد لا يكون المؤشر القياسي لحجم القلب صالحًا لكل صورة.
الطلب: قيّم ما إذا كانت هذه الأشعة السينية للصدر تُظهر تضخم القلب.
الوكيل: (يفحص الصورة) مراجعة الحقلين الرئويين والمنصف. سيفيد قياس الحجم في تقييم ظل القلب، لذا سأستدعي أداة القياس.
الوكيل: (يفحص البوابة) ظروف الالتقاط لا تستوفي الافتراضات التي يقوم عليها هذا المؤشر. لن يدخل القياس في عملية الاستدلال.
الوكيل: سأحكم بناءً على النتائج المرئية دون الرقم، وسأسجّل أن القياس قد رُفض.
المغزى أن استدعاء أداة وقبول مخرجاتها خطوتان منفصلتان. والمكافأة تفصل بينهما بالطريقة نفسها. ووضع إشارتَي التدريب جنبًا إلى جنب يُظهر الفرق.
مكافأة العملية تُضاف دائمًا
حتى عندما يكون التشخيص خاطئًا، يظل القياس الدقيق والاستخدام الاقتصادي للأدوات يكسبان نقاطًا. فقد يُعزَّز مسار ما لأنه يبدو منهجيًا رغم وصوله إلى إجابة خاطئة.
مكافأة مشروطة بالدقة (X-Ragent)
لا يُحتسب اتساق القياس وتكلفة الأدوات إلا للمسارات ذات التشخيص الصحيح. التشخيص الخاطئ لا ينال أي درجة على العملية مهما كانت الخطوات مرتبة. يجب أن يكون الاستنتاج صحيحًا أولًا.
5. ما ليس جديدًا وأين تكمن الحدود
لنبدأ بما ليس جديدًا. فالوكلاء الطبيون الذين يستخدمون الأدوات موجودون في أعمال سابقة، وقد جاء ChestAgentBench نفسه من أعمال كهذه.[3] GRPO طريقة راسخة، وتشغيل التعلم المعزز بعد الضبط الدقيق الخاضع للإشراف نمط شائع في مرحلة ما بعد التدريب للنماذج اللغوية. الجديد هو الفصل بين طلب الأدلة وقبول القياسات، والمكافأة التي تقصر ائتمان العملية على المسارات الصحيحة.
هناك عدة حدود. أولًا، معيار انطباق القياس. لا يوضح الملخص ما الذي تنظر إليه البوابة، ولا ما إذا كانت قواعدها كُتبت بواسطة أشخاص أم تم تعلمها. وبحسب طريقة بنائها، قد تختلف مع حكم اختصاصي الأشعة.
ثانيًا، نطاق التقييم. عادةً ما تكون درجات معايير الأداء دقةَ الإجابة عن أسئلة منظَّمة. ولا يذكر الملخص شيئًا عن جودة التقارير الكاملة، ولا عن أنواع النتائج التي فاتت، ولا عن الأثر في القرارات السريرية، كما لا يصف المستشفيات أو ظروف التصوير التي تقوم عليها معايير الأداء الثلاثة.
ثالثًا، بناء Rad-CoT. توصف المسارات بأنها مرتبة سببيًا، لكن الملخص لا يذكر من تحقق منها ولا كيف. وأيًّا كانت التحيزات التي يتضمنها استدلال التدريب، فإن النموذج سيتعلمها معه.
رابعًا، قابلية إعادة الإنتاج. تُظهر بيانات الاختيار صفر نجمة على GitHub وعدم وجود مستودع عام. ولم يتأكد هذا المقال من توفر الشيفرة أو البيانات.
6. لماذا لفت الانتباه، ولماذا لا يزال التجمّع صغيرًا
صنّف مسار الاختيار هذه الورقة ضمن «الاستدلال والتعلّم». حجم مجموعتها هو 1: لم تظهر في نافذة الجمع هذه أي ورقة أخرى حول السؤال نفسه، وكانت الإشارة الوحيدة التي ظهرت هي التصويتات على صفحة الورقة في Hugging Face، بواقع 67 إعجابًا وتعليق واحد و0 نجمة على GitHub.[2] تدل التصويتات الإيجابية على أن الباحثين لاحظوا الورقة. لكنها لا تقول شيئًا عن صحة ما تدّعيه أو عن قيمتها السريرية.
لا تزال الكلمات المفتاحية للورقة تُظهر موقعها: التعلم المعزز المعزَّز بالأدوات، وGRPO، والضبط الدقيق الخاضع للإشراف للوكلاء، والاستدلال المستند إلى الأدلة. وتتكرر هذه المصطلحات في أبحاث الوكلاء الحديثة. وقد غطّى هذا الموقع مؤخرًا أوراقًا عن وكلاء يتصرفون قبل اكتمال أدلتهم، وعن إطلاع الناس على مسوّغات تصرفات الوكيل.
ينقل X-Ragent هذا المسار البحثي إلى مجال محدد هو التصوير الطبي. فالسؤال يتحول من «هل يستطيع الوكيل استخدام الأدوات؟» إلى «متى ينبغي له أن يثق بما تعيده الأدوات؟». غير أن ورقة بحثية واحدة لا تصنع موضوعًا. أما هل سيتحول هذا الاتجاه إلى مجموعة من الأبحاث فهو أمر يستحق المتابعة خلال الأسابيع القادمة.
7. أين يرتبط هذا بالممارسات الدوائية والتنظيمية
يمكن تنظيم البرمجيات التي تدعم التشخيص بالصور بوصفها جهازًا طبيًا. ولا يقتصر تقييمها على أرقام الأداء، بل يشمل أيضًا الشروط التي يجوز أو لا يجوز استخدامها فيها. وتتفق فكرة إبعاد القياسات غير المنطبقة عن خطوط الاستدلال مع مفهوم شروط الاستخدام هذا. فالنظام الذي يقرر متى لا تنطبق أداة القياس ويسجّل هذا القرار ينتج مادة يمكن أن تدعم التفسير.
كما أن المكافأة المشروطة بالدقة تشبه مبدأً من مبادئ ضمان الجودة. فاتباع الإجراء لا يغني عن النتيجة الصحيحة. إذ يُقيَّم الإجراء بعد التأكد من صحة النتيجة. وما هو معتاد في التصنيع والاختبار أُعيدت صياغته هنا في صورة تصميم للمكافأة.
لا يمكن قراءة نتائج المقاييس المرجعية من ورقة بحثية أولية على أنها أداء سريري. وأكثر ما تواجه شركات الأدوية هذا النوع من التقنيات في دعم قراءة الصور في التجارب السريرية، أو في التحقق من اتساق تلك القراءات. وحتى هناك، يجب الاحتفاظ بسجل للقياسات التي قُبلت والتي رُفضت، ويجب أن يبقى القرار النهائي للأطباء، وأن يكون السجل متاحًا للمراجعة لاحقًا. وما ينتقل إلى الممارسة ليس رقمًا بعينه بقدر ما هو فكرة التصميم: التعامل مع البحث عن الأدلة وقبول الأدلة على أنهما قراران مختلفان.