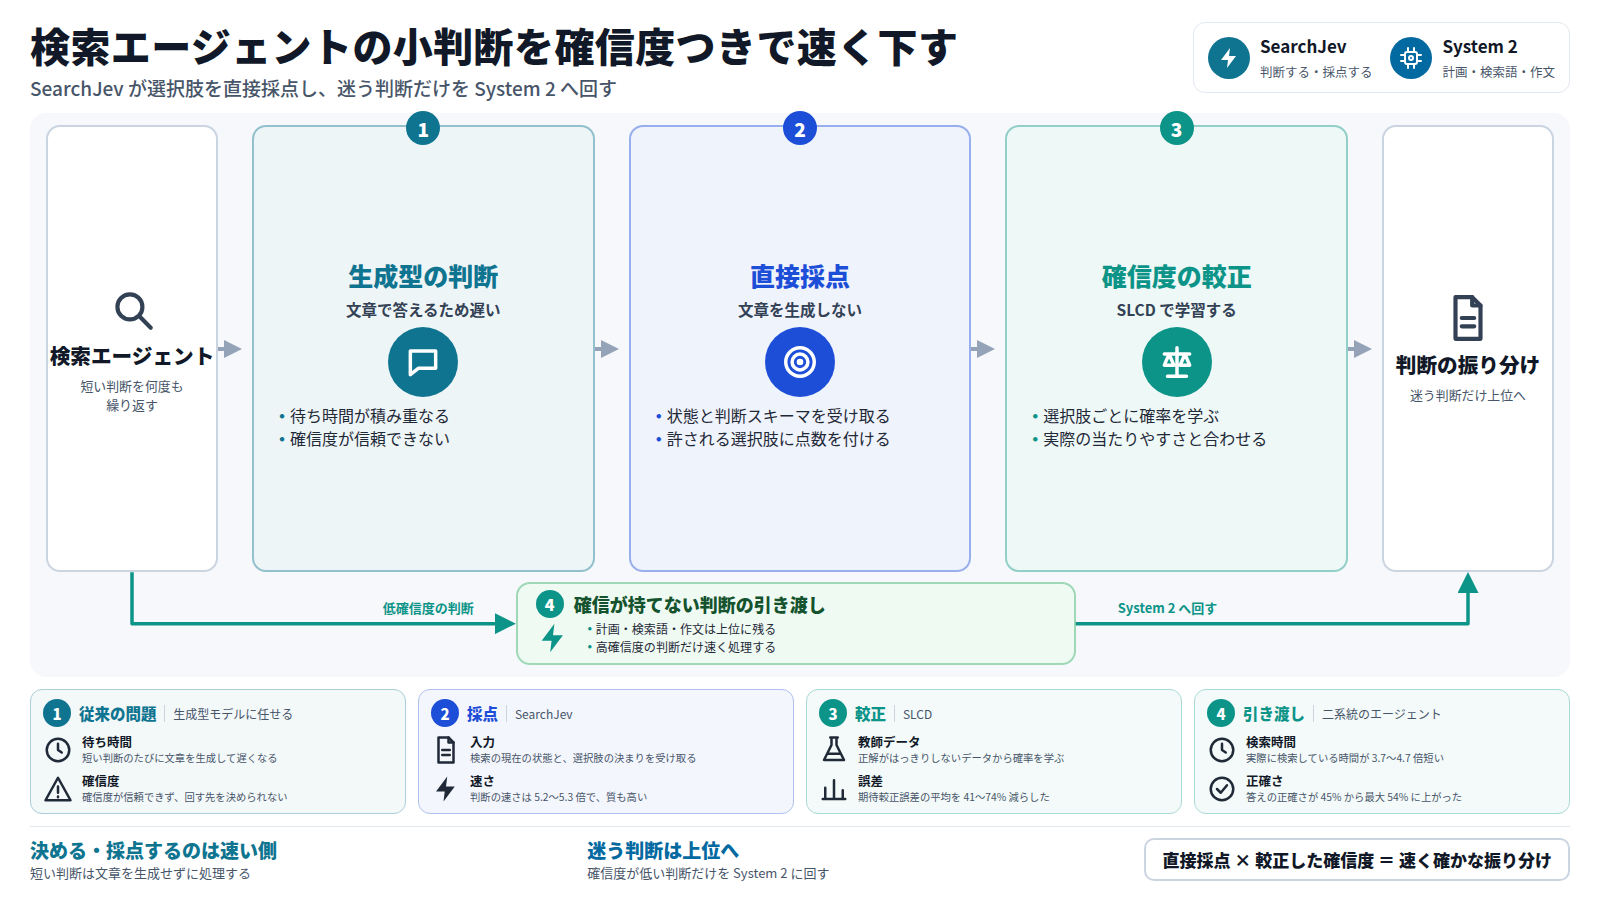
1. 検索エージェントは、小さな判断を何度も繰り返している
調べものをするエージェントの仕事は、検索して答えを書くことだけではない。その途中で、取ってきた文書が質問に関係するか、答えるための証拠がもう十分か、次にどんな検索をするか、といった短い判断を何度も下している。著者らはこの点に注目した。[1]
多くのエージェントでは、こうした判断も生成型の言語モデルに任されている。モデルは判断の理由や結論を文章として一語ずつ出力し、エージェントはその文章を読み取って次の動きを決める。abstract が挙げる問題は二つある。一つは、短い判断のたびに文章を生成するので待ち時間が積み重なること。もう一つは、モデルが示す確信度が信頼できないことである。
二つ目の問題は見落とされやすい。「この文書は関係がある」とモデルが答えたとき、それがどのくらい確かなのかが分からなければ、どこで人や大きなモデルに判断を回すべきかも決められない。
2. 提案の芯は、生成せずに選択肢を直接採点すること
SearchJev は、判断だけを受け持つ速いモデルである。著者らはこれを人の思考の二つの系統になぞらえて System-1 と呼び、計画や検索語の作成、答えの作文を受け持つ System 2 から判断を切り離した。
使い方は単純である。検索の現在の状態と、その判断で選べる選択肢の決まり(判断スキーマ)を受け取り、許される選択肢それぞれに直接点数を付ける。文章を一語ずつ生成する手順を踏まないので、その分速い。
確信度の扱いには、Soft-Label Learning for Calibrated Decisions(SLCD)という学習法を提案している。正解がはっきりしない教師データから、選択肢ごとの確率を学び、その確率が実際の当たりやすさと合うように較正する。二系統のエージェントでは、SearchJev が短い判断を処理し、確信が持てない判断だけを System 2 に回す。計画、検索語の生成、答えの作成は System 2 に残る。
3. abstract の範囲で示されたこと
著者らは評価のために SearchDecision-Bench を作った。検索中に生じる 6 種類の判断を一つにまとめ、学習と評価に使えるようにしたベンチマークである。
abstract によれば、このベンチマークで SearchJev は、同じ規模の Qwen3.5 の自己回帰型モデルより判断の質が高く、判断の速さは 5.2〜5.3 倍で、確信度のずれを示す期待較正誤差(ECE)の平均を 41〜74% 減らした。
既存の評価環境である BrowseComp-Plus[4]では、二系統のエージェントが実際に検索している時間を 3.7〜4.7 倍短くし、答えの正確さを 45% から最大で 54% に上げたとされる。「最大で」とあるとおり、これは条件の中で最もよかった結果であり、どの組み合わせでも同じだけ上がったという意味ではない。
4. 具体例で見る ── 安全性情報の文献調査で、判断を誰が受け持つか
ある医薬品の副作用について、公開文献を調べて報告の候補を集める作業を、検索エージェントに手伝わせる場面を考える。
エージェント内部のやりとり(二系統の場合)
System 2:対象の薬剤名と副作用名で検索した。上位の文書について、関係があるか判断してほしい。
SearchJev:一つ目は対象薬剤の症例報告で、副作用名も本文に出ている。「関係あり」、確信度は高い。二つ目は同じ薬効群の別の薬剤の総説で、「関係なし」、これも確信度は高い。
SearchJev:三つ目は、対象薬剤を含む併用療法の報告で、どの薬剤による副作用かが本文から切り分けられない。確信度が低いので、判断を System 2 に回す。
System 2:三つ目は併用の情報として残し、担当者の確認対象に回す。証拠はまだ足りないので、検索語を変えてもう一度探す。
この例で大事なのは、速さよりもどこで判断を手放すかである。確信度が実際の当たりやすさと合っていれば、確信度の低い判断だけを上位の推論や人の確認に回せる。確信度があてにならなければ、この振り分け自体が成り立たない。
5. 新しくない部分と、abstract から読み取れない限界
速い仕組みで大半を処理し、難しいものだけを遅く確かな仕組みに回すという考え方は、新しくない。軽いモデルと重いモデルを段階的に使い分ける構成や、生成せずに候補へ点数を付ける判定モデル、予測確率を当たりやすさに合わせる較正の手法は、それぞれ以前から研究されている。この論文の寄与は、検索エージェントの中の判断を種類ごとに整理して一つのベンチマークにまとめ、不確かな教師データからの較正学習と、迷った判断の受け渡しを組み合わせた点にある、と読める。
限界もいくつかある。第一に、判断の質の比較相手は同じ規模の Qwen3.5 の自己回帰型モデルである。より大きなモデルが判断した場合と比べてどうかは、abstract には書かれていない。第二に、較正の改善は著者ら自身が作った SearchDecision-Bench での結果である。学習の分布から外れた質問や分野で、確信度が同じように当てになるかは示されていない。
第三に、速さの改善は「実際に検索している時間」についての数字で、答えを出すまでの全体の時間がどれだけ縮んだかは別に考える必要がある。第四に、どの確信度で System 2 に回すかという閾値の決め方と、それが正確さと速さの釣り合いをどう変えるかは、abstract の範囲では示されていない。第五に、SLCD が使う「不確かな教師データ」がどのように作られたかも、abstract には書かれていない。
6. この主題が、いま束になっている理由
今回の収集では、この論文は RoboQuest と同じ束に入っており、束の大きさは 2 である。[5]RoboQuest は、物を動かせるエージェントが、見えていない情報を探し、調べ、試しながら作業を進められるかを測るベンチマークである。その著者らは、エージェントが作業完了に必要な証拠を見る前に判断してしまい、探索を早く打ち切りがちだと報告している。
一方は文書の検索、もう一方は物理的な作業と、扱う場面はまったく違う。それでも二つは、「証拠はもう足りているか」という判断をエージェントがどう下すかという同じ問いに触れている。SearchJev はこの判断を較正された確信度つきで速く下す方向を、RoboQuest はこの判断が早すぎることによる失敗を示している。
論文共有の場では、SearchJev に 23 件の支持票と 2 件のコメントが付き、学習用のコードを公開したリポジトリには 15 件の star が付いている。[2][3]これらは研究者や実装者の関心の目安であって、主張が正しいことを示すものではない。
7. 製薬・規制の現場から見ると何が接続するか
製薬企業では、安全性情報の文献調査、規制当局の文書の検索、社内の問い合わせ対応など、「大量の候補から関係のあるものを選び、証拠が足りるかを判断する」作業が日常的にある。どれも、関係があるものを見落とすことの重さが、関係のないものを拾う手間よりはるかに大きい。
この論文の構成がこうした作業と接続するのは、速さよりも、確信度の低い判断を上位に回すという振り分けの部分である。上位の受け手を大きなモデルではなく担当者に置き換えれば、そのまま「機械が自信を持てない文献だけを人が見る」運用になる。
ただし、この振り分けが安全に働くのは、確信度が自社の文献や質問の分布でも較正されている場合に限られる。著者らの較正の結果は著者ら自身のベンチマークでのものであり、査読前の段階の研究でもある。導入を考えるなら、自社のデータで確信度と実際の正解率の対応を確かめ、確信度が高いのに誤っていた判断を記録して見直す仕組みを、先に用意しておく必要がある。