1. 見たことのない環境で「仕組み」を推し量る難しさ
知らない環境で行動するエージェントは、何をすると何が起きるのかを、自分の観察から推し量るしかない。著者らが最初に指摘するのは、観察が少ないうちは、これまでの出来事をどれもうまく説明できるのに、まだ見ていない場面では違う予測をする「世界の仕組みの説明」が複数成り立つという点である。[1]
言語モデルは大量の知識を持っているが、目の前の環境に固有の決まりは知らない。経験した場面をそのまま覚えておくだけでは、似ていない場面に来たときに役に立たない。逆に、早い段階で一つの説明に決め打ちすると、誤った決まりを信じたまま動き続けることになる。
この論文が扱うのは、モデルの重みを更新せずに、エージェントが環境の決まりを明示的に書き出し、それを証拠に照らして改訂し続けられるか、という問題である。
2. 提案の芯は、規則帳を書き、コードに変え、再生で検証すること
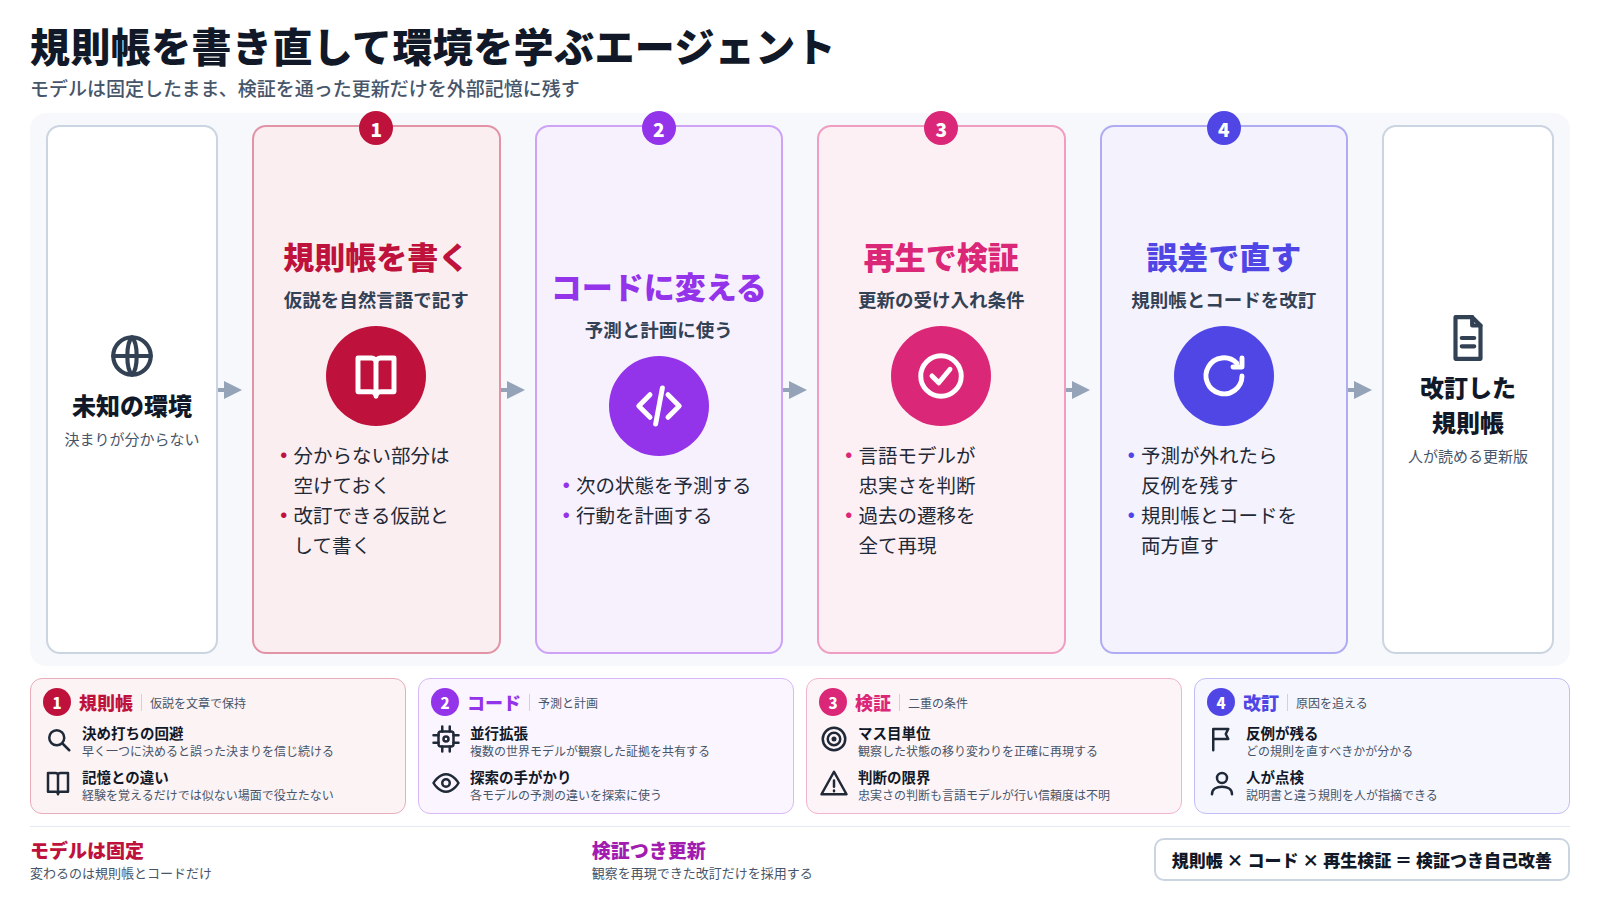
Memento 3 は、同じ系列の先行研究を土台に、凍結した言語モデルのエージェントに外部記憶を通じて世界モデルを学ばせる。中心にあるのは、エージェントが持ち続ける自然言語の規則帳である。そこには環境の動きについての改訂可能な仮説が書かれ、分かっていない部分は分からないまま残しておく。
エージェントはこの規則帳を実行可能なコードに変換し、そのコードで次の状態を予測し、行動を計画する。観察、振り返り、規則の改訂、コードへの変換、検証という流れを繰り返し、予測が外れたときの誤差を手がかりに、規則帳とコードの両方を直していく。
ここで要になるのが、更新を受け入れる条件である。新しいコードが採用されるのは、言語モデルが「規則帳に忠実である」と判断し、かつこれまでに観察した状態の移り変わりを、マス目の単位まで正確に再現できたときだけである。さらに、複数の世界モデルを並行して持ち、観察した証拠を共有しながら、それぞれの予測の違いを探索の手がかりにする拡張も示されている。
3. abstract の範囲で示されたこと
評価には ARC-AGI-3 が使われている。エージェントが初めて見る環境を探索しながら推論する力を測る、対話型のベンチマークである。[4]abstract によれば、単一の世界モデルを使うエージェントは、公開されている 25 のゲームすべてで全レベルを突破し、人間の行動効率を基準にした指標 RHAE の平均が 100.0 となり、行動回数は人間の 44% だったという。
もう一つの事例として、Atari のポンが挙げられている。エージェントが学んだフィードバック制御器は、出だしの異なる三つのエピソードのそれぞれで 21:0 で勝ち、その際に言語モデルを追加で呼び出す必要はなかったとされる。
著者らはこれを、エージェントが自分で環境を探り、世界モデルを改訂し、検証を通った更新を次の行動と学習に生かす過程として位置づけている。その間、土台の言語モデルは固定されたままである。
4. 具体例で見る ── 新しい入力システムの決まりを試しながら覚える
臨床試験のデータを入力する新しいシステムに、エージェントが入力作業を任されたとする。どの組み合わせの値を入れると警告が出るのか、説明書には一部しか書かれていない。
経験をそのまま覚えるエージェント
警告が出た入力の例を記憶に積み上げていく。似た入力にはその記憶を当てはめるが、なぜ警告が出たのかは書かれていないので、少し違う入力では予測が外れる。外れても、どの思い込みが誤っていたのかは記憶のどこにも残らない。
規則帳を持つエージェント
「ある項目が空欄で別の項目が入力済みなら警告が出る」といった仮説を規則帳に書き、まだ分からない条件は空けておく。規則帳をチェック用のコードに変え、過去の入力と警告をすべて再現できたときだけ採用する。予測が外れれば、その入力が反例として残り、どの規則を直すべきかが分かる。
右のやり方では、エージェントが何を信じて動いているかが文章として読める。人が見て「この規則は説明書と違う」と指摘することもできる。左のやり方では、それができない。
5. 新しくない部分と、abstract から読み取れない限界
環境のモデルを学んでから計画に使う、という考え方は、強化学習ではモデルベースの手法として以前から研究されてきた。世界の決まりをプログラムとして書き出す試みも、この論文が初めてではない。また、本論文自身が Memento の系列の続きであることを明記している。新しいのは、自然言語の規則帳と実行可能なコードを対にし、言語モデルの判断と過去の観察の厳密な再生という二重の条件で更新を受け入れる仕組みを組み立て、それを再帰的な自己改善の一つの道筋として示した点にある、と読める。
限界も見えている。第一に、ARC-AGI-3 の結果は公開されているゲームについてのものである。公開されていない評価用のゲームでの結果は、abstract には書かれていない。第二に、RHAE の定義や、平均 100.0 という値をどう読むべきかは abstract の範囲では説明されていない。第三に、マス目単位で正確に再現するという検証条件は、状態がはっきり区切られた決定的な環境だからこそ使える。観測にノイズがある環境や、同じ行動でも結果がばらつく環境で、この条件をどう置き換えるのかは示されていない。
第四に、計算の費用、つまり言語モデルを何回呼び出したか、どれだけ時間がかかったかは abstract に書かれていない。第五に、ポンの事例は一つのゲームで三つのエピソードに限られる。最後に、「規則帳に忠実か」を判断するのも言語モデルであり、その判断がどの程度信頼できるかは、abstract の範囲では分からない。
6. この主題が、いま束になっている理由
今回の収集では、この論文は Agent Plasticity と同じ束に入っており、束の大きさは 2 である。[3]Agent Plasticity は、エージェントが経験を再利用できる成果物に変え、それが後の別の場面での性能向上につながる効率を「可塑性」と呼んで測る研究である。著者らは、同じ学習の機会があってもモデルによって改善の軌跡が大きく異なり、学習した範囲の外へは一部しか移らないことがある、と報告している。
二つの論文は、重みを変えずに外部の記憶や成果物でエージェントを改善する、という同じ方向を向いている。Memento 3 は改善の仕組みを、Agent Plasticity はその改善をどう測るかを扱っている。後者の問題意識に照らすと、前者の結果は「学習した環境の外にどこまで移るか」という問いがまだ開いたままだと分かる。
論文共有の場では、Memento 3 に 22 件の支持票と 3 件のコメントが付いている。[2]公開されたリポジトリは収集の時点では確認されていない。支持票は研究者の関心の目安であり、主張が正しいことを示すものではない。
7. 製薬・規制の現場から見ると何が接続するか
規制の下でシステムを使う側にとって、学習するエージェントの扱いにくさは、いつの間にか挙動が変わることにある。重みが更新されるモデルでは、何が変わったのかを人が読んで確かめることが難しい。
Memento 3 の構成では、変わるのはモデルではなく規則帳とコードである。規則帳は人が読める文章で、更新には過去の観察を再現できたという検証が付く。この形であれば、変更管理の対象を「規則帳とコードの版」として定め、どの観察を根拠にどの規則が改訂されたかを記録に残すことが、原理の上では可能になる。
一方で、検証条件が観察の再現である以上、まだ観察していない場面での正しさは保証されない。この点は、過去のデータに合うことと、将来の使い方で正しく動くことを区別するバリデーションの考え方と同じである。査読前の段階の研究であることを踏まえ、規則帳の改訂を誰が承認するのか、エージェントの自己改善をどこで止めて人が確認するのかを、導入前に決めておく必要がある。