1. Algunas lecturas de radiografías de tórax no pueden resolverse solo con mirar
Leer una radiografía de tórax no consiste solo en nombrar lo que se ve. El resumen parte de este punto. La interpretación suele requerir combinar los hallazgos visuales con evidencia específica de la tarea, en lugar de depender únicamente del reconocimiento visual directo.[1]
Los agentes médicos con herramientas han sido una respuesta a esto. El agente delega partes del trabajo en módulos externos, como recortar una región para verla de cerca o segmentar un órgano para medir su tamaño, y luego integra los resultados en su razonamiento. Para las radiografías de tórax, trabajos anteriores propusieron un agente que encadena estas herramientas para el razonamiento en varios pasos, junto con un conjunto de evaluación llamado ChestAgentBench.[3]
Poder llamar a herramientas no es lo mismo que llamarlas bien. Los autores señalan dos carencias en los agentes existentes. Primero, carecen de un mecanismo explícito para aprender cuándo se necesita realmente evidencia auxiliar. Segundo, carecen de una forma de impedir que la evidencia cuantitativa que no se aplica a la imagen entre en el razonamiento diagnóstico. La primera lleva a llamar a las herramientas con demasiada frecuencia o a no llamarlas nunca. La segunda es más peligrosa: un número puede dar peso a una conclusión errónea simplemente por ser un número.
2. La idea central: separar la búsqueda de evidencia de la admisión de mediciones
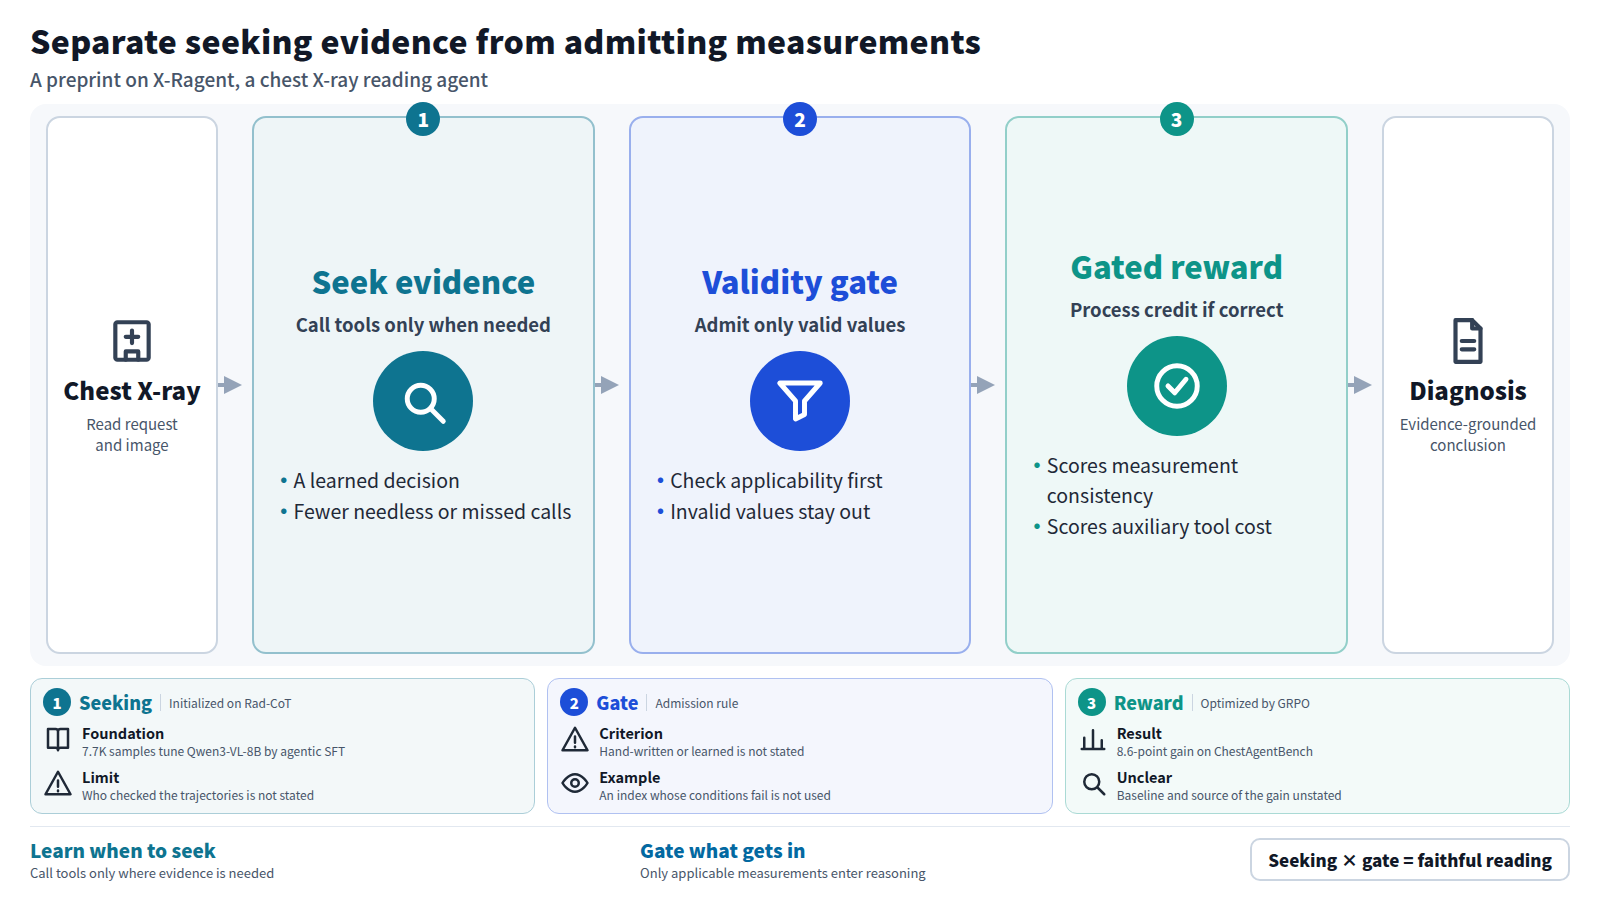
X-Ragent es un marco de posentrenamiento para el aprendizaje por refuerzo aumentado con herramientas. Su decisión de diseño central es desacoplar dos comportamientos. Uno es decidir si buscar evidencia auxiliar, algo que el modelo aprende. El otro es una puerta de validez que comprueba si una medición cuantitativa es aplicable a esta imagen antes de permitir que la medición entre en el razonamiento. La primera es una decisión aprendida; la segunda es una regla de admisión de cifras.
El entrenamiento tiene dos etapas. Los autores primero construyen Rad-CoT, un corpus de 7.7K muestras que combina trayectorias de uso de herramientas ordenadas causalmente con razonamiento diagnóstico redactado al estilo de un informe de radiología. Lo utilizan para inicializar Qwen3-VL-8B mediante ajuste fino supervisado agéntico.
Después optimizan la política con Group Relative Policy Optimization (GRPO), un método existente que muestrea varias respuestas a la misma pregunta y aprende de cómo se compara cada una con el resto del grupo.[4] La contribución está en la recompensa. Los términos a nivel de proceso, uno para la coherencia de las mediciones y otro para el coste de usar herramientas auxiliares, se aplican solo a las trayectorias cuyo diagnóstico es correcto. Los autores lo llaman recompensa condicionada a la precisión. Su propósito es evitar que un comportamiento de proceso de apariencia plausible compense un diagnóstico incorrecto.
3. Qué informa el resumen
- Datos: Rad-CoT, 7.7K muestras que combinan trayectorias de uso de herramientas con razonamiento en estilo de informe.
- Capacitación: Qwen3-VL-8B inicializado con SFT agéntico y luego optimizado con GRPO bajo la recompensa condicionada a la precisión.
- Resultados: los mejores resultados en tres referencias de radiografía de tórax, incluida una mejora de 8.6 puntos en ChestAgentBench, que quedó completamente fuera del entrenamiento.
- Lectura de los autores: al buscar evidencia de forma selectiva y admitir solo mediciones válidas, el sistema favorece un razonamiento más fiel y basado en evidencia.
Hay varias cosas que conviene comprobar. El resumen no dice respecto a qué se mide la mejora de 8.6 puntos, si el modelo base u otro agente. Solo nombra uno de los tres benchmarks. Los "mejores resultados" dependen de qué sistemas se eligieron para la comparación. Y el resumen no muestra qué parte del diseño de la recompensa explica la mejora.
4. Un ejemplo práctico: decidir no usar una medición
Para entender qué significa una medición no aplicable, consideremos un escenario de lectura. Este ejemplo ilustra la idea; no se puede determinar a partir del resumen si el artículo cubre esta situación. En las radiografías de tórax, la posición del paciente y la dirección del haz cambian la apariencia del corazón, y un índice estándar del tamaño cardíaco puede no ser válido para todas las imágenes.
Solicitud: Evalúa si esta radiografía de tórax muestra cardiomegalia.
Agente: (inspecciona la imagen) Revisando los campos pulmonares y el mediastino. Una medición del tamaño ayudaría con la silueta cardíaca, así que llamaré a la herramienta de medición.
Agente: (comprueba la puerta) Las condiciones de adquisición no cumplen los supuestos en los que se basa este índice. La medición no entrará en el razonamiento.
Agente: Juzgaré a partir de los hallazgos visibles sin el número, y dejaré constancia de que la medición fue rechazada.
El punto es que llamar a una herramienta y aceptar su resultado son pasos separados. La recompensa hace la misma separación. Colocar las dos señales de entrenamiento una al lado de la otra muestra la diferencia.
Recompensa por el proceso siempre añadida
Incluso cuando el diagnóstico es erróneo, la medición cuidadosa y el uso económico de las herramientas siguen sumando puntos. Una trayectoria puede ser reforzada por parecer metódica aunque llegue a una respuesta incorrecta.
Recompensa condicionada a la precisión (X-Ragent)
La coherencia de las mediciones y el costo de las herramientas solo se puntúan en las trayectorias con un diagnóstico correcto. Un diagnóstico erróneo no recibe puntos por el proceso, por muy ordenados que sean los pasos. Primero la conclusión tiene que ser correcta.
5. Lo que no es nuevo y dónde están los límites
Empecemos por lo que no es nuevo. Los agentes médicos que usan herramientas ya existían en trabajos anteriores, y el propio ChestAgentBench surgió de esos trabajos.[3] GRPO es un método consolidado, y ejecutar aprendizaje por refuerzo después del ajuste fino supervisado es un patrón común en el posentrenamiento de modelos de lenguaje. Las novedades son la separación entre la búsqueda de evidencia y la admisión de mediciones, y la recompensa que limita el crédito del proceso a las trayectorias correctas.
Hay varios límites. Primero, el criterio para determinar si una medición es aplicable. El resumen no dice qué examina la puerta de control, ni si sus reglas fueron escritas por personas o aprendidas. Según cómo se haya construido, puede discrepar del juicio de un radiólogo.
Segundo, el alcance de la evaluación. Las puntuaciones de los benchmarks suelen ser la precisión en preguntas estructuradas. El resumen no dice nada sobre la calidad de los informes completos, los tipos de hallazgos que se pasan por alto ni los efectos en las decisiones clínicas, y tampoco describe los hospitales ni las condiciones de imagen detrás de los tres benchmarks.
Tercero, la construcción de Rad-CoT. Las trayectorias se describen como ordenadas causalmente, pero el resumen no dice quién las verificó ni cómo. Cualquier sesgo que contenga el razonamiento de entrenamiento, el modelo lo aprenderá junto con él.
Cuarto, la reproducibilidad. Los datos de selección indican cero estrellas en GitHub y ningún repositorio público. Este artículo no ha confirmado si el código o los datos están disponibles.
6. Por qué llamó la atención y por qué el grupo sigue siendo pequeño
El proceso de selección ubicó este artículo en Reasoning & Learning. Su tamaño de clúster es 1: en esta ventana de recopilación no apareció ningún otro artículo sobre la misma cuestión, y la única señal que se activó fueron los votos en la página del artículo en Hugging Face, con 67 votos a favor, 1 comentario y 0 estrellas en GitHub.[2] Los votos a favor muestran que los investigadores se fijaron en el artículo. No dicen nada sobre si sus afirmaciones se sostienen ni sobre si tiene valor clínico.
Las palabras clave del artículo aún muestran dónde se ubica: aprendizaje por refuerzo aumentado con herramientas, GRPO, ajuste fino supervisado agéntico, razonamiento basado en evidencia. Estos términos se repiten en la investigación reciente sobre agentes. Este sitio ha cubierto recientemente artículos sobre agentes que actúan antes de tener su evidencia completa y sobre mostrar a las personas los fundamentos de las acciones de un agente.
X-Ragent lleva esa línea de trabajo a un ámbito específico, las imágenes médicas. La pregunta pasa de «¿puede el agente usar herramientas?» a «¿cuándo debe confiar en lo que devuelven las herramientas?». Sin embargo, un solo artículo no hace un tema. Habrá que observar en las próximas semanas si esta dirección crece hasta formar un grupo de trabajos.
7. Dónde conecta esto con la práctica farmacéutica y regulatoria
El software que apoya el diagnóstico por imagen puede regularse como producto sanitario. Su evaluación abarca no solo las cifras de rendimiento, sino también las condiciones en las que puede y no puede usarse. La idea de mantener fuera del razonamiento las mediciones no aplicables coincide con esa noción de condiciones de uso. Un sistema que decide cuándo una herramienta de medición no es aplicable, y registra esa decisión, genera material que puede respaldar una explicación.
La recompensa condicionada a la precisión también se parece a un principio de aseguramiento de la calidad. Seguir el procedimiento no sustituye un resultado correcto. El procedimiento se evalúa después de confirmar que el resultado es correcto. Lo que es rutina en manufactura y pruebas se ha reescrito aquí como diseño de recompensas.
Los resultados de referencia de un preprint no pueden interpretarse como rendimiento clínico. Lo más probable es que las empresas farmacéuticas se encuentren con este tipo de tecnología en el apoyo a la lectura de imágenes en ensayos clínicos, o en la comprobación de la coherencia de dichas lecturas. Incluso ahí, debe conservarse el registro de qué mediciones se aceptaron y cuáles se rechazaron, la decisión final debe seguir en manos de los médicos y el registro debe quedar abierto a revisión posterior. Lo que se traslada a la práctica no es tanto una cifra concreta como la idea de diseño: tratar la búsqueda de evidencia y la aceptación de evidencia como dos decisiones distintas.