1. 這篇論文要解決什麼問題?
醫學領域中針對大型語言模型(LLM)的研究,大多探討的是準確度。模型能否說出診斷、通過考試、勝過醫師?然而,當 AI 建議在臨床上被付諸執行時,最先變動的是檢查醫囑、轉診與處方,每一項都伴隨成本。
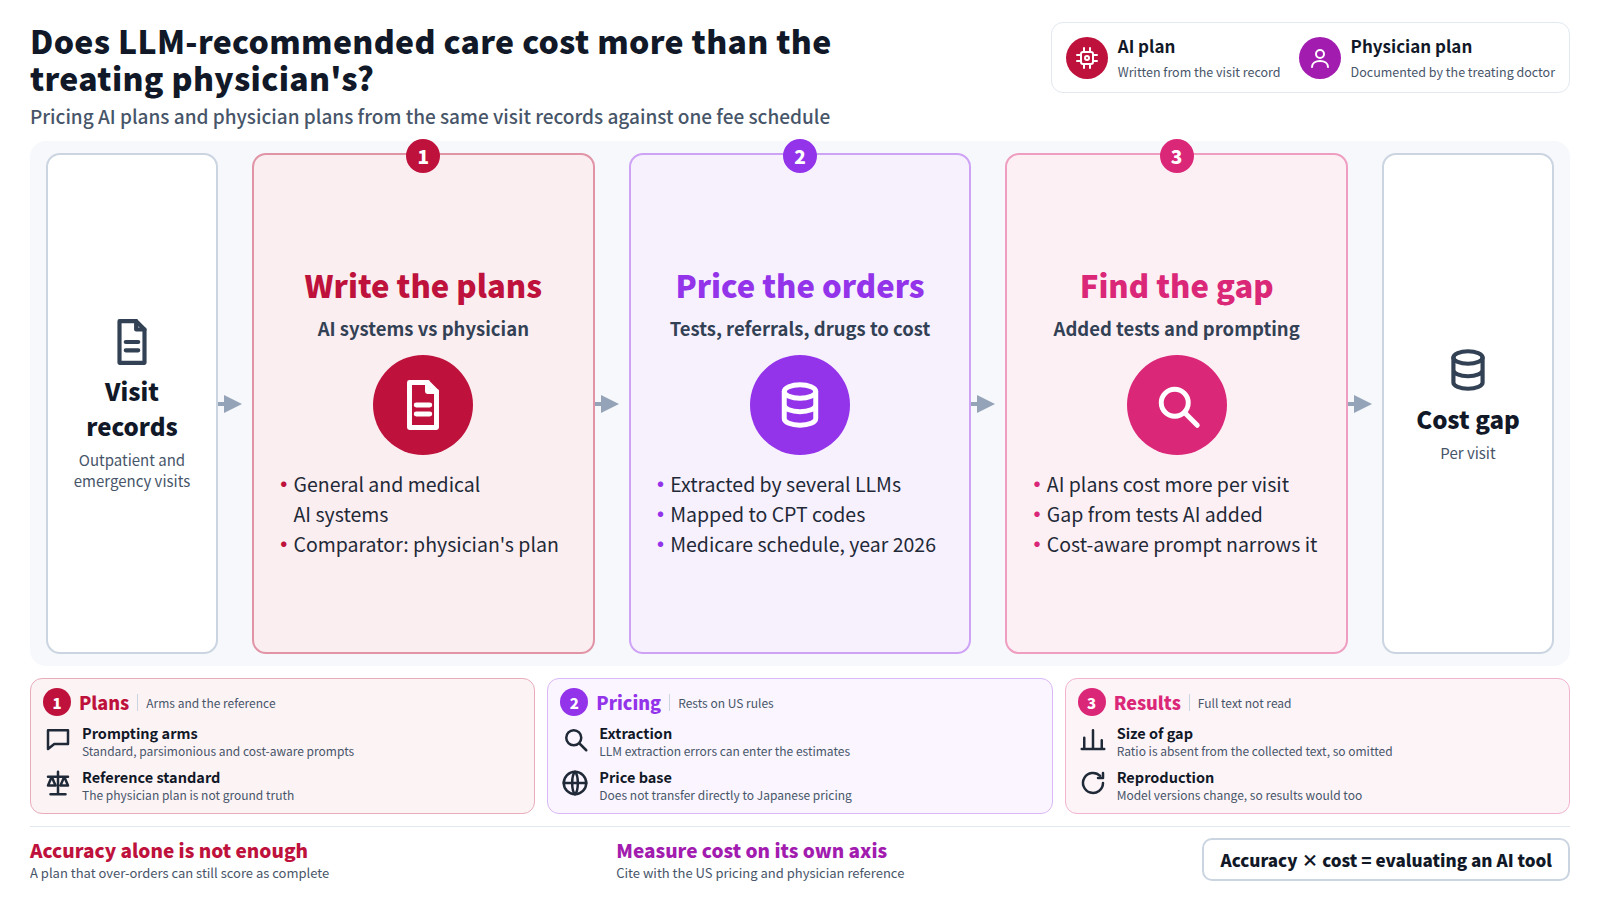
這篇經同儕審查後發表於 NEJM AI 的原創文章,將問題從準確性轉向成本。在相同的就診紀錄下,LLM 所撰寫的照護計畫,其費用是否與實際診視該病人的醫師所寫的計畫不同?若是,造成差異的原因為何,而提示模型的方式又是否會改變它[1]?
準確度分數很高的 AI,若傾向『以防萬一』而堆疊開立檢查,仍可能推高支出與病患負擔。成本砍得太兇,又會漏掉該發現的問題。準確度與成本必須在不同的軸上分別衡量;這正是這篇論文的出發點。
2. 它提出了什麼?
此方法的核心,是讓 AI 的治療計畫與醫師的治療計畫以同一套費用標準表計價。根據作者對其資料與分析程式碼的公開說明,就診主訴資訊取自門診與急診就診紀錄,並要求一組 AI 系統——包含通用型 LLM 與專門的醫療系統——撰寫評估與計畫。對照組則是診治醫師所記錄的計畫[3][4].
各方案中的檢查、轉診與用藥由多個獨立的 LLM 擷取,並對應到美國醫療處置代碼(CPT)。醫囑隨後按 2026 曆年的 Medicare Physician Fee Schedule 定價,藥品則採用美國全國藥價調查。除了標準提示詞之外,還執行了兩個提示詞分支: 一個要求提出精簡方案,另一個要求模型具備成本意識[4].
因此這項研究並未賦予AI新的能力。它是以健康經濟學的量尺,重新衡量AI既有的輸出。
3. 在可查證的範圍內,它顯示了什麼?
先說一個限制。在本站收集的書目紀錄中,摘要欄位僅有一行「NEJM AI, Ahead of Print.」。截至撰寫當下,NEJM AI 的文章頁面無法存取,全文也尚未閱讀。以下內容僅依據作者群張貼在其自家出版品頁面上的摘要[2].
根據該摘要,AI 系統建議的照護每次就診的成本高於主治醫師所建議的照護。差距大部分來自 AI 在醫師原本未開立檢查的就診中額外增加的檢查。作者寫道,具成本意識的提示詞縮小了差距,但從未能完全消除。
該摘要也給出了差距大小的比例。本文不會刊出所蒐集主要文本中沒有的數字,因此此處略去該比例。想要了解實際規模的讀者,應直接查閱 NEJM AI 論文與作者的摘要。
公開儲存庫也列出關於醫師適切性評分、AI與醫師的診斷一致性,以及再測信度的分析[4]. 論文中如何報告這些結果,無法在本篇文章的範圍內確認。
4. 實例解析
想像一家藥廠的醫學事務團隊,正在評估一款供醫療專業人員使用的 AI 輔助工具。
一場內部審查會議
開發者: "在評估的案例中,與主治醫師的診斷一致度大致相同。這些治療計畫沒有遺漏任何項目。"
健康經濟負責人: "你有算過那些治療計畫裡的檢查項目嗎?在醫師選擇觀察等待的診次中,AI 是否加開了血液檢查與影像檢查?"
開發者: "看來確實有很多以防萬一的檢查。但這樣做是寧可保守、以求安全。"
健康經濟負責人: "是否安全,取決於這些檢查是否改變了臨床處置。它們會增加成本與病人的負擔,因此除非我們在準確度之外也測量這一點,否則就還沒有評估過這個工具。"
論文引入了第二位講者的觀點。在準確度比較中,超量訂購的計畫仍可能以「完整」之名拿到高分。把各計畫按成本並排列出,偏差便顯而易見。
5. 哪些部分並不新穎,極限又在哪裡?
比較 LLM 與醫師的研究為數眾多:診斷準確度、考試題目、影像判讀。這種比較框架本身並不新穎,新的是此處所用的衡量標準。其基本構成——從病歷擷取資料、醫療代碼對應,以及對照費用表計價——都是健康經濟學研究的標準做法。從現有資料即可看出幾項限制。
- 醫師的計畫並非標準答案。 參考標準是主治醫師實際做的處置,而醫師不開任何檢查並不一定正確。有些 AI 額外加上的檢查,可能涵蓋了醫師遺漏的項目。單憑成本差異,無法說明哪一種計畫對病人更好。
- 費用計算取決於美國的制度。 由於使用的是 Medicare 費用支付標準與美國藥價資料,研究結果無法直接套用到日本的診療報酬或藥價。差距的方向或許有參考價值;其大小則取決於醫療制度。
- 就診紀錄為文字。 AI 閱讀病歷記錄後撰寫治療計畫;醫師則親自診視病人,並權衡病人的偏好與保險。很難說雙方擁有相同的資訊。該儲存庫包含一個公開醫療轉錄語料庫的快照,但案例究竟來自何處,在此無法確認。
- 轉載受限。 該儲存庫本身就警告,模型版本與 API 可用性會變動,因此重新執行這些查詢並不會得到相同的結果。這些保存下來的輸出反映的是2026年春季觀察到的模型行為[4].
- 擷取工作也由 LLM 完成。 從治療計畫中抽取檢查與藥品的工作仰賴 LLM,因此抽取錯誤可能會影響成本估計。使用多個模型即是為了控制這個問題,但錯誤程度在此無法確認。
6. 這篇論文是如何被報導的?
本網站的篩選步驟將這篇論文選為通過同儕審查並獲多家獨立媒體報導的論文。所列的媒體為 Nature、Science、Frontiers、Neurology Today 與 medRxiv,共五家。然而將這些標題並列檢視,卻沒有一篇是關於這篇論文的。
- Nature:「多模態大型語言模型挑戰 NEJM 影像挑戰」(影像問題的準確度)
- 科學:「大型語言模型在醫師推理任務上的表現」(醫師推理任務)
- Neurology Today:「大型語言模型在診斷編碼準確度上勝過醫師」(編碼準確度)
- medRxiv:「多模態大型語言模型通過專科醫師考試…」(專科醫師考試成績)
- Frontiers:「大型語言模型在複雜心臟手術中的兩階段盲測評估…」(心臟手術中的任務表現)
這五篇是各自獨立的研究,只是標題恰好把 LLM 與醫師配對在一起。篩選步驟是依共同字詞進行比對,它們並不是本文曾獲報導的證據。就本文而言,所宣稱的『獨立報導』篩選理由並不成立。
這種落差仍具參考價值。每則被擷取的標題都圍繞「AI 是否比醫生更準確?」這個問題,而這篇論文則落在該問題之外:準確度相同不代表成本相同。在新聞關注焦點固著於準確度之際,一項成本衡量標準能登上同行評審期刊,值得記錄。無論是刊登於同行評審期刊,或獲本站選錄,都不保證結果正確、具臨床價值或具有新穎性。
7. 這與製藥及法規事務有何關聯?
首先是 AI 輔助工具的評估標準。如果系統會向醫療專業人員呈現照護選項,評估不僅應涵蓋準確度,也應涵蓋這些建議會增加多少檢查、轉診與處方。該研究的設計為此提供了一個範本。
其次,提示詞會影響結果。根據作者的總結,具成本意識的指示縮小了差距。因此,系統提示詞是產品規格的一部分,應納入變更控制與紀錄保存。如果一條指示就能改變建議的模式,那麼除非記錄下所使用的提示詞,否則評估將無法重現。
第三,健康經濟學評估。隨著 AI 參與更多建議,藥物與檢查的使用方式本身可能發生變化。成本效益研究與上市後使用情形研究,可能需要一種方法來衡量 AI 建議的參與程度。
這些都不代表該研究結果可以按現狀直接套用到日本的制度上。引用這項研究時,值得說明其費用計算是以美國的規則為依據,且參考標準是主治醫師的判斷。