1. Algumas leituras de radiografia de tórax não podem ser resolvidas apenas olhando
Ler uma radiografia de tórax não é apenas nomear o que está visível. O resumo parte desse ponto. A interpretação muitas vezes exige combinar achados visuais com evidências específicas da tarefa, em vez de depender apenas do reconhecimento visual direto.[1]
Agentes médicos com ferramentas têm sido uma resposta a isso. O agente repassa partes do trabalho a módulos externos, como recortar uma região para observá-la de perto ou segmentar um órgão para medir seu tamanho, e depois incorpora os resultados ao seu raciocínio. Para radiografias de tórax, um trabalho anterior propôs um agente que encadeia essas ferramentas para raciocínio em várias etapas, junto com um conjunto de avaliação chamado ChestAgentBench.[3]
Ser capaz de chamar ferramentas não é o mesmo que chamá-las bem. Os autores apontam duas lacunas nos agentes existentes. Primeiro, falta um mecanismo explícito para aprender quando a evidência auxiliar é realmente necessária. Segundo, falta uma forma de impedir que evidências quantitativas que não se aplicam à imagem entrem no raciocínio diagnóstico. A primeira leva a chamar ferramentas com frequência demais ou a nunca chamá-las. A segunda é mais perigosa: um número pode dar peso a uma conclusão errada simplesmente por ser um número.
2. A ideia central: separar a busca por evidências da admissão de medições
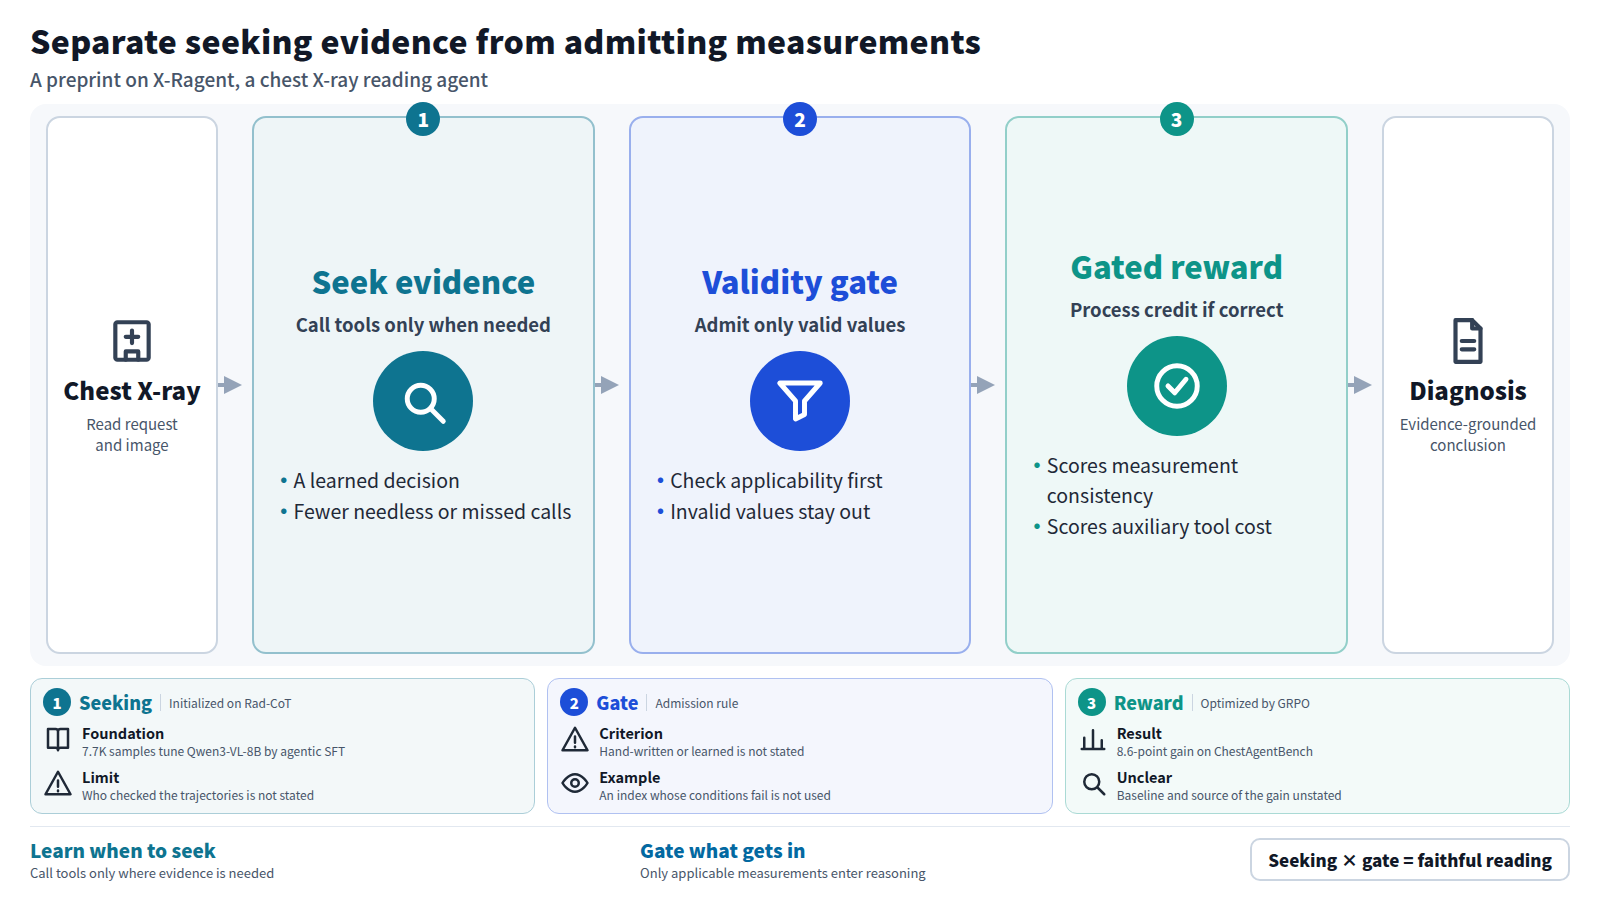
O X-Ragent é um framework de pós-treinamento para aprendizado por reforço com uso de ferramentas. Sua principal escolha de projeto é desacoplar dois comportamentos. Um é decidir se deve buscar evidências auxiliares, algo que o modelo aprende. O outro é uma porta de validade que verifica se uma medição quantitativa se aplica a esta imagem antes de permitir que a medição entre no raciocínio. A primeira é uma decisão aprendida; a segunda é uma regra de admissão para números.
O treinamento tem duas etapas. Primeiro, os autores constroem o Rad-CoT, um corpus de 7,7 mil amostras que une trajetórias de uso de ferramentas em ordem causal a raciocínios diagnósticos escritos no estilo de um laudo radiológico. Eles o usam para inicializar o Qwen3-VL-8B por meio de ajuste fino supervisionado agêntico.
Em seguida, eles otimizam a política com a Group Relative Policy Optimization (GRPO), um método existente que amostra várias respostas para a mesma pergunta e aprende com a comparação de cada uma com o restante do grupo.[4] A contribuição está na recompensa. Termos em nível de processo, um para a consistência das medições e outro para o custo de uso de ferramentas auxiliares, são aplicados apenas a trajetórias cujo diagnóstico está correto. Os autores chamam isso de recompensa condicionada à acurácia. Seu objetivo é impedir que um comportamento de processo com aparência plausível compense um diagnóstico incorreto.
3. O que o resumo relata
- Dados: Rad-CoT, 7.7K amostras que combinam trajetórias de uso de ferramentas com raciocínio no estilo de laudo.
- Treinamento: Qwen3-VL-8B inicializado com SFT agêntico e, em seguida, otimizado com GRPO sob a recompensa condicionada à precisão.
- Resultados: os melhores resultados em três benchmarks de radiografia de tórax, incluindo uma melhoria de 8.6 pontos no ChestAgentBench, que foi totalmente excluído do treinamento.
- Leitura dos autores: ao buscar evidências de forma seletiva e admitir apenas medições válidas, o sistema permite um raciocínio mais fiel e fundamentado em evidências.
Vale verificar várias coisas. O resumo não diz em relação a que se mede o ganho de 8,6 pontos, se o modelo base ou outro agente. Ele cita apenas um dos três benchmarks. "Melhores resultados" depende de quais sistemas foram escolhidos para comparação. E o resumo não mostra qual parte do desenho da recompensa explica a melhoria.
4. Um exemplo prático: decidir não usar uma medição
Para entender o que significa uma medição inaplicável, considere um cenário de leitura. Este exemplo ilustra a ideia; não é possível determinar, a partir do resumo, se o artigo cobre essa situação. Em radiografias de tórax, a posição do paciente e a direção do feixe alteram a aparência do coração, e um índice padrão de tamanho cardíaco pode não ser válido para todas as imagens.
Solicitação: Avalie se esta radiografia de tórax mostra cardiomegalia.
Agente: (inspeciona a imagem) Analisando os campos pulmonares e o mediastino. Uma medida de tamanho ajudaria na avaliação da silhueta cardíaca, então vou chamar a ferramenta de medição.
Agente: (verifica o critério de admissão) As condições de aquisição não atendem às premissas por trás deste índice. A medição não entrará no raciocínio.
Agente: Vou julgar a partir dos achados visíveis, sem o número, e registrarei que a medição foi rejeitada.
O ponto é que chamar uma ferramenta e aceitar sua saída são etapas distintas. A recompensa faz a mesma separação. Colocar os dois sinais de treinamento lado a lado mostra a diferença.
Recompensa de processo sempre adicionada
Mesmo quando o diagnóstico está errado, medição cuidadosa e uso econômico de ferramentas ainda rendem pontos. Uma trajetória pode ser reforçada por parecer metódica, ainda que chegue à resposta errada.
Recompensa condicionada à precisão (X-Ragent)
A consistência das medições e o custo das ferramentas só são pontuados para trajetórias com diagnóstico correto. Um diagnóstico errado não recebe nenhum crédito de processo, por mais organizadas que sejam as etapas. A conclusão precisa estar certa primeiro.
5. O que não é novo e onde estão os limites
Comecemos pelo que não é novo. Agentes médicos que usam ferramentas já existem em trabalhos anteriores, e o próprio ChestAgentBench surgiu de um deles.[3] O GRPO é um método consolidado, e executar aprendizado por reforço após o ajuste fino supervisionado é um padrão comum no pós-treinamento de modelos de linguagem. As novidades são a separação entre busca de evidências e admissão de medições, e a recompensa que restringe o crédito de processo a trajetórias corretas.
Há várias limitações. Primeiro, o critério para determinar se uma medição se aplica. O resumo não diz o que o filtro (gate) analisa, nem se suas regras foram escritas por pessoas ou aprendidas. Dependendo de como foi construído, ele pode discordar do julgamento de um radiologista.
Em segundo lugar, o escopo da avaliação. As pontuações de benchmark costumam ser a acurácia em perguntas estruturadas. O resumo não diz nada sobre a qualidade dos laudos completos, os tipos de achados que passaram despercebidos nem os efeitos sobre as decisões clínicas, e também não descreve os hospitais ou as condições de imagem por trás dos três benchmarks.
Terceiro, a construção do Rad-CoT. As trajetórias são descritas como causalmente ordenadas, mas o resumo não diz quem as verificou nem como. Quaisquer vieses que o raciocínio de treinamento contenha, o modelo os aprenderá junto.
Quarto, reprodutibilidade. Os dados de seleção indicam zero estrelas no GitHub e nenhum repositório público. Este artigo não confirmou se o código ou os dados estão disponíveis.
6. Por que atraiu atenção, e por que o grupo ainda é pequeno
O pipeline de seleção colocou este artigo em Raciocínio e Aprendizado. O tamanho do seu cluster é 1: nenhum outro artigo sobre a mesma questão apareceu nesta janela de coleta, e o único sinal disparado foram os votos na página do artigo no Hugging Face, com 67 votos positivos, 1 comentário e 0 estrelas no GitHub.[2] Os votos positivos mostram que os pesquisadores notaram o artigo. Eles não dizem nada sobre se suas afirmações se sustentam nem se tem valor clínico.
As palavras-chave do artigo ainda mostram onde ele se situa: aprendizado por reforço aumentado por ferramentas, GRPO, ajuste fino supervisionado agêntico, raciocínio fundamentado em evidências. Esses termos se repetem em pesquisas recentes sobre agentes. Este site cobriu recentemente artigos sobre agentes que agem antes de ter evidências completas e sobre como mostrar às pessoas os fundamentos das ações de um agente.
O X-Ragent leva essa linha de trabalho para um domínio específico, o de imagens médicas. A pergunta está mudando de "o agente consegue usar ferramentas?" para "quando ele deve confiar no que as ferramentas retornam?". Um único artigo, porém, não forma um tema. Se essa direção vai se tornar um grupo de trabalhos é algo a acompanhar nas próximas semanas.
7. Onde isso se conecta com a prática farmacêutica e regulatória
Softwares que apoiam o diagnóstico por imagem podem ser regulados como dispositivos médicos. Sua avaliação abrange não apenas números de desempenho, mas também as condições em que podem ou não ser usados. A ideia de manter medições inaplicáveis fora do raciocínio se alinha a essa noção de condições de uso. Um sistema que decide quando uma ferramenta de medição não se aplica e registra essa decisão produz material capaz de sustentar uma explicação.
A recompensa condicionada à precisão também se assemelha a um princípio de garantia de qualidade. Seguir o procedimento não substitui um resultado correto. O procedimento é avaliado depois de confirmar que o resultado está certo. O que é rotina na fabricação e nos testes foi reescrito aqui como um desenho de recompensa.
Os resultados de benchmarks de um preprint não podem ser lidos como desempenho clínico. As empresas farmacêuticas têm mais chance de encontrar esse tipo de tecnologia no apoio à leitura de imagens em ensaios clínicos ou na verificação da consistência dessas leituras. Mesmo nesse caso, o registro de quais medições foram aceitas e quais foram rejeitadas deve ser mantido, a decisão final deve continuar com os médicos, e o registro deve estar aberto a revisão posterior. O que se aplica à prática é menos um número específico do que a ideia de projeto: tratar a busca por evidências e a aceitação de evidências como duas decisões diferentes.