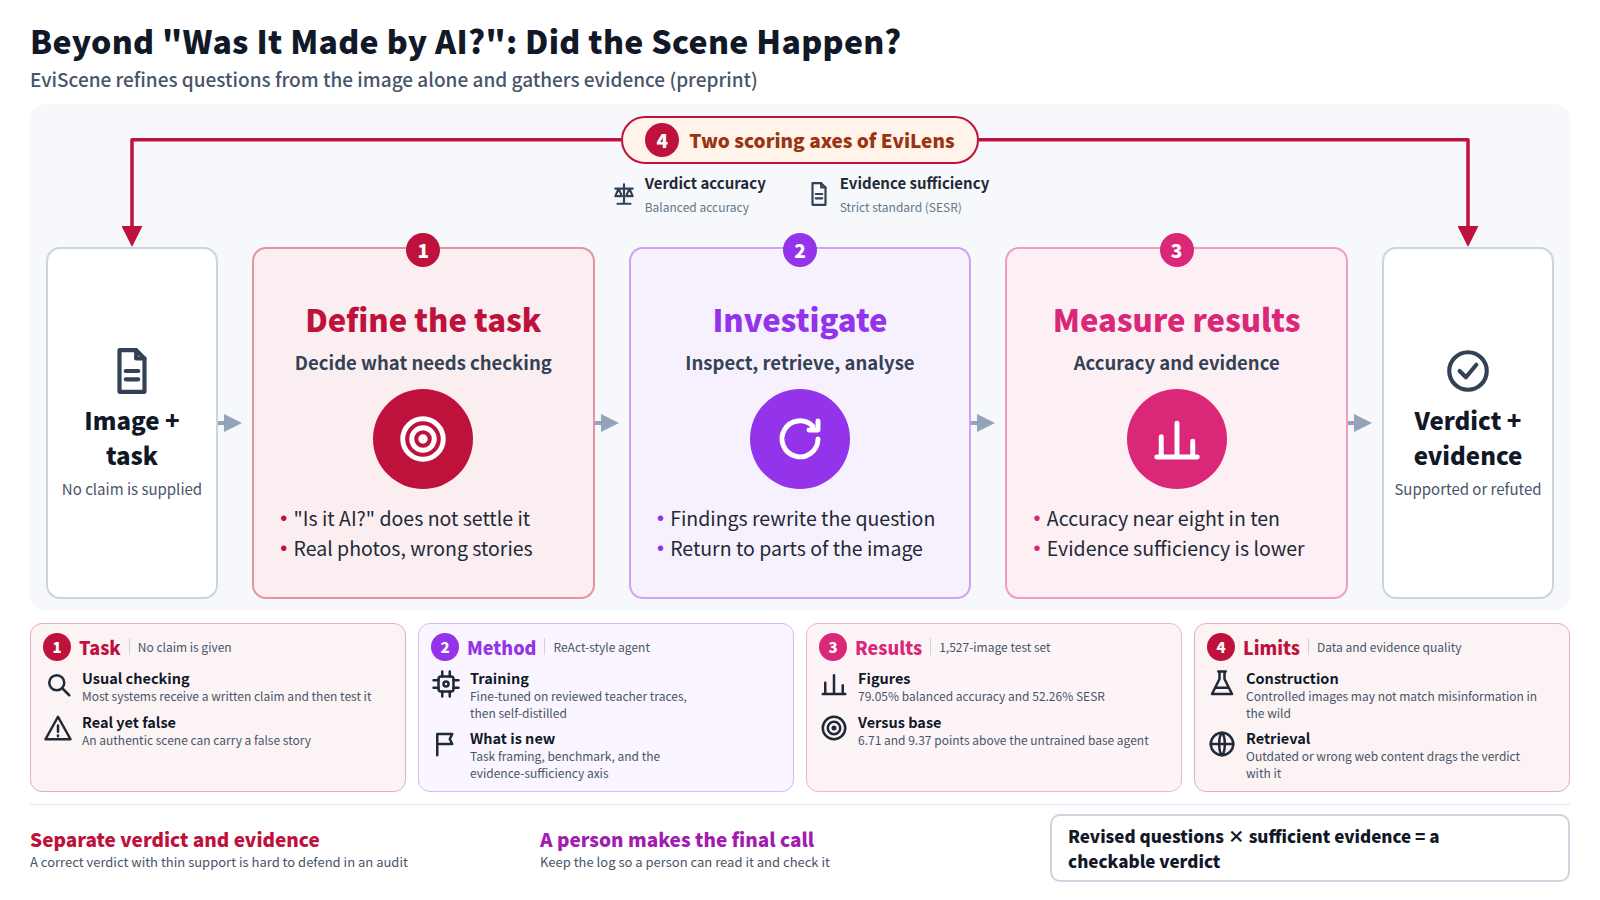
1. «¿Es IA?» y «¿Es verdad?» son preguntas diferentes
Gran parte del trabajo reciente sobre verificación de imágenes se ha centrado en una pregunta: ¿fue producida esta imagen por un modelo generativo? El resumen comienza señalando que esto no responde a la pregunta que importa en la práctica. Saber si una imagen está generada por IA no establece si la situación que representa está respaldada por hechos.[1]
Los casos más difíciles son los corrientes. Una fotografía real se vuelve a publicar como si mostrara otro día u otro lugar. La escena es auténtica, pero la historia que se le asocia es falsa. También ocurre lo contrario: una imagen editada aún puede transmitir algo exacto. En muchos de estos casos, un detector que dice «real» o «generada» no ayuda.
Hay una segunda dificultad. La mayoría de los sistemas de verificación de hechos reciben una afirmación escrita, como "esta foto muestra X", y luego la ponen a prueba. Este artículo elimina esa afirmación. El sistema solo recibe la imagen y una instrucción genérica de verificarla. Debe decidir por sí mismo qué merece ser comprobado.
2. La idea central: revisar la pregunta mientras se investiga
Los autores definen la tarea de la siguiente manera. Dada una imagen y una instrucción de verificación genérica, el sistema devuelve un veredicto, ya sea respaldado o refutado, junto con una explicación basada en evidencia. Como no se proporciona ninguna afirmación, el sistema debe acotar sus preguntas factuales a medida que avanza la investigación y hacer coincidir la evidencia externa que encuentra con la situación específica de la imagen.
EviScene está diseñado para esta tarea. Según el resumen, es un agente multimodal al estilo ReAct que alterna tres acciones: inspeccionar la imagen, recuperar información externa y analizar la evidencia. ReAct es un marco anterior en el que un modelo de lenguaje intercala pasos de razonamiento con acciones como la búsqueda.[4]
Esta revisión reduce el método a un solo punto: el agente usa los nuevos hallazgos para reescribir sus preguntas y volver a las partes relevantes de la imagen. No sigue buscando con la pregunta con la que empezó. Cuando no hay una afirmación en la que anclar la búsqueda, sostienen los autores, este ir y venir es lo que determina la calidad del veredicto.
También se describe la receta de entrenamiento. Primero se ajusta (fine-tuning) un modelo de política compacto con trazas de investigación de un modelo maestro que fueron revisadas por humanos. Después se entrena con autodestilación on-policy privilegiada sobre decisiones de sus propias investigaciones que pudieron verificarse. El resumen no indica en qué consiste la información "privilegiada".
3. Qué informa el resumen
- Referencia (EviLens): 10 174 imágenes confirmadas y refutadas, revisadas por expertos, obtenidas tanto de construcción controlada como de recopilación web. Abarca doce tipos de error factual y puntúa tanto la exactitud del veredicto como si la evidencia citada es suficiente.
- Modelo: un agente entrenado sobre una base Qwen3.5-9B.
- Resultados: en un conjunto de prueba de 1,527 imágenes, el agente entrenado alcanza una exactitud balanceada del 79.05% y una Tasa de Suficiencia de Evidencia Estricta (SESR) del 52.26%.
- Comparación: estos son 6.71 y 9.37 puntos porcentuales más altos que el agente base sin entrenar con la misma arquitectura. Se describe su SESR como la más alta entre los agentes evaluados.
Destaca una brecha. La suficiencia de la evidencia es mucho menor que la exactitud del veredicto, lo que significa que un veredicto correcto suele venir acompañado de evidencia que no pasaría una revisión estricta. El resumen no nombra a los otros agentes con los que se comparó ni indica qué tan grandes fueron esas diferencias.
4. Un ejemplo práctico: una foto que circula dentro de una empresa
Consideremos un caso cercano al trabajo farmacéutico. Se publica en un chat interno una foto que muestra un envase desconocido en un estante de farmacia, y la gente empieza a preguntar si es una falsificación. El siguiente intercambio aplica el enfoque de EviScene solo a modo de ilustración; el resumen no indica si el artículo incluyó imágenes de este tipo.
Miembro del personal: Por favor, comprueba si esta foto es real.
Agente: (inspecciona la imagen) Veo la etiqueta del envase, una etiqueta de precio en un estante y un aviso en la tienda. Mi primera pregunta es si este envase coincide con el diseño original actual.
Agente: (busca) El sitio del fabricante tiene un aviso sobre un cambio de envase, y el nuevo diseño coincide con la foto.
Agente: (reformula la pregunta) A continuación: ¿cuándo y dónde se presenta esta foto como tomada? Volveré a mirar el texto del aviso de la tienda.
Agente: Veredicto: respaldado. El aviso oficial coincide con el envase, por lo que la historia de la falsificación no tiene respaldo. No pude confirmar dónde se tomó la foto.
El punto del ejemplo es que la primera pregunta (¿es falso?) y la pregunta revisada (¿cuándo y dónde se tomó?) son distintas. Devolver lo que no pudo confirmarse junto con el veredicto refleja por qué el artículo puntúa la suficiencia de la evidencia por separado de la precisión.
5. Lo que no es nuevo y dónde están los límites
Algunas partes resultan familiares. Intercalar el razonamiento con la búsqueda sigue la línea de trabajo de ReAct. Contrastar afirmaciones con evidencia externa tiene una larga trayectoria de investigación. Destilar las trazas de un modelo maestro en un modelo más pequeño es una técnica estándar. La contribución se entiende mejor como el planteamiento de la tarea (factualidad sin una afirmación dada), el benchmark y una evaluación que pregunta si la evidencia es suficiente, y no solo si el veredicto es correcto.
Las limitaciones son varias. Primero, cómo se construyó EviLens. Las imágenes producidas bajo una construcción controlada facilitan organizar los tipos de error, pero pueden no coincidir con cómo se distribuye la desinformación en el mundo real. El resumen no describe qué tan amplia fue la revisión por expertos.
En segundo lugar, la calidad de la propia evidencia. El agente depende de la recuperación de información. Si el contenido web que encuentra está desactualizado, es erróneo o fue plantado, el veredicto lo seguirá. El resumen no indica cómo se fijaron el alcance ni la fecha de la búsqueda.
Tercero, cómo leer las cifras. Una precisión equilibrada cercana a ocho de cada diez también significa que el agente se equivoca aproximadamente una vez de cada cinco casos, y la suficiencia de la evidencia es aún menor. Este no es un nivel en el que se pueda prescindir de la revisión humana, y los autores no afirman que lo sea.
En cuarto lugar, la reproducibilidad. El resumen dice que se publicarán el código, los modelos y los datos. Es un plan declarado; esta revisión no ha comprobado si la publicación se ha realizado.
6. Por qué este tema se está concentrando ahora
El proceso de selección agrupó este artículo en un clúster de "Agents and Autonomy" de tamaño 2. El otro artículo, "Beyond the Verdict", estudia cómo juzgar y diagnosticar soluciones de programación competitiva sin gastar envíos oficiales, y trata los contraejemplos generados como evidencia verificable.[3]
Las imágenes y los programas son materiales muy distintos. Lo que ambos artículos comparten es la negativa a quedarse en un simple veredicto de correcto o incorrecto. Ambos piden al sistema que produzca pruebas que un tercero pueda verificar. A medida que se confían más decisiones a los agentes, la pregunta pasa de si un veredicto es correcto a si alguien puede auditarlo después, y ambos artículos incorporan ese requisito en su evaluación.
Para que conste, las señales son modestas. En la página del artículo en Hugging Face, el trabajo tiene 44 votos positivos y 1 comentario, y su repositorio de GitHub tiene 0 estrellas.[2] Los votos a favor muestran que los investigadores se fijaron en el artículo. No dicen nada sobre si sus afirmaciones se sostienen ni sobre si es útil en la práctica. Un grupo de dos es pequeño, y sería prematuro calificarlo de tendencia plenamente formada.
7. Dónde se conecta esto con el trabajo farmacéutico y regulatorio
Las empresas farmacéuticas reciben constantemente imágenes de origen incierto: fotos de productos en redes sociales, envases que podrían ser falsificados, imágenes adjuntas a consultas sobre eventos adversos y fotos propuestas para material promocional cuya fuente debe verificarse. Ninguno de estos casos se resuelve preguntando si la imagen fue generada. Lo que importa es si la situación representada es real.
La decisión de diseño más relevante para la práctica es la separación entre el veredicto y la suficiencia de su evidencia. En las decisiones reguladas, el registro de cómo se llegó a una conclusión suele importar tanto como la conclusión. Un veredicto correcto con un respaldo escaso es difícil de defender en una auditoría. Puntuar la suficiencia de la evidencia en un eje propio ofrece una forma de pensar en los criterios de aceptación cuando se incorpora la IA al trabajo de verificación.
Aun así, un agente como este se situaría en el nivel de la clasificación inicial y de un borrador de registro de investigación. Como depende de lo que devuelve la recuperación en un momento dado, sus veredictos están ligados a ese momento. El registro debe conservarse, la decisión final debe seguir en manos de una persona, y esa persona debe poder leer el registro y verificarlo. Lo que se puede extraer de un preprint en esta etapa es menos la cifra concreta de rendimiento y más el hábito de diseño de registrar por separado el veredicto y la evidencia.