1. Manche Thorax-Röntgenbefunde lassen sich nicht allein durch Betrachten klären
Ein Thorax-Röntgenbild zu lesen bedeutet nicht nur, zu benennen, was sichtbar ist. Das Abstract geht von diesem Punkt aus. Die Interpretation erfordert oft, visuelle Befunde mit aufgabenspezifischen Belegen zu kombinieren, statt sich allein auf direkte visuelle Erkennung zu verlassen.[1]
Werkzeuggestützte medizinische Agenten waren eine Antwort darauf. Der Agent gibt Teile der Arbeit an externe Module ab, etwa das Zuschneiden einer Region für eine genauere Betrachtung oder das Segmentieren eines Organs, um dessen Größe zu messen, und führt die Ergebnisse dann in seine Schlussfolgerungen ein. Für Röntgenaufnahmen des Brustkorbs schlugen frühere Arbeiten einen Agenten vor, der solche Werkzeuge für mehrstufiges Schlussfolgern verkettet, zusammen mit einem Bewertungsdatensatz namens ChestAgentBench.[3]
Aufrufen von Tools zu können heißt noch nicht, sie gut aufzurufen. Die Autoren benennen zwei Lücken bei bestehenden Agenten. Erstens fehlt ihnen ein expliziter Mechanismus, um zu lernen, wann zusätzliche Evidenz tatsächlich benötigt wird. Zweitens fehlt ihnen eine Möglichkeit, zu verhindern, dass quantitative Evidenz, die nicht auf das Bild zutrifft, in die diagnostische Argumentation einfließt. Die erste führt dazu, dass Tools zu oft oder gar nicht aufgerufen werden. Die zweite ist gefährlicher: Eine Zahl kann einer falschen Schlussfolgerung Gewicht verleihen, nur weil sie eine Zahl ist.
2. Die Kernidee: Beweissuche von der Zulassung von Messungen trennen
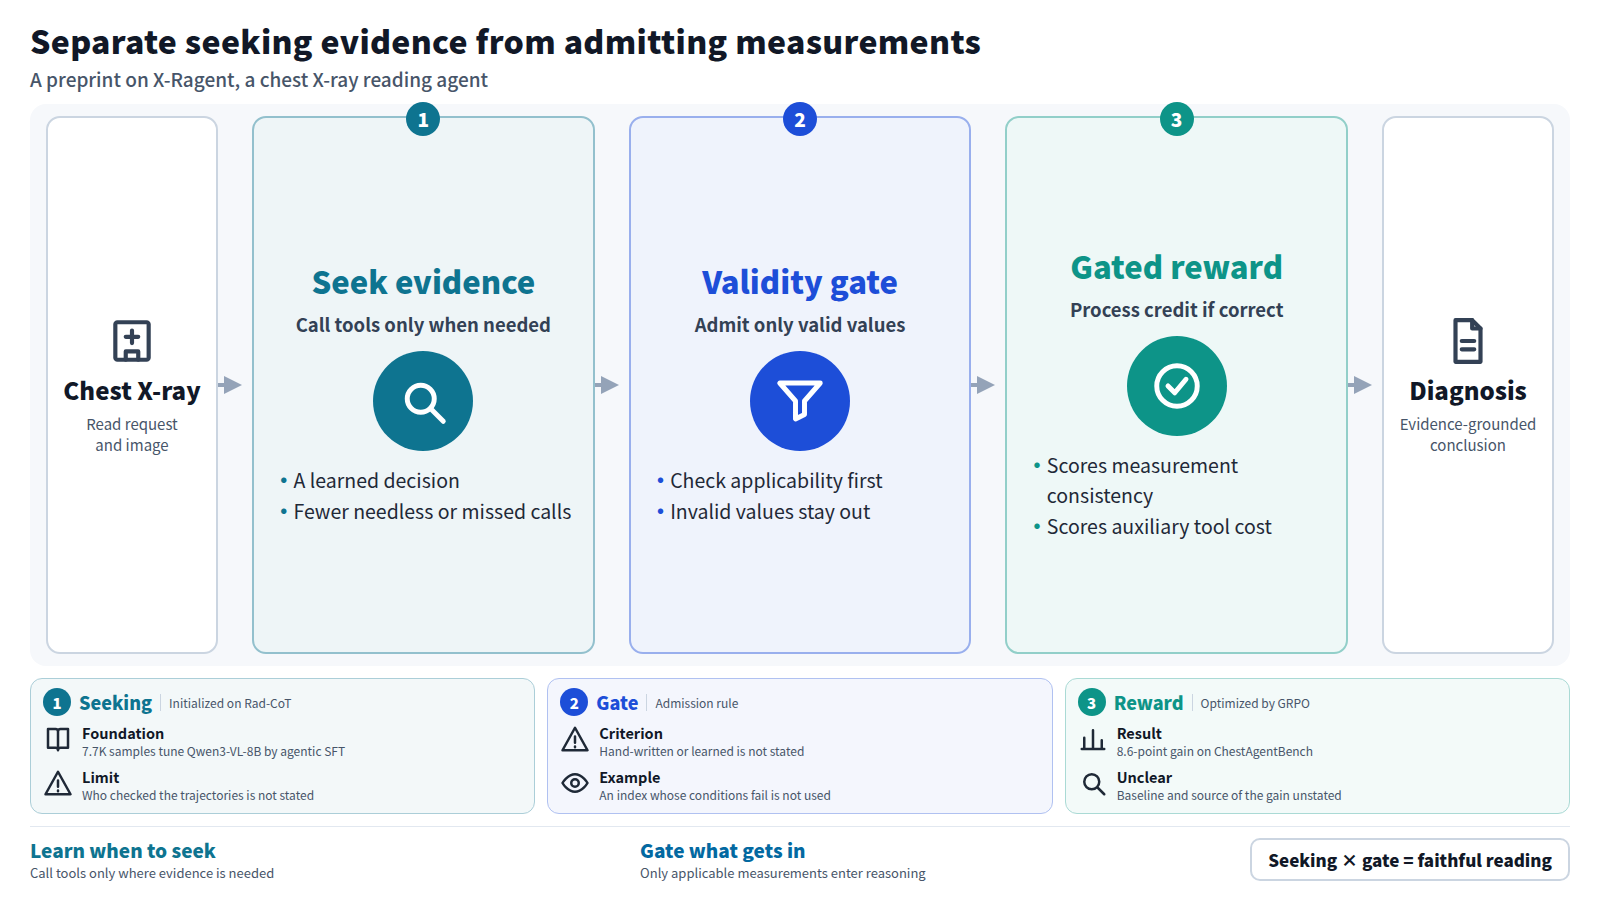
X-Ragent ist ein Post-Training-Framework für werkzeuggestütztes Reinforcement Learning. Seine zentrale Designentscheidung besteht darin, zwei Verhaltensweisen zu entkoppeln. Das eine ist die Entscheidung, ob nach zusätzlicher Evidenz gesucht wird, was das Modell lernt. Das andere ist ein Validitäts-Gate, das prüft, ob eine quantitative Messung auf dieses Bild anwendbar ist, bevor die Messung in die Argumentation einfließen darf. Das Erste ist eine gelernte Entscheidung, das Zweite eine Zulassungsregel für Zahlen.
Das Training besteht aus zwei Phasen. Die Autoren erstellen zunächst Rad-CoT, einen Korpus mit 7,7K Beispielen, der kausal geordnete Tool-Nutzungs-Trajektorien mit diagnostischen Überlegungen im Stil eines Radiologieberichts kombiniert. Damit initialisieren sie Qwen3-VL-8B durch agentisches überwachtes Fine-Tuning.
Anschließend optimieren sie die Policy mit Group Relative Policy Optimization (GRPO), einer bestehenden Methode, die mehrere Antworten auf dieselbe Frage erzeugt und daraus lernt, wie jede einzelne im Vergleich zum Rest der Gruppe abschneidet.[4]Der Beitrag liegt in der Belohnung. Prozessbezogene Terme, einer für die Konsistenz der Messung und einer für die Kosten der Nutzung von Hilfswerkzeugen, werden nur auf Trajektorien angewendet, deren Diagnose korrekt ist. Die Autoren nennen dies eine genauigkeitsgesteuerte Belohnung (Accuracy-gated Reward). Ihr Zweck ist es zu verhindern, dass plausibel wirkendes Prozessverhalten eine falsche Diagnose ausgleicht.
3. Was die Zusammenfassung berichtet
- Daten: Rad-CoT, 7,7K Beispiele, die Tool-Nutzungsverläufe mit berichtsartigem Schlussfolgern kombinieren.
- Training: Qwen3-VL-8B, initialisiert mit agentischem SFT und anschließend mit GRPO unter der genauigkeitsgesteuerten Belohnung optimiert.
- Ergebnisse: die stärksten Ergebnisse in drei Thorax-Röntgen-Benchmarks, darunter eine Verbesserung um 8,6 Punkte auf ChestAgentBench, das vollständig vom Training ausgeschlossen war.
- Lesart der Autoren: Durch gezielte Suche nach Belegen und die Zulassung nur gültiger Messungen unterstützt das System ein treueres, evidenzbasiertes Schlussfolgern.
Mehrere Dinge sind überprüfenswert. Das Abstract nennt nicht, woran der Zugewinn von 8,6 Punkten gemessen wird, ob am Basismodell oder an einem anderen Agenten. Es nennt nur einen der drei Benchmarks. „Stärkste Ergebnisse“ hängt davon ab, welche Systeme zum Vergleich ausgewählt wurden. Und das Abstract zeigt nicht, welcher Teil des Reward-Designs die Verbesserung erklärt.
4. Ein Praxisbeispiel: Die Entscheidung, eine Messung nicht zu verwenden
Um zu verstehen, was eine nicht anwendbare Messung bedeutet, betrachten wir ein Lesebeispiel. Dieses Beispiel veranschaulicht die Idee; ob die Studie diese Situation abdeckt, lässt sich aus dem Abstract nicht feststellen. Bei Röntgenaufnahmen des Brustkorbs verändern die Position des Patienten und die Strahlrichtung die Darstellung des Herzens, und ein Standardindex der Herzgröße ist möglicherweise nicht für jede Aufnahme gültig.
Anfrage: Beurteilen Sie, ob dieses Thorax-Röntgenbild eine Kardiomegalie zeigt.
Agent: (betrachtet das Bild) Ich beurteile die Lungenfelder und das Mediastinum. Eine Größenmessung wäre bei der Herzsilhouette hilfreich, daher rufe ich das Messwerkzeug auf.
Agent: (prüft das Gate) Die Erfassungsbedingungen entsprechen nicht den Annahmen, die diesem Index zugrunde liegen. Die Messung fließt nicht in die Schlussfolgerung ein.
Agent: Ich werde anhand der sichtbaren Befunde ohne die Zahl urteilen und festhalten, dass die Messung abgelehnt wurde.
Entscheidend ist, dass der Aufruf eines Tools und die Annahme seiner Ausgabe getrennte Schritte sind. Die Belohnung nimmt dieselbe Trennung vor. Stellt man die beiden Trainingssignale nebeneinander, wird der Unterschied sichtbar.
Prozessbelohnung stets hinzugefügt
Auch bei falscher Diagnose bringen sorgfältiges Messen und sparsamer Werkzeugeinsatz Punkte. Eine Trajektorie kann dafür verstärkt werden, methodisch zu wirken, obwohl sie zur falschen Antwort führt.
Genauigkeitsgesteuerte Belohnung (X-Ragent)
Messkonsistenz und Werkzeugkosten werden nur für Verläufe mit korrekter Diagnose bewertet. Eine falsche Diagnose erhält keine Prozesspunkte, egal wie sauber die Schritte sind. Zuerst muss das Ergebnis stimmen.
5. Was nicht neu ist und wo die Grenzen liegen
Beginnen wir mit dem, was nicht neu ist. Werkzeugnutzende medizinische Agenten gibt es bereits in früheren Arbeiten, und ChestAgentBench selbst stammt aus solchen Arbeiten.[3] GRPO ist eine etablierte Methode, und das Ausführen von Reinforcement Learning nach überwachtem Fine-Tuning ist ein gängiges Muster beim Post-Training von Sprachmodellen. Neu sind die Trennung zwischen Evidenzsuche und Messungszulassung sowie die Belohnung, die die Prozessgutschrift auf korrekte Trajektorien beschränkt.
Es gibt mehrere Grenzen. Erstens das Kriterium dafür, ob eine Messung anwendbar ist. Die Zusammenfassung sagt nicht, worauf das Gate achtet und ob seine Regeln von Menschen geschrieben oder gelernt wurden. Je nachdem, wie es aufgebaut wurde, kann es von der Einschätzung eines Radiologen abweichen.
Zweitens der Umfang der Evaluation. Benchmark-Werte sind in der Regel die Genauigkeit bei strukturierten Fragen. Das Abstract sagt nichts über die Qualität vollständiger Befunde, die Art der übersehenen Befunde oder die Auswirkungen auf klinische Entscheidungen und beschreibt weder die Krankenhäuser noch die Bildgebungsbedingungen hinter den drei Benchmarks.
Drittens: die Konstruktion von Rad-CoT. Die Verläufe werden als kausal geordnet beschrieben, doch das Abstract sagt nicht, wer sie geprüft hat oder wie. Welche Verzerrungen auch immer in den Trainings-Schlussfolgerungen stecken, das Modell wird sie mitlernen.
Viertens: Reproduzierbarkeit. Die Auswahldaten nennen null GitHub-Sterne und kein öffentliches Repository. Dieser Artikel hat nicht bestätigt, ob Code oder Daten verfügbar sind.
6. Warum es Aufmerksamkeit erregte und warum der Cluster noch klein ist
Die Auswahlpipeline hat diese Arbeit unter Reasoning & Learning eingeordnet. Die Clustergröße beträgt 1: In diesem Erfassungszeitraum tauchte keine weitere Arbeit zur selben Fragestellung auf, und das einzige ausgelöste Signal waren Stimmen auf der Hugging-Face-Paper-Seite, mit 67 Upvotes, 1 Kommentar und 0 GitHub-Sternen.[2] Upvotes zeigen, dass Forschende das Paper bemerkt haben. Sie sagen nichts darüber aus, ob seine Aussagen zutreffen oder ob es klinischen Wert hat.
Die Schlagwörter des Papers zeigen weiterhin, wo es einzuordnen ist: werkzeugunterstütztes Reinforcement Learning, GRPO, agentisches überwachtes Fine-Tuning, evidenzbasiertes Schlussfolgern. Diese Begriffe kehren in der jüngeren Agentenforschung immer wieder. Diese Seite hat kürzlich Paper behandelt, in denen Agenten handeln, bevor ihre Belege vollständig sind, sowie dazu, Menschen die Gründe für die Handlungen eines Agenten zu zeigen.
X-Ragent überträgt diese Forschungslinie auf ein konkretes Gebiet, die medizinische Bildgebung. Die Frage verschiebt sich von „Kann der Agent Werkzeuge nutzen?“ zu „Wann sollte er dem vertrauen, was die Werkzeuge liefern?“. Ein einzelnes Paper macht aber noch kein Thema. Ob sich diese Richtung zu einem Cluster entwickelt, bleibt in den kommenden Wochen zu beobachten.
7. Wo dies an die pharmazeutische und regulatorische Praxis anknüpft
Software, die die Bilddiagnostik unterstützt, kann als Medizinprodukt reguliert werden. Ihre Bewertung umfasst nicht nur Leistungskennzahlen, sondern auch die Bedingungen, unter denen sie eingesetzt werden darf und unter denen nicht. Der Gedanke, nicht anwendbare Messungen aus der Argumentation herauszuhalten, passt zu diesem Begriff der Einsatzbedingungen. Ein System, das entscheidet, wann ein Messinstrument nicht anwendbar ist, und diese Entscheidung protokolliert, liefert Material, das eine Erklärung stützen kann.
Die genauigkeitsgesteuerte Belohnung ähnelt auch einem Prinzip der Qualitätssicherung. Das Befolgen des Verfahrens ersetzt kein korrektes Ergebnis. Das Verfahren wird erst bewertet, nachdem sichergestellt ist, dass das Ergebnis richtig ist. Was in Fertigung und Prüfung Routine ist, wurde hier als Belohnungsdesign neu formuliert.
Benchmark-Ergebnisse aus einem Preprint lassen sich nicht als klinische Leistung lesen. Pharmaunternehmen begegnen dieser Art von Technologie am ehesten bei der Unterstützung der Bildauswertung in klinischen Studien oder bei der Prüfung der Konsistenz dieser Auswertungen. Auch dort muss festgehalten werden, welche Messungen akzeptiert und welche verworfen wurden, die endgültige Entscheidung muss bei den Ärztinnen und Ärzten bleiben, und die Dokumentation muss für spätere Überprüfungen offen sein. Auf die Praxis übertragbar ist weniger eine bestimmte Zahl als die Designidee: Die Suche nach Evidenz und die Akzeptanz von Evidenz als zwei verschiedene Entscheidungen zu behandeln.