1. « Est-ce de l'IA ? » et « Est-ce vrai ? » sont deux questions différentes
Une grande partie des travaux récents sur la vérification d'images s'est concentrée sur une seule question : cette image a-t-elle été produite par un modèle génératif ? Le résumé commence par souligner que cela ne répond pas à la question qui compte en pratique. Savoir si une image est générée par IA ne permet pas d'établir si la situation qu'elle représente est étayée par des faits.[1]
Les cas les plus difficiles sont les cas ordinaires. Une vraie photographie est republiée comme si elle montrait un autre jour ou un autre lieu. La scène est authentique, mais le récit qui l'accompagne est faux. L'inverse existe aussi : une image retouchée peut encore transmettre quelque chose d'exact. Dans bon nombre de ces cas, un détecteur qui répond « réel » ou « généré » n'est d'aucune aide.
Il existe une seconde difficulté. La plupart des systèmes de vérification des faits reçoivent une affirmation écrite, par exemple « cette photo montre X », puis la testent. Cet article supprime cette affirmation. Le système reçoit seulement l'image et une instruction générique de la vérifier. Il doit décider lui-même ce qui mérite d'être vérifié.
2. L'idée centrale : réviser la question au fil de l'enquête
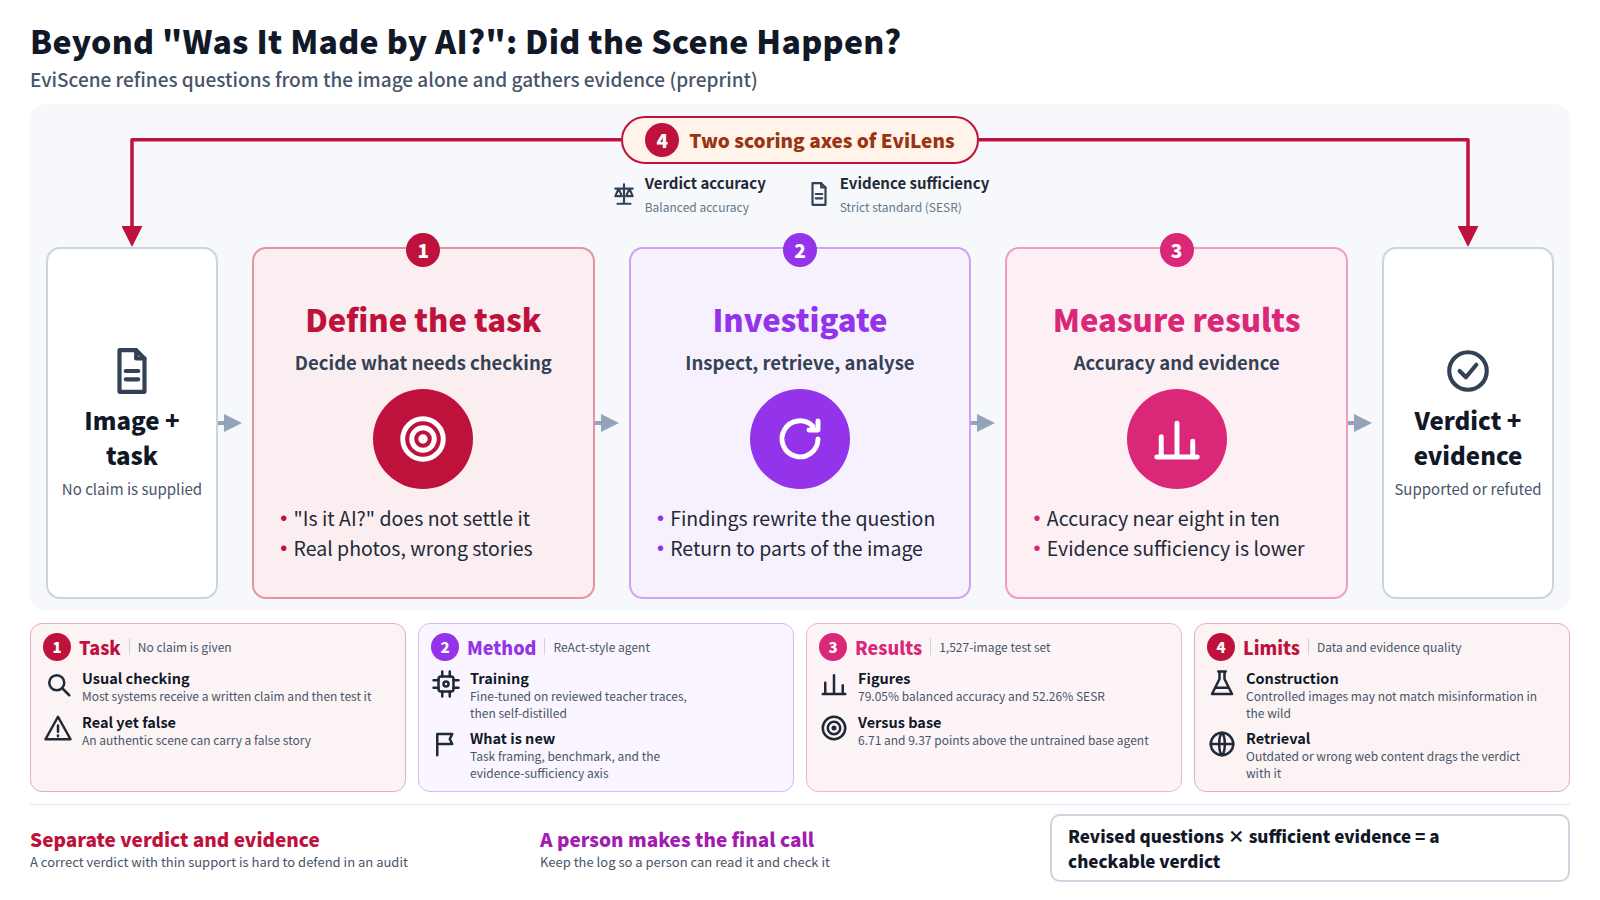
Les auteurs définissent la tâche comme suit. À partir d'une image et d'une instruction de vérification générique, le système renvoie un verdict, étayé ou réfuté, accompagné d'une explication fondée sur des preuves. Aucune affirmation n'étant fournie, le système doit affiner ses questions factuelles au fil de l'enquête et faire correspondre les preuves externes qu'il trouve à la situation précise montrée par l'image.
EviScene est conçu pour cette tâche. Selon le résumé, il s'agit d'un agent multimodal de type ReAct qui alterne entre trois actions : examiner l'image, rechercher des informations extérieures et analyser les preuves. ReAct est un cadre antérieur dans lequel un modèle de langage entrelace des étapes de raisonnement avec des actions telles que la recherche.[4]
Cette revue ramène la méthode à un seul point : l'agent utilise les nouvelles découvertes pour réécrire ses questions et revenir aux parties pertinentes de l'image. Il ne continue pas à chercher avec la question de départ. Lorsqu'aucune affirmation ne sert d'ancrage à la recherche, soutiennent les auteurs, ce va-et-vient détermine la qualité du verdict.
La méthode d'entraînement est également décrite. Une politique compacte est d'abord affinée sur des traces d'investigation issues d'un modèle enseignant, révisées par des humains. Elle est ensuite entraînée par auto-distillation on-policy privilégiée sur des décisions issues de ses propres investigations qui ont pu être vérifiées. Le résumé n'indique pas en quoi consistent les informations « privilégiées ».
3. Ce que rapporte le résumé
- Référence (EviLens) : 10 174 images étayées et réfutées, examinées par des experts, issues à la fois d'une construction contrôlée et d'une collecte sur le web. Le jeu de données couvre douze types d'erreurs factuelles et évalue à la fois l'exactitude du verdict et le caractère suffisant des preuves citées.
- Modèle : un agent entraîné sur une base Qwen3.5-9B.
- Résultats : sur un jeu de test de 1 527 images, l'agent entraîné atteint une exactitude équilibrée de 79,05 % et un taux de suffisance stricte des preuves (SESR) de 52,26 %.
- Comparaison : ces valeurs sont supérieures de 6,71 et 9,37 points de pourcentage à celles de l'agent de base non entraîné sur le même modèle. Son SESR est décrit comme le plus élevé parmi les agents évalués.
Un écart ressort. La suffisance des preuves est nettement inférieure à l'exactitude du verdict, ce qui signifie qu'un verdict correct s'accompagne souvent de preuves qui ne résisteraient pas à un examen rigoureux. Le résumé ne nomme pas les autres agents auxquels la comparaison a été faite et n'indique pas l'ampleur de ces différences.
4. Un exemple concret : une photo qui circule au sein d'une entreprise
Prenons un cas proche du domaine pharmaceutique. Une photo est publiée dans une messagerie interne, montrant un emballage inconnu sur une étagère de pharmacie, et l'on se demande s'il s'agit d'une contrefaçon. L'échange ci-dessous applique l'approche d'EviScene à titre purement illustratif ; le résumé ne précise pas si l'article incluait des images de ce type.
Membre du personnel :Veuillez vérifier si cette photo est authentique.
Agent : (examine l'image) Je vois l'étiquette de l'emballage, une étiquette de prix en rayon et un avis dans le magasin. Ma première question est de savoir si cet emballage correspond au design authentique actuel.
Agent : (recherche) Le site du fabricant contient un avis concernant un changement d'emballage, et le nouveau design correspond à la photo.
Agent : (reformule la question) Ensuite : quand et où cette photo est-elle présentée comme ayant été prise ? Je vais relire le texte de l'avis du magasin.
Agent : Verdict : étayé. L'avis officiel correspond à l'emballage, donc la thèse de la contrefaçon n'est pas étayée. Je n'ai pas pu confirmer où la photo a été prise.
Le point de l'exemple est que la première question (est-ce un faux ?) et la question reformulée (quand et où a-t-elle été prise ?) sont différentes. Rendre ce qui n'a pas pu être confirmé en même temps que le verdict reflète la raison pour laquelle l'article note la suffisance des preuves séparément de l'exactitude.
5. Ce qui n'est pas nouveau, et où se situent les limites
Certains éléments sont familiers. L'entrelacement du raisonnement et de la recherche suit la lignée de travaux ReAct. La vérification des affirmations par des preuves extérieures a une longue histoire de recherche. La distillation des traces d'un modèle enseignant dans un modèle plus petit est une technique standard. La contribution se comprend mieux comme le cadrage de la tâche (la factualité sans affirmation fournie), le benchmark, et une évaluation qui demande si les preuves sont suffisantes, et pas seulement si le verdict est juste.
Les limites sont multiples. D'abord, la manière dont EviLens a été construit. Les images produites dans une construction contrôlée facilitent l'organisation des types d'erreurs, mais peuvent ne pas correspondre à la façon dont la désinformation est diffusée dans la réalité. Le résumé ne décrit pas l'étendue de la revue par des experts.
Deuxièmement, la qualité des preuves elles-mêmes. L'agent s'appuie sur la recherche d'informations. Si le contenu web qu'il trouve est obsolète, erroné ou planté, le verdict le suivra. Le résumé ne dit pas comment le périmètre ou la date de la recherche ont été fixés.
Troisièmement, la manière de lire les chiffres. Une exactitude équilibrée proche de huit sur dix signifie aussi que l'agent se trompe environ une fois sur cinq, et la suffisance des preuves est encore plus faible. Ce niveau ne permet pas de se passer de la relecture humaine, et les auteurs ne le prétendent pas.
Quatrièmement, la reproductibilité. Le résumé indique que le code, les modèles et les données seront publiés. Il s'agit d'un projet annoncé ; cette revue n'a pas vérifié si la publication a eu lieu.
6. Pourquoi ce sujet émerge maintenant
Le processus de sélection a regroupé cet article dans un groupe « Agents et autonomie » de taille 2. L'autre article, « Beyond the Verdict », étudie le jugement et le diagnostic de solutions de programmation compétitive sans dépenser de soumissions officielles, et traite les contre-exemples générés comme des preuves vérifiables.[3]
Les images et les programmes sont des matières très différentes. Ce que les deux articles ont en commun, c'est le refus de s'arrêter à un simple verdict juste ou faux. Tous deux demandent au système de produire des preuves qu'un tiers peut vérifier. À mesure que les agents se voient confier davantage de décisions, la question passe de savoir si un verdict est correct à savoir si quelqu'un peut l'auditer après coup, et les deux articles intègrent cette exigence dans leur évaluation.
Pour mémoire, les signaux sont modestes. Sur la page de l'article sur Hugging Face, le travail compte 44 votes positifs et 1 commentaire, et son dépôt GitHub compte 0 étoile.[2] Les votes positifs montrent que les chercheurs ont remarqué l'article. Ils ne disent rien sur la validité de ses affirmations ni sur son utilité pratique. Un groupe de deux est petit, et il serait prématuré d'y voir une tendance pleinement formée.
7. Où cela rejoint le travail pharmaceutique et réglementaire
Les entreprises pharmaceutiques reçoivent en permanence des images d'origine incertaine : photos de produits sur les réseaux sociaux, emballages éventuellement contrefaits, images jointes à des demandes sur des événements indésirables, et photos proposées pour des supports promotionnels dont la source doit être vérifiée. Aucun de ces cas ne se règle en demandant si l'image a été générée. Ce qui compte, c'est de savoir si la situation représentée est réelle.
Le choix de conception le plus pertinent en pratique est la séparation entre le verdict et le caractère suffisant de ses preuves. Dans les décisions réglementées, la trace de la manière dont une conclusion a été atteinte compte souvent autant que la conclusion elle-même. Un verdict correct, mais faiblement étayé, est difficile à défendre lors d'un audit. Évaluer le caractère suffisant des preuves sur un axe distinct permet de réfléchir aux critères d'acceptation lorsque l'IA est ajoutée au travail de vérification.
Même ainsi, un agent de ce type se situerait au niveau du triage de première passe et d'un brouillon de journal d'enquête. Comme il dépend de ce que la recherche renvoie à un instant donné, ses verdicts sont liés à cet instant. Le journal doit être conservé, la décision finale doit rester entre les mains d'une personne, et cette personne doit pouvoir lire le journal et le vérifier. Ce que l'on peut retenir d'un preprint à ce stade, c'est moins le chiffre de performance précis que l'habitude de conception consistant à consigner séparément le verdict et les preuves.