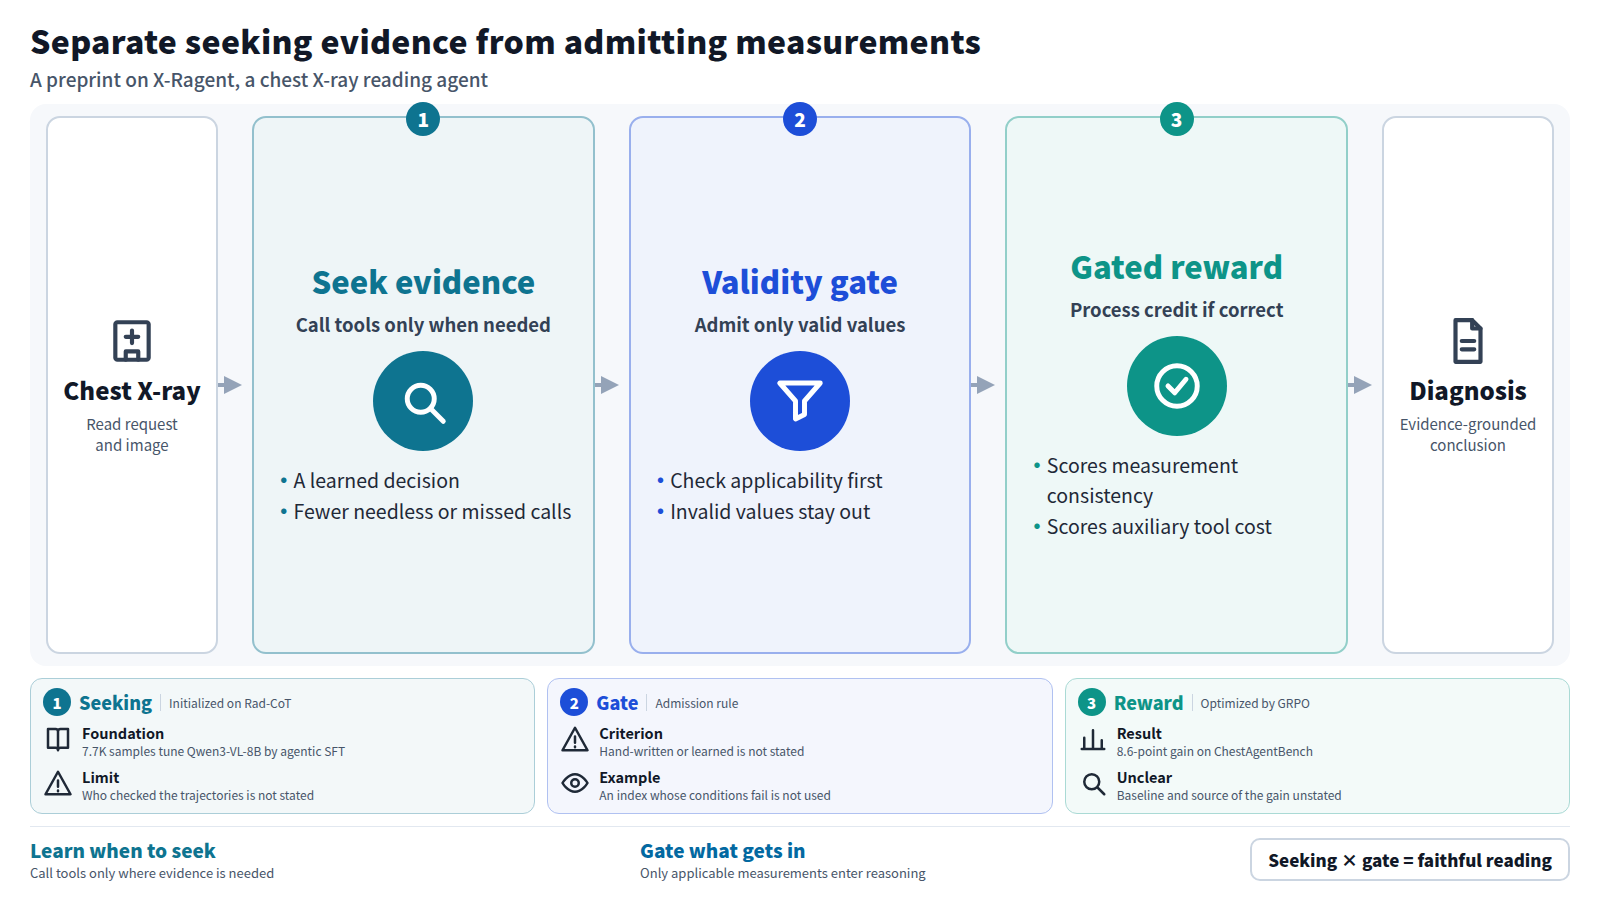
1. छाती के कुछ एक्स-रे केवल देखकर तय नहीं किए जा सकते
छाती का एक्स-रे पढ़ना केवल यह बताना नहीं है कि क्या दिख रहा है। सार (abstract) इसी बिंदु से शुरू होता है। व्याख्या के लिए अक्सर केवल सीधी दृश्य पहचान पर निर्भर रहने के बजाय दृश्य निष्कर्षों को कार्य-विशिष्ट साक्ष्य के साथ जोड़ना पड़ता है।[1]
टूल-संवर्धित चिकित्सा एजेंट इसका एक उत्तर रहे हैं। एजेंट काम के कुछ हिस्से बाहरी मॉड्यूल को सौंप देता है, जैसे नज़दीक से देखने के लिए किसी क्षेत्र को क्रॉप करना या किसी अंग का आकार मापने के लिए उसे सेगमेंट करना, और फिर परिणामों को अपने तर्क में शामिल करता है। चेस्ट एक्स-रे के लिए, पहले के काम में बहु-चरणीय तर्क हेतु ऐसे टूल्स को जोड़ने वाला एक एजेंट प्रस्तावित किया गया था, साथ ही ChestAgentBench नामक एक मूल्यांकन सेट भी।[3]
टूल बुला पाना और उन्हें अच्छी तरह बुलाना एक बात नहीं है। लेखक मौजूदा एजेंटों की दो कमियां बताते हैं। पहली, उनमें यह सीखने की स्पष्ट व्यवस्था नहीं है कि सहायक साक्ष्य की वास्तव में कब जरूरत है। दूसरी, उनमें ऐसा तरीका नहीं है जो छवि पर लागू न होने वाले मात्रात्मक साक्ष्य को निदान संबंधी तर्क में आने से रोके। पहली कमी के कारण टूल जरूरत से ज्यादा बुलाए जाते हैं या बिल्कुल नहीं बुलाए जाते। दूसरी ज्यादा खतरनाक है: कोई संख्या केवल संख्या होने के कारण गलत निष्कर्ष को वजन दे सकती है।
2. मूल विचार: साक्ष्य खोजने को माप स्वीकार करने से अलग करना
X-Ragent टूल-संवर्धित रीइन्फोर्समेंट लर्निंग के लिए एक पोस्ट-ट्रेनिंग फ्रेमवर्क है। इसका केंद्रीय डिज़ाइन-निर्णय दो व्यवहारों को अलग करना है। एक है यह तय करना कि सहायक साक्ष्य खोजने जाना है या नहीं, जिसे मॉडल सीखता है। दूसरा है एक वैधता-द्वार (validity gate), जो तर्क में मात्रात्मक माप को शामिल करने से पहले जांचता है कि वह माप इस छवि पर लागू होता है या नहीं। पहला एक सीखा हुआ निर्णय है; दूसरा संख्याओं के लिए प्रवेश-नियम है।
प्रशिक्षण के दो चरण हैं। लेखक पहले Rad-CoT तैयार करते हैं, जो 7.7K नमूनों का एक संग्रह है और जिसमें कारण-क्रम में सजे टूल-उपयोग के प्रक्षेप-पथों को रेडियोलॉजी रिपोर्ट की शैली में लिखे नैदानिक तर्क के साथ जोड़ा गया है। इसके बाद वे एजेंटिक सुपरवाइज़्ड फ़ाइन-ट्यूनिंग के ज़रिए इससे Qwen3-VL-8B को प्रारंभिक रूप से तैयार करते हैं।
इसके बाद वे नीति को Group Relative Policy Optimization (GRPO) से अनुकूलित करते हैं, जो एक मौजूदा तरीका है जो एक ही सवाल के कई उत्तरों का नमूना लेता है और यह देखकर सीखता है कि हर उत्तर समूह के बाकी उत्तरों की तुलना में कैसा है।[4] योगदान रिवॉर्ड में निहित है। प्रक्रिया-स्तर के दो पद, एक माप की संगति के लिए और एक सहायक उपकरणों के उपयोग की लागत के लिए, केवल उन ट्रैजेक्टरी पर लागू होते हैं जिनका निदान सही है। लेखक इसे एक accuracy-gated reward कहते हैं। इसका उद्देश्य यह रोकना है कि विश्वसनीय दिखने वाला प्रक्रिया-व्यवहार गलत निदान की भरपाई कर दे।
3. एब्स्ट्रैक्ट क्या बताता है
- डेटा: Rad-CoT, 7.7K नमूने जो टूल-उपयोग के प्रक्षेप-पथों को रिपोर्ट-शैली के तर्क के साथ जोड़ते हैं।
- प्रशिक्षण: Qwen3-VL-8B को एजेंटिक SFT से इनिशियलाइज़ किया गया, फिर सटीकता-नियंत्रित रिवॉर्ड के तहत GRPO से ऑप्टिमाइज़ किया गया।
- परिणाम: तीन चेस्ट एक्स-रे बेंचमार्क में सबसे मजबूत परिणाम, जिनमें ChestAgentBench पर 8.6 अंकों का सुधार भी शामिल है, जिसे प्रशिक्षण से पूरी तरह बाहर रखा गया था.
- लेखकों की पठन सामग्री: चुनिंदा तरीके से साक्ष्य खोजकर और केवल वैध माप स्वीकार करके, यह प्रणाली अधिक विश्वसनीय, साक्ष्य-आधारित तर्क का समर्थन करती है.
कई बातें जाँचने लायक हैं। सार यह नहीं बताता कि 8.6 अंकों की बढ़त किसके मुकाबले मापी गई है, बेस मॉडल के या किसी अन्य एजेंट के। इसमें तीन में से केवल एक बेंचमार्क का नाम है। "सबसे मजबूत परिणाम" इस पर निर्भर करता है कि तुलना के लिए कौन-से सिस्टम चुने गए। और सार यह नहीं दिखाता कि रिवॉर्ड डिज़ाइन का कौन-सा हिस्सा सुधार का कारण है।
4. एक व्यावहारिक उदाहरण: माप का उपयोग न करने का निर्णय
अनुपयुक्त माप का क्या अर्थ है, यह समझने के लिए एक पठन परिदृश्य पर विचार करें। यह उदाहरण केवल विचार को स्पष्ट करता है; पेपर इस स्थिति को कवर करता है या नहीं, यह सार से तय नहीं किया जा सकता। चेस्ट एक्स-रे में मरीज़ की स्थिति और किरण की दिशा हृदय के दिखने के ढंग को बदल देती है, और हृदय के आकार का मानक सूचकांक हर छवि के लिए मान्य नहीं हो सकता।
अनुरोध: आकलन करें कि क्या इस चेस्ट एक्स-रे में कार्डियोमेगाली दिखती है।
एजेंट: (इमेज का निरीक्षण करता है) फेफड़ों के क्षेत्रों और मीडियास्टिनम की समीक्षा कर रहा हूँ। हृदय की छाया के लिए आकार का माप उपयोगी होगा, इसलिए मैं माप उपकरण को कॉल करूँगा।
एजेंट: (गेट की जाँच करता है) इमेज लेने की स्थितियाँ इस इंडेक्स के पीछे की मान्यताओं को पूरा नहीं करतीं। यह माप तर्क-प्रक्रिया में शामिल नहीं किया जाएगा।
एजेंट: मैं संख्या के बिना, दिखाई देने वाले निष्कर्षों के आधार पर निर्णय लूँगा, और दर्ज करूँगा कि माप अस्वीकार कर दिया गया था।
मुद्दा यह है कि किसी टूल को कॉल करना और उसके आउटपुट को स्वीकार करना अलग-अलग चरण हैं। रिवॉर्ड भी यही अलगाव करता है। दोनों प्रशिक्षण संकेतों को साथ-साथ रखने से अंतर दिखता है।
प्रक्रिया पुरस्कार हमेशा जोड़ा गया
निदान गलत होने पर भी, सावधानीपूर्ण माप और टूल का किफायती उपयोग अंक दिलाता है। गलत उत्तर तक पहुँचने के बावजूद व्यवस्थित दिखने के लिए किसी प्रक्षेप-पथ को मज़बूती मिल सकती है।
सटीकता-आधारित पुरस्कार (X-Ragent)
मापन की संगति और टूल की लागत का स्कोर केवल उन ट्रैजेक्टरी के लिए दिया जाता है जिनका निदान सही है। गलत निदान पर प्रक्रिया का कोई श्रेय नहीं मिलता, चाहे चरण कितने ही व्यवस्थित हों। निष्कर्ष का सही होना पहले ज़रूरी है।
5. क्या नया नहीं है, और सीमाएँ कहाँ हैं
शुरुआत उससे करें जो नया नहीं है। औज़ारों का उपयोग करने वाले चिकित्सा एजेंट पहले के शोध में मौजूद हैं, और ChestAgentBench खुद ऐसे ही शोध से आया था।[3] GRPO एक स्थापित विधि है, और सुपरवाइज़्ड फ़ाइन-ट्यूनिंग के बाद रीइन्फोर्समेंट लर्निंग चलाना भाषा-मॉडल के पोस्ट-ट्रेनिंग में एक आम तरीका है। नई बातें हैं साक्ष्य खोजने और माप को स्वीकार करने का विभाजन, और वह रिवॉर्ड जो प्रक्रिया का श्रेय केवल सही ट्रैजेक्टरी तक सीमित रखता है।
कई सीमाएँ हैं। पहली, यह कसौटी कि कोई माप लागू होता है या नहीं। सार-संक्षेप यह नहीं बताता कि यह गेट किस चीज़ को देखता है, या उसके नियम लोगों ने लिखे थे या सीखे गए थे। इसे कैसे बनाया गया, इस पर निर्भर करते हुए, यह किसी रेडियोलॉजिस्ट के निर्णय से असहमत हो सकता है।
दूसरा, मूल्यांकन का दायरा। बेंचमार्क स्कोर आमतौर पर संरचित प्रश्नों पर सटीकता होते हैं। सार में पूरी रिपोर्टों की गुणवत्ता, छूट गए निष्कर्षों के प्रकार या क्लिनिकल निर्णयों पर प्रभाव के बारे में कुछ नहीं कहा गया है, और यह भी नहीं बताया गया है कि तीनों बेंचमार्क के पीछे कौन-से अस्पताल या इमेजिंग परिस्थितियाँ हैं।
तीसरा, Rad-CoT का निर्माण। इन प्रक्षेप-पथों को कार्य-कारण क्रम में बताया गया है, लेकिन सार (abstract) यह नहीं बताता कि इन्हें किसने जाँचा या कैसे जाँचा। प्रशिक्षण के तर्क में जो भी पूर्वाग्रह होंगे, मॉडल उनके साथ-साथ उन्हें भी सीख लेगा।
चौथा, पुनरुत्पादन क्षमता। चयन डेटा में GitHub स्टार शून्य और कोई सार्वजनिक रिपॉज़िटरी नहीं दर्शाई गई है। इस लेख में यह पुष्टि नहीं हुई है कि कोड या डेटा उपलब्ध हैं या नहीं।
6. इसने ध्यान क्यों खींचा, और क्लस्टर अब भी छोटा क्यों है
चयन पाइपलाइन ने इस पेपर को Reasoning & Learning के अंतर्गत रखा। इसका क्लस्टर आकार 1 है: इस संग्रह अवधि में उसी प्रश्न पर कोई अन्य पेपर नहीं मिला, और केवल Hugging Face पेपर पेज पर वोट का संकेत सक्रिय हुआ, जिसमें 67 अपवोट, 1 टिप्पणी और 0 GitHub स्टार हैं।[2] Upvotes show that researchers noticed the paper. They say nothing about whether its claims hold or whether it has clinical value.
पेपर के कीवर्ड अब भी बताते हैं कि वह कहाँ स्थित है: टूल-ऑगमेंटेड रीइनफ़ोर्समेंट लर्निंग, GRPO, एजेंटिक सुपरवाइज़्ड फ़ाइन-ट्यूनिंग, साक्ष्य-आधारित तर्क। ये शब्द हाल के एजेंट शोध में बार-बार आते हैं। इस साइट ने हाल ही में ऐसे पेपरों को कवर किया है जो अपने साक्ष्य पूरे होने से पहले कार्य करने वाले एजेंटों पर और लोगों को एजेंट के कार्यों के आधार दिखाने पर हैं।
X-Ragent इस शोध-धारा को एक खास क्षेत्र, यानी मेडिकल इमेजिंग, में ले जाता है। सवाल अब "क्या एजेंट टूल इस्तेमाल कर सकता है?" से बदलकर "टूल जो लौटाते हैं, उस पर कब भरोसा करना चाहिए?" बन रहा है। हालांकि एक शोध-पत्र से कोई विषय नहीं बन जाता। यह दिशा एक समूह के रूप में बढ़ती है या नहीं, यह आने वाले हफ्तों में देखने लायक बात है।
7. यह फ़ार्मास्युटिकल और नियामक व्यवहार से कहाँ जुड़ता है
छवि-आधारित निदान में सहायता करने वाले सॉफ़्टवेयर को चिकित्सा उपकरण के रूप में विनियमित किया जा सकता है। उसके आकलन में सिर्फ़ प्रदर्शन के आँकड़े ही नहीं, बल्कि वे शर्तें भी शामिल होती हैं जिनमें उसका उपयोग किया जा सकता है और नहीं किया जा सकता। अनुपयुक्त मापों को तर्क की कड़ियों से बाहर रखने का विचार उपयोग की शर्तों की इसी धारणा से मेल खाता है। जो प्रणाली यह तय करती है कि कोई माप-उपकरण कब लागू नहीं होता, और उस निर्णय को दर्ज करती है, वह ऐसी सामग्री तैयार करती है जो स्पष्टीकरण का आधार बन सकती है।
सटीकता-आधारित पुरस्कार गुणवत्ता-आश्वासन के सिद्धांत से भी मिलता-जुलता है। प्रक्रिया का पालन करना सही परिणाम का विकल्प नहीं है। परिणाम सही है, यह पुष्टि करने के बाद ही प्रक्रिया का मूल्यांकन किया जाता है। विनिर्माण और परीक्षण में जो आम बात है, उसे यहाँ पुरस्कार डिज़ाइन के रूप में फिर से लिखा गया है।
प्रीप्रिंट के बेंचमार्क नतीजों को नैदानिक प्रदर्शन नहीं माना जा सकता। दवा कंपनियों का इस तरह की तकनीक से सबसे ज्यादा सामना क्लिनिकल ट्रायल में इमेज रीड के सहयोग में, या उन रीड की संगति जांचने में होने की संभावना है। वहां भी यह रिकॉर्ड रखना जरूरी है कि कौन-से मापन स्वीकार किए गए और कौन-से अस्वीकार, अंतिम निर्णय चिकित्सकों के पास ही रहना चाहिए, और रिकॉर्ड बाद की समीक्षा के लिए खुला होना चाहिए। व्यवहार में जो बात काम आती है, वह कोई खास संख्या कम और डिजाइन का विचार ज्यादा है: साक्ष्य खोजने और साक्ष्य स्वीकार करने को दो अलग निर्णय मानें।