1. Certaines lectures de radiographies thoraciques ne peuvent être tranchées par le seul examen visuel
Lire une radiographie thoracique ne consiste pas seulement à nommer ce qui est visible. Le résumé part de ce constat. L'interprétation exige souvent de combiner les observations visuelles avec des éléments propres à la tâche, plutôt que de s'appuyer uniquement sur la reconnaissance visuelle directe.[1]
Les agents médicaux dotés d'outils ont été une réponse à ce problème. L'agent confie une partie du travail à des modules externes, comme recadrer une région pour l'examiner de plus près ou segmenter un organe pour mesurer sa taille, puis intègre les résultats à son raisonnement. Pour les radiographies thoraciques, des travaux antérieurs ont proposé un agent qui enchaîne de tels outils pour un raisonnement en plusieurs étapes, ainsi qu'un jeu d'évaluation appelé ChestAgentBench.[3]
Pouvoir appeler des outils ne revient pas à les appeler à bon escient. Les auteurs identifient deux lacunes dans les agents existants. Premièrement, ils n'ont pas de mécanisme explicite pour apprendre quand des preuves auxiliaires sont réellement nécessaires. Deuxièmement, ils n'ont aucun moyen d'empêcher que des preuves quantitatives qui ne s'appliquent pas à l'image n'entrent dans le raisonnement diagnostique. La première conduit à appeler les outils trop souvent, ou pas du tout. La seconde est plus dangereuse : un chiffre peut donner du poids à une conclusion erronée simplement parce que c'est un chiffre.
2. L'idée centrale : séparer la recherche de preuves de l'admission des mesures
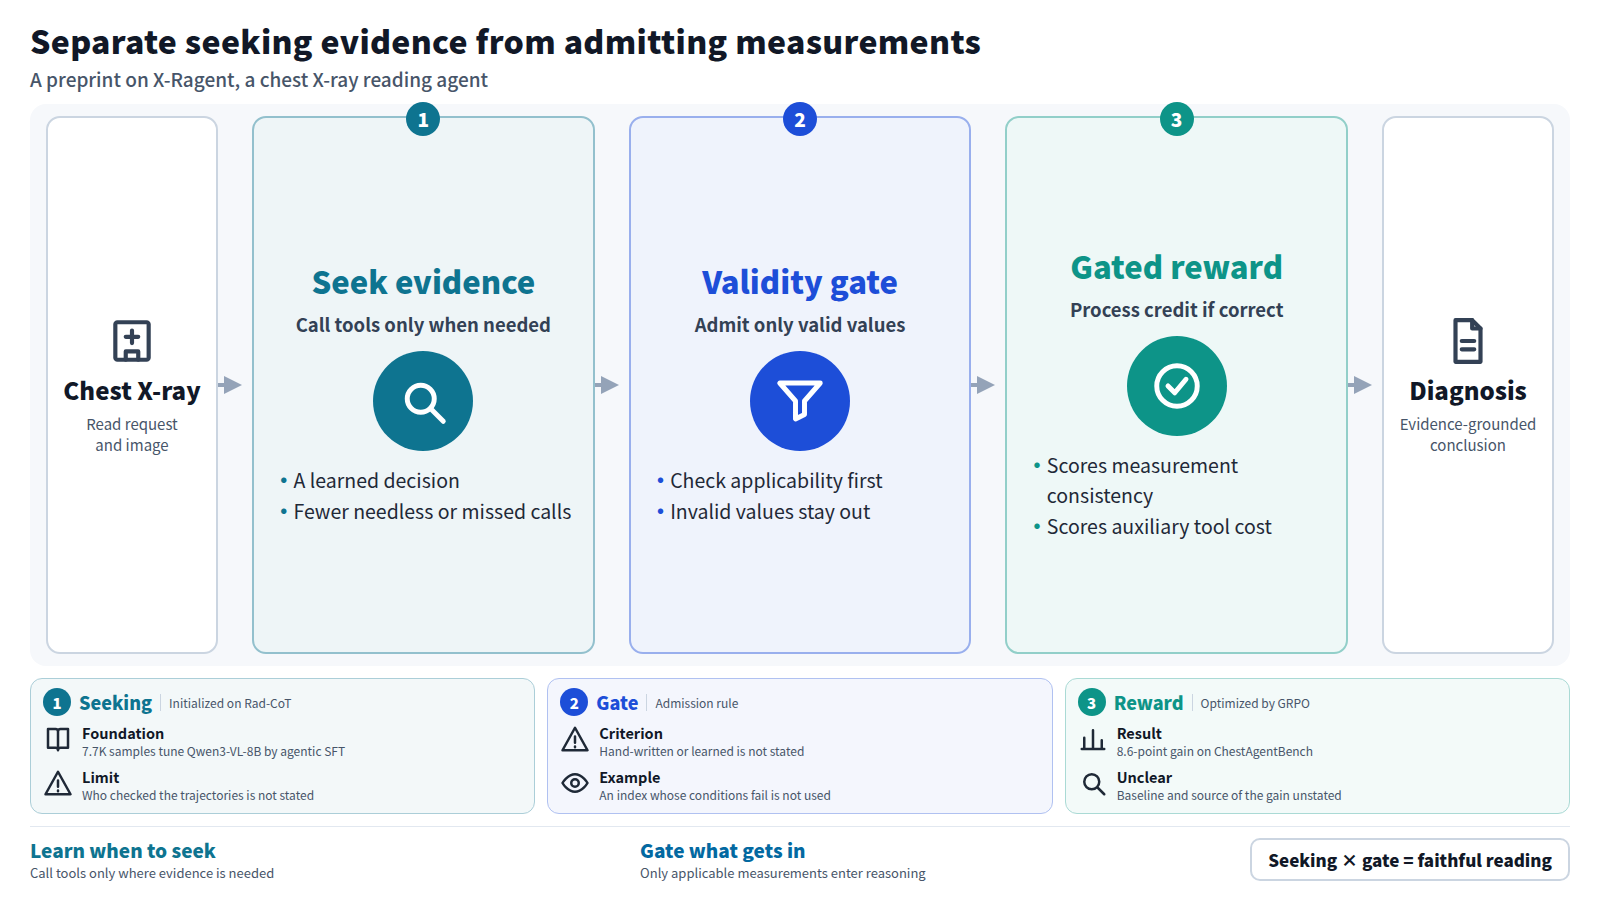
X-Ragent est un cadre de post-entraînement pour l'apprentissage par renforcement augmenté par des outils. Son choix de conception central est de découpler deux comportements. Le premier consiste à décider s'il faut aller chercher des preuves auxiliaires, ce que le modèle apprend. Le second est une porte de validité qui vérifie si une mesure quantitative s'applique à cette image avant que la mesure ne soit admise dans le raisonnement. La première est une décision apprise ; la seconde est une règle d'admission pour les nombres.
La formation se déroule en deux étapes. Les auteurs construisent d'abord Rad-CoT, un corpus de 7,7K échantillons qui associe des trajectoires d'utilisation d'outils ordonnées causalement à un raisonnement diagnostique rédigé dans le style d'un compte rendu de radiologie. Ils l'utilisent pour initialiser Qwen3-VL-8B par un réglage fin supervisé agentique.
Ils optimisent ensuite la politique avec Group Relative Policy Optimization (GRPO), une méthode existante qui échantillonne plusieurs réponses à la même question et apprend à partir de la façon dont chacune se compare au reste du groupe.[4] La contribution réside dans la récompense. Des termes au niveau du processus, l'un pour la cohérence des mesures et l'autre pour le coût d'utilisation des outils auxiliaires, ne sont appliqués qu'aux trajectoires dont le diagnostic est correct. Les auteurs appellent cela une récompense conditionnée à l'exactitude. Son but est d'empêcher qu'un comportement de processus d'apparence plausible ne compense un diagnostic incorrect.
3. Ce que rapporte le résumé
- Données : Rad-CoT, 7.7K échantillons combinant des trajectoires d'utilisation d'outils et un raisonnement de type compte rendu.
- Entraînement : Qwen3-VL-8B initialisé avec un SFT agentique, puis optimisé avec GRPO sous la récompense conditionnée par la précision.
- Résultats : les meilleurs résultats sur trois benchmarks de radiographie thoracique, dont une amélioration de 8.6 points sur ChestAgentBench, entièrement exclu de l'entraînement.
- Lecture des auteurs : en recherchant des preuves de manière sélective et en n'admettant que des mesures valides, le système favorise un raisonnement plus fidèle et fondé sur les preuves.
Plusieurs points méritent d'être vérifiés. Le résumé ne précise pas par rapport à quoi le gain de 8,6 points est mesuré, que ce soit le modèle de base ou un autre agent. Il ne nomme qu'un seul des trois benchmarks. Les « meilleurs résultats » dépendent des systèmes choisis pour la comparaison. Et le résumé ne montre pas quelle partie de la conception de la récompense explique l'amélioration.
4. Un exemple concret : décider de ne pas utiliser une mesure
Pour comprendre ce que signifie une mesure inapplicable, considérons un scénario de lecture. Cet exemple illustre l'idée ; on ne peut pas déterminer à partir du résumé si l'article couvre cette situation. Sur les radiographies thoraciques, la position du patient et la direction du faisceau modifient l'aspect du cœur, et un indice standard de la taille du cœur peut ne pas être valable pour chaque image.
Demande : Évaluez si cette radiographie thoracique montre une cardiomégalie.
Agent : (examine l'image) Examen des champs pulmonaires et du médiastin. Une mesure de taille aiderait pour la silhouette cardiaque ; j'appelle donc l'outil de mesure.
Agent : (vérifie la barrière) Les conditions d'acquisition ne répondent pas aux hypothèses sous-jacentes à cet indice. La mesure n'entrera pas dans le raisonnement.
Agent : Je jugerai à partir des observations visibles sans le chiffre, et j'indiquerai que la mesure a été rejetée.
Le point essentiel est qu'appeler un outil et accepter sa sortie sont deux étapes distinctes. La récompense fait la même séparation. Placer les deux signaux d'entraînement côte à côte permet de voir la différence.
Récompense de processus toujours ajoutée
Même lorsque le diagnostic est erroné, une mesure rigoureuse et un usage économe des outils rapportent quand même des points. Une trajectoire peut être renforcée pour son apparence méthodique tout en aboutissant à une mauvaise réponse.
Récompense conditionnée à la précision (X-Ragent)
La cohérence des mesures et le coût des outils ne sont notés que pour les trajectoires avec un diagnostic correct. Un diagnostic erroné ne rapporte aucun crédit de processus, aussi soignées que soient les étapes. La conclusion doit d'abord être juste.
5. Ce qui n'est pas nouveau, et où se situent les limites
Commençons par ce qui n'est pas nouveau. Des agents médicaux utilisant des outils existent dans des travaux antérieurs, et ChestAgentBench lui-même est issu de tels travaux.[3] GRPO est une méthode établie, et exécuter de l'apprentissage par renforcement après un ajustement fin supervisé est un schéma courant dans le post-entraînement des modèles de langage. Les nouveautés sont la séparation entre la recherche de preuves et l'admission des mesures, ainsi que la récompense qui limite le crédit de processus aux trajectoires correctes.
Il existe plusieurs limites. Premièrement, le critère permettant de savoir si une mesure s'applique. Le résumé ne précise pas ce que la barrière examine, ni si ses règles ont été écrites par des humains ou apprises. Selon la manière dont elle a été conçue, elle peut être en désaccord avec le jugement d'un radiologue.
Deuxièmement, la portée de l'évaluation. Les scores des benchmarks correspondent généralement à la précision sur des questions structurées. Le résumé ne dit rien de la qualité des rapports complets, des types de résultats manqués ni des effets sur les décisions cliniques, et il ne décrit pas les hôpitaux ni les conditions d'imagerie à l'origine des trois benchmarks.
Troisièmement, la construction de Rad-CoT. Les trajectoires sont décrites comme ordonnées causalement, mais le résumé ne précise pas qui les a vérifiées ni comment. Quels que soient les biais contenus dans le raisonnement d'entraînement, le modèle les apprendra avec lui.
Quatrièmement, la reproductibilité. Les données de sélection indiquent zéro étoile GitHub et aucun dépôt public. Cet article n'a pas confirmé si le code ou les données sont disponibles.
6. Pourquoi cela a attiré l'attention, et pourquoi le groupe reste encore restreint
Le pipeline de sélection a classé cet article sous Raisonnement et apprentissage. La taille de son groupe est de 1 : aucun autre article sur la même question n'est apparu dans cette fenêtre de collecte, et le seul signal déclenché a été le nombre de votes sur la page de l'article sur Hugging Face, avec 67 votes positifs, 1 commentaire et 0 étoile GitHub.[2] Les votes positifs montrent que les chercheurs ont remarqué l'article. Ils ne disent rien sur la validité de ses affirmations ni sur sa valeur clinique.
Les mots-clés de l'article indiquent toujours où il se situe : apprentissage par renforcement augmenté par des outils, GRPO, réglage fin supervisé agentique, raisonnement fondé sur des preuves. Ces termes reviennent dans de nombreuses recherches récentes sur les agents. Ce site a récemment traité d'articles sur des agents qui agissent avant que leurs preuves soient complètes et sur la présentation aux personnes des motifs des actions d'un agent.
X-Ragent transpose ce courant de travaux à un domaine précis, l'imagerie médicale. La question passe de « l'agent peut-il utiliser des outils ? » à « quand doit-il se fier à ce que les outils renvoient ? ». Un seul article ne fait pourtant pas un sujet. Reste à voir, dans les semaines à venir, si cette direction devient un groupe de travaux.
7. Où cela rejoint les pratiques pharmaceutiques et réglementaires
Un logiciel d'aide au diagnostic par l'image peut être réglementé comme dispositif médical. Son évaluation porte non seulement sur les chiffres de performance, mais aussi sur les conditions dans lesquelles il peut ou ne peut pas être utilisé. L'idée d'écarter du raisonnement les mesures inapplicables rejoint cette notion de conditions d'utilisation. Un système qui décide quand un outil de mesure ne s'applique pas, et consigne cette décision, produit des éléments pouvant étayer une explication.
La récompense conditionnée à l'exactitude ressemble aussi à un principe d'assurance qualité. Suivre la procédure ne remplace pas un résultat correct. La procédure est évaluée une fois qu'on a confirmé que le résultat est juste. Ce qui est courant dans la fabrication et les tests a été réécrit ici sous forme de conception de récompense.
Les résultats de référence d'un preprint ne peuvent pas être lus comme des performances cliniques. Les entreprises pharmaceutiques sont les plus susceptibles de rencontrer ce type de technologie dans l'aide à la lecture d'images lors d'essais cliniques, ou dans la vérification de la cohérence de ces lectures. Même dans ce cas, la trace des mesures acceptées et de celles rejetées doit être conservée, la décision finale doit rester aux médecins, et le dossier doit rester ouvert à un examen ultérieur. Ce qui se transpose dans la pratique, c'est moins un chiffre précis que l'idée de conception : traiter la recherche de preuves et l'acceptation de preuves comme deux décisions distinctes.