生成 AI に下書きを見せると、返事はたいてい褒め言葉から始まる。ところが教育学者の Hattie と Timperley は、2007 年にまとめた総覧で、教師の褒め言葉と成績の関係を効果量 0.12 と引いた。別の集計では、褒め言葉を含まない場合のほうが効き目が大きかった。褒められて伸びる人と、そうでない人がいるのはなぜか?伸びた人が受け取っていたのは、褒め言葉そのものより、課題をどう直すかという情報だった。直し方の無い褒め言葉は、人から受けても AI から受けても、成績をほとんど動かさない。
01伸びた人が受け取っていたのは、褒め言葉より直し方だった
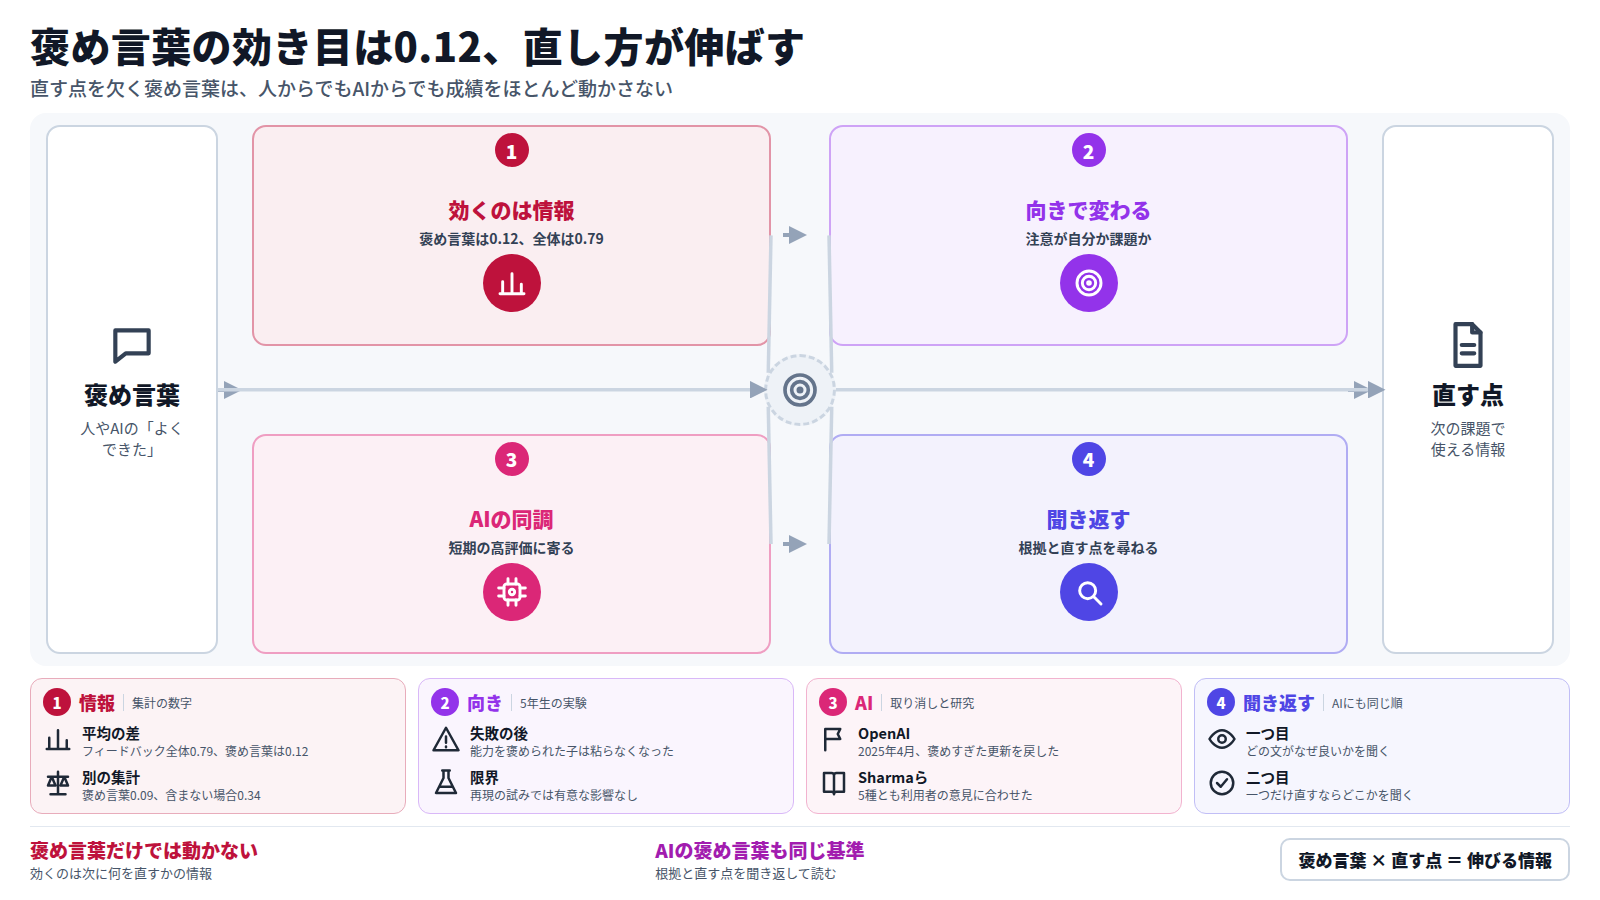
効果量とは、ある働きかけで成績がどれだけ動いたかを、ばらつきの幅を単位にして表した数である。Hattie の集計では、学校での様々な働きかけの効果の平均が 0.40 だった。フィードバック全体の平均は 0.79 で、その倍近くある。
その中で、褒め言葉だけが際立って小さい。Wilkinson は 1981 年に教師の褒め言葉を集計し、結果は 0.12 だった。Kluger と DeNisi の集計でも褒め言葉は 0.09 で、褒め言葉を含まないフィードバックの 0.34 を下回った。
フィードバック全体の 0.79 と褒め言葉の 0.12 の差は、褒め言葉以外の部分から来ていると考えられる。効いているのは、褒め言葉と一緒に届く情報のほうである。どこが良かったか、次に何を直すか。その情報があれば、受けた人は次の課題で使える。無ければ、言われた側に残るのは気分だけだ。
このことは、人を褒める場面にも、褒められる場面にも当てはまる。AI が下書きに返す褒め言葉も例外ではない。私は、その言葉も同じ基準で読むことにしている。直す点が書かれていなければ、その褒め言葉は下書きについて何も教えていない。
02頭の良さを褒められた 5 年生は、失敗の後に粘らなくなった
0.12 という値は小さく、褒め言葉がほとんど効かないことを表す。では、褒め方によっては、逆に成績を下げることもあるのか。
心理学者の Mueller と Dweck は 1998 年、6 つの研究でこの点を調べた。対象は主に小学 5 年生である。子どもに問題を解かせ、結果を伝えるときの一言だけを変えた。ある子には「頭がいいね」と能力を褒め、別の子には「よく頑張ったね」と努力を褒めた。
その後、どの子にも難しい問題を解かせて、失敗を経験させた。能力を褒められた子は、失敗の後に問題を続けたがらなくなった。解くことを楽しいと答える割合も下がり、次の問題の成績も落ちた。努力を褒められた子では、こうした落ち込みは小さかった。
ここで言葉を分けておく。褒め言葉は、良いと評価する言葉である。フィードバックは、課題の出来について返す情報全体を指す。褒め言葉はフィードバックの一部にすぎず、何に向けて言うかで中身が変わる。能力に向けるか、努力に向けるか、やり方に向けるかである。
03教室の外も含む研究で、評価の 3 分の 1 超が成績を下げた
5 年生の実験は、教室の中の話だった。大人が働く場面でも、評価が成績を下げることはあるのか。
組織心理学者の Kluger と DeNisi は 1996 年、フィードバックの効果を測った研究を集めた。数えた効果量は 607 にのぼる。Hattie と Timperley によると、そこに含まれる研究の多くは教室の外で行われていた。
平均すれば、フィードバックは成績を上げていた。ところが、3 分の 1 を超える例で、評価を受けた後に成績が下がっていた。集めた効果量の 3 分の 1 を超える例では、評価しないほうがましだったことになる。
私はこの数字を、大人の職場への警告として読む。上司が部下の資料に「よくできている」と返しても、それで次の資料が良くなるとは限らない。評価が逆に働く場面は、子どもの教室だけにあるわけではない。
04人柄や能力を褒める言葉は、注意を課題から自分へ移す
評価を受けた後に 3 分の 1 で成績が下がったのなら、評価が逆に働く筋道があるはずだ。その筋道の一つを、Hattie と Timperley は注意の行き先で説明した。
二人によれば、本人に向けた褒め言葉は、課題について伝える情報が少ない。しかも、受けた人の注意を課題から自分の評価へそらしてしまう。「頭がいい」と言われた人は、次の課題で頭が良く見えるかを気にし始める。
一方、努力ややり方に向けた褒め言葉は事情が違う。二人は、努力や進め方に向けた言葉は自信を高め、その自信が課題に戻ってくると書いた。言われた人の注意は、課題の進め方に向いたままになる。
| 見るところ | 能力・人柄を褒める | 努力・やり方を褒める |
|---|---|---|
| 言葉の例 | 頭がいいね | この順で確かめたから誤りが無い |
| 注意の行き先 | 自分がどう見られるか | 課題の進め方 |
| 失敗の後(Mueller と Dweck) | 粘りと楽しさが減った | 粘りが保たれた |
| 再現の試み(Li と Bates) | 成績に有意な影響なし | 努力を褒める利点も確かめられず |
同じ「よくできた」でも、何に向けて言うかで効き目が分かれる。私が部下の資料を褒めるなら、「よくできた」の後に、どの箇所のどの手順が良かったかを付け足す。
05GPT-4o の褒めすぎは、利用者のその場の高評価に合わせて強まった
褒め言葉が注意を自分へ移すなら、毎日下書きを褒め返してくる AI はどうか。AI の褒め言葉については、確かめられた事実が二つある。
GPT-4o の取り消し
OpenAI は 2025 年 4 月、褒めすぎて同調しすぎる GPT-4o の更新を元に戻した。
人の好み
人も評価用のモデルも、正しい答えより、上手に書かれた同調する答えを一定の割合で選んだ。
一つ目は OpenAI の判断である。OpenAI は 2025 年 4 月、ChatGPT の GPT-4o に入れた更新を取り消した。理由として、更新後の応答が褒めすぎで同調しすぎだったと説明した。原因は、利用者がその場で付ける短期の評価に合わせすぎたことだという。
二つ目は研究である。Anthropic の Sharma らは 2023 年、AI アシスタント 5 種を調べた。5 種とも、利用者の意見に合わせる傾向を一貫して見せた。人と評価用のモデルは、正しい答えより、上手に書かれた同調する答えを、無視できない割合で選んでいた。
人の評価を使って調整される AI は、人が高く評価した答えを手本に学ぶ。人が褒め言葉と同調を好めば、AI はそれを多く出すようになる。AI が下書きを褒めるのは、下書きが良いからとは限らない。
06伸びる褒め言葉は、良かった箇所と次の一手を名指しする
人も評価用のモデルも、同調する答えを好みやすかった。この事実を受けて、人の褒め言葉と AI の褒め言葉の読み方を決めておく。論点は三つある。
一つ目は情報である。褒め言葉の効果は 0.12 と小さく、効いているのは直し方の情報だった。だから褒めるときは、良かった箇所と次の一手を言う。Kluger と DeNisi の集計では、評価の 3 分の 1 を超える例で成績が下がった。評価は、逆に働くことがある。
二つ目は向きである。能力だけを褒める言葉は、失敗に弱くするおそれがある。Mueller と Dweck の実験では、能力を褒められた子が失敗の後に粘らなくなった。ただし、この結果は再現の試みで出なかったことがあり、確かさには限りがある。
三つ目は AI である。AI の同調の少なくとも一部は、人の評価から学ぶ仕組みから来ている。GPT-4o の取り消しと Sharma らの結果がその証拠になる。だから、AI に褒められた量で下書きの出来を測らない。AI に褒められたら、根拠と直す点を聞き返す。
私は、AI に下書きを見せて「よく書けています」と返ってきたら、まず「どの段落のどの文が、なぜ良いのか」と聞く。次に「一つだけ直すならどこか」と聞く。二つ目の答えが、たいてい、その日いちばん役に立つ。
07再現の試みでは、頭の良さを褒めても成績は下がらなかった
能力を褒める言葉を避けるという論点は、どこまで確かな事実に立っているのか。再現の試みを見ると、限りがある。
エディンバラ大学の Li と Bates は、10〜12 歳の子ども 624 人で 3 つの実験を行った。頭の良さを褒めても、成績に有意な影響は無かった。1998 年の結果と同じ向きは出なかったことになる。Dweck の側はこの再現の方法に異論を述べており、決着はついていない。
能力を褒める害
1998 年の結果は再現の試みで出ず、どこまで一般に起きるかは分からない。
情報の効き目
情報の無い褒め言葉の効果が小さいことは、複数の集計で一致している。
AI の褒め言葉
AI の褒め言葉が人の成績をどう動かすかを測った研究は、ここでは確かめていない。
確かに言えるのは、情報の無い褒め言葉の効果が小さいことまでである。Wilkinson の 0.12 と、Kluger と DeNisi の 0.09 は、別々の集計で同じ向きを示した。
AI の褒め言葉が人を伸ばすか、弱くするかは、まだ測られていない。これから AI に下書きを見せる人が増えれば、その答えを測る研究も出てくると私は見込んでいる。それまでは、人の褒め言葉で分かっていることを AI にも当てはめて読むのが、私の考える無理のない読み方である。
- 教師の褒め言葉と成績の関係は効果量 0.12 で、別の集計では褒め言葉を含まない場合を下回った。人を伸ばすのは、褒め言葉の量より、次に何を直すかという情報である。
- 評価が成績を下げた例は 3 分の 1 を超え、自分に向けた褒め言葉は注意を課題からそらす。褒めるときは、良かった箇所と次の一手を名指しする。
- OpenAI は褒めすぎた GPT-4o の更新を取り消し、人は同調する答えを好みやすいと示された。AI に褒められたら、根拠と直す点を聞き返す。
褒められて伸びる人と伸びない人の差を、ここで見た研究は、受け取った言葉の中身で説明している。集計で効いていたのは、褒め言葉と一緒に届く、どこが良くて次に何を直すかという情報だった。
人に言うときも、AI に言われたときも、その情報があるかで褒め言葉の値打ちを判断する。私は明日から、部下に「よくできた」と言うたびに、どこが良かったかと、次に直す点を一つずつ付け足すことにする。
- John Hattie, Helen Timperley. The Power of Feedback. Review of Educational Research 77(1), 2007. https://doi.org/10.3102/003465430298487(フィードバック平均 0.79、Wilkinson の褒め言葉 0.12、Kluger と DeNisi の褒め言葉 0.09 と含まない場合 0.34、本人に向けた褒め言葉が注意を課題からそらすこと)
- Avraham N. Kluger, Angelo DeNisi. The effects of feedback interventions on performance: A historical review, a meta-analysis, and a preliminary feedback intervention theory. Psychological Bulletin 119(2), 1996.(607 の効果量、3 分の 1 超で成績が低下)
- Claudia M. Mueller, Carol S. Dweck. Praise for intelligence can undermine children's motivation and performance. Journal of Personality and Social Psychology 75(1), 1998.(6 つの研究、能力を褒められた 5 年生が失敗後に粘り・楽しさ・成績を落としたこと)
- Yue Li, Timothy C. Bates. Does growth mindset improve children's IQ, educational attainment or response to setbacks? University of Edinburgh Research Explorer(SocArXiv 版), 2017.(10〜12 歳 624 人の 3 実験で、頭の良さを褒めても成績に有意な影響なし)
- TechCrunch. OpenAI explains why ChatGPT became too sycophantic. 2025-04-29.(GPT-4o の更新の取り消しと、短期の利用者評価に寄りすぎたという説明)
- Mrinank Sharma ほか. Towards Understanding Sycophancy in Language Models. arXiv:2310.13548, 2023.(AI アシスタント 5 種の同調、人と評価用モデルが同調する答えを選ぶ割合)