1. 画像を見るだけでは結論が決まらない読影がある
胸部 X 線の読影は、見えたものに名前を付ける作業だけでは終わらない。abstract の冒頭はこの点から始まる。読影では、画像の所見を、その課題に固有の証拠と組み合わせて判断することが多く、視覚的な認識だけに頼れないと著者らは書く。[1]
この「課題に固有の証拠」を外から持ち込む方法として、道具を呼び出せる医療エージェントが研究されてきた。画像の一部を切り出して調べる、臓器の輪郭を取って大きさを測る、といった処理を外部のモジュールに任せ、その結果を推論に組み込む形である。胸部 X 線については、道具を組み合わせて多段の推論を行うエージェントと、その評価用データ ChestAgentBench が先行研究で提案されている。[3]
ところが、道具を使えることと、道具を正しく使えることは別である。著者らは既存のエージェントの弱点を二つ挙げる。一つは、補助的な証拠が本当に必要な場面を学ぶ明示的な仕組みが無いこと。もう一つは、その画像には当てはまらない計測値が、診断の推論に入り込むのを防ぐ仕組みが無いことである。前者は道具の呼びすぎや呼び忘れにつながり、後者は「数字があるから」という理由で誤った結論を補強してしまう危うさにつながる。
2. 提案の芯 ── 「証拠を探す判断」と「計測を通す関門」を分ける
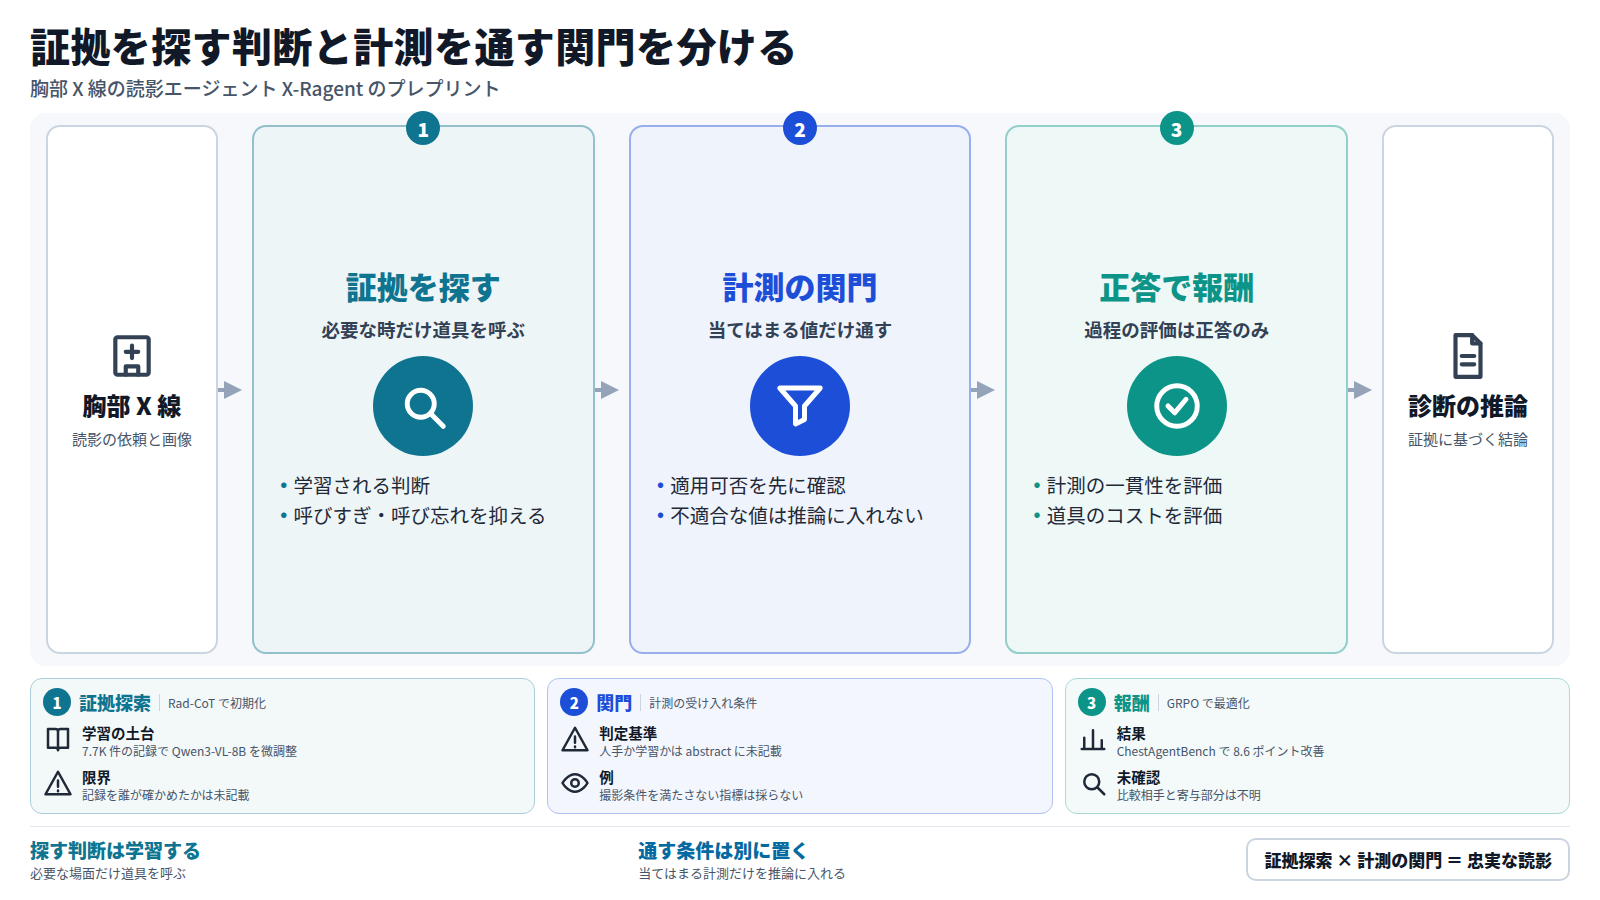
X-Ragent は、道具を使う強化学習のための後学習の枠組みである。手法の芯は、二つの動きを切り離して扱う点にある。一つは、補助的な証拠を探しに行くかどうかを、学習によって身につける動き。もう一つは、定量的な計測値を取り込む前に、その計測がこの画像に当てはまるかを確かめる関門(validity gate)を通す動きである。前者は学習される判断、後者は計測値の受け入れ条件として、別々に設計されている。
学習は二段で進む。最初に、著者らが作った Rad-CoT というデータで、エージェントとしての教師あり微調整(agentic SFT)を行う。Rad-CoT は、道具の呼び出しを因果の順に並べた調査の記録と、読影レポートの書き方に沿った診断の推論を組み合わせたもので、規模は 7.7K 件とされる。土台のモデルは Qwen3-VL-8B である。
次に、GRPO(Group Relative Policy Optimization)で方策を最適化する。GRPO は、同じ問いに対して複数の答えを生成させ、その集団の中での相対的な良し悪しを使って学習する手法で、先行研究で提案された。[4] この論文で工夫されているのは報酬の形である。計測の一貫性と、補助的な道具を使ったコストという「過程」についての評価項目を、診断が正しかった軌跡にだけ適用する。著者らはこれを「正答で関門を設けた報酬(accuracy-gated reward)」と呼ぶ。もっともらしい手順を踏んだことが、誤った診断の埋め合わせにならないようにするための設計である。
3. abstract の範囲で示されたこと
- データ:道具使用の記録とレポート形式の推論を組み合わせた Rad-CoT(7.7K 件)を構築したとされる。
- 学習:Qwen3-VL-8B を agentic SFT で初期化し、正答で関門を設けた報酬を使う GRPO で最適化したとされる。
- 結果:三つの胸部 X 線ベンチマークで、比較した手法の中で最も強い結果を得たとされる。学習に使われていない ChestAgentBench では 8.6 ポイントの改善を示したという。
- 著者らの解釈:証拠を選んで探し、妥当な計測だけを受け入れることで、より忠実で証拠に基づいた読影の推論を支えると主張している。
8.6 ポイントの改善がどの比較相手に対するものかは、abstract には書かれていない。ChestAgentBench 以外のベンチマーク名も、改善が報酬設計のどの部分から来たのかを切り分けた結果も、abstract の範囲では読み取れない。
4. 具体例で見る ── 計測値を「通さない」判断
当てはまらない計測値とは何かを、読影の一場面で考える。以下は手法の考え方を説明するための例であり、論文がこの状況を扱ったかどうかは abstract の範囲では分からない。胸部 X 線では、撮影の体位や方向によって心臓の写り方が変わり、心臓の大きさを測る指標がそのままでは使えないことがある。
依頼:この胸部 X 線で、心拡大があるか判断してほしい。
エージェント:(画像を見る)肺野と縦隔の所見を確認します。心陰影の評価には補助的な計測が役に立つので、計測の道具を呼びます。
エージェント:(関門で確かめる)撮影条件を確認すると、この画像は計測指標の前提となる撮影条件を満たしていません。この計測値は推論に入れません。
エージェント:計測値を使わずに、見えている所見から判断します。計測が使えなかったことも、根拠の欄に記録します。
この例で見たいのは、道具を呼んだことと、その結果を採用することが別の段になっている点である。報酬の側でも同じ切り分けがある。二つの学習の仕方を並べると、違いがはっきりする。
過程の評価を常に加える報酬
診断が外れても、計測を丁寧に行い、道具を節約していれば、その分の点が入る。手順がもっともらしいだけで報酬が積み上がり、誤診の軌跡でも学習が強化されうる。
正答で関門を設けた報酬(X-Ragent)
計測の一貫性や道具のコストを評価するのは、診断が正しかった軌跡だけ。誤診の軌跡は、手順がどれほど整っていても過程の点を受け取らない。まず結論が合っていることが前提になる。
5. 何が新しくないか、どこに限界があるか
新しくない部分から分けておく。道具を呼び出す医療エージェントは先行研究にあり、評価に使われた ChestAgentBench もそうした研究の中で作られた。[3] GRPO も既存の手法であり、教師あり微調整のあとに強化学習を重ねる二段の学習も、言語モデルの後学習ではよく見られる流れである。この論文の新しさは、証拠を探す判断と計測の受け入れ条件を分けた設計と、過程の評価を正答の軌跡に限る報酬の形にあると読むのが妥当だろう。
限界は複数ある。第一に、計測が「当てはまるかどうか」の判定基準である。関門が何を見て計測を退けるのか、その基準が人の手で決められたのか学習されたのかは、abstract の範囲では示されていない。基準の作り方しだいで、医師の判断と食い違う場面が出てくる。
第二に、評価の範囲である。ベンチマークの成績は、選択式や定型の問いに対する正答率で測られることが多い。実際の読影レポートの質、見落としの種類、臨床での判断への影響は、abstract に示されていない。三つのベンチマークがどの病院や撮影条件のデータに基づくかも書かれていない。
第三に、Rad-CoT の記録を誰がどう確かめたかは示されていない。コードやデータの公開状況も、本稿では確認できていない。
6. この主題が今なぜ注目されたか ── 束としてはまだ小さい
選定の仕組みは、この論文を「推論と学習」の分類で拾った。ただし束の大きさは 1 で、同じ問いを扱う別の論文は今回の収集範囲では見つかっていない。立った系統も、Hugging Face の論文ページでの票だけである。upvote は 67、コメントは 1、GitHub のスターは 0 だった。[2] upvote は研究者の目に留まったことを示す票であって、主張の正しさや臨床での価値を保証するものではない。
それでも、論文に付いた特徴語を並べると、置かれている文脈は見える。道具を使う強化学習、GRPO、エージェントとしての教師あり微調整、証拠に基づく推論。いずれも、ここ最近のエージェント研究で繰り返し出てくる語である。当サイトでも、エージェントが証拠をそろえる前に動いてしまう問題や、行動の根拠を人に見せる仕組みを扱った論文を続けて取り上げてきた。
X-Ragent はその流れを医用画像に持ち込んだ一例である。ただし、一本の論文で主題が立ち上がったとは言えず、同じ方向の研究が続くかは今後の束の育ち方を見る必要がある。
7. 製薬・規制の現場から見ると何が接続するか
画像診断を支援するソフトウェアは、医療機器として扱われる場合がある。その評価では、性能の数字だけでなく、どのような条件で使えるか、どのような条件では使えないかを明確にすることが求められる。X-Ragent の「当てはまらない計測値を推論に入れない」という設計は、この使用条件の考え方と重なる。計測の道具がいつ使えないかをシステム側で判定し、その判定を記録に残す形は、説明の材料になりうる。
正答で関門を設けた報酬も、品質保証の考え方に近い。手順書どおりに作業したことは、結果が正しかったことの代わりにはならない。
一方で、プレプリントの段階のベンチマーク結果を、臨床の性能と読み替えることはできない。製薬企業がこの種の技術に関わるのは、画像を使う臨床試験の読影支援や、評価の一貫性の確認といった場面だろう。その場合でも、どの計測を採用しどれを退けたかの記録を残し、最終判断は医師が行い、その記録を後から確かめられる形にしておくことが前提になる。この論文から実務に持ち込めるのは、具体的な数値よりも、「証拠を探すこと」と「証拠を受け入れること」を分けて設計するという考え方である。