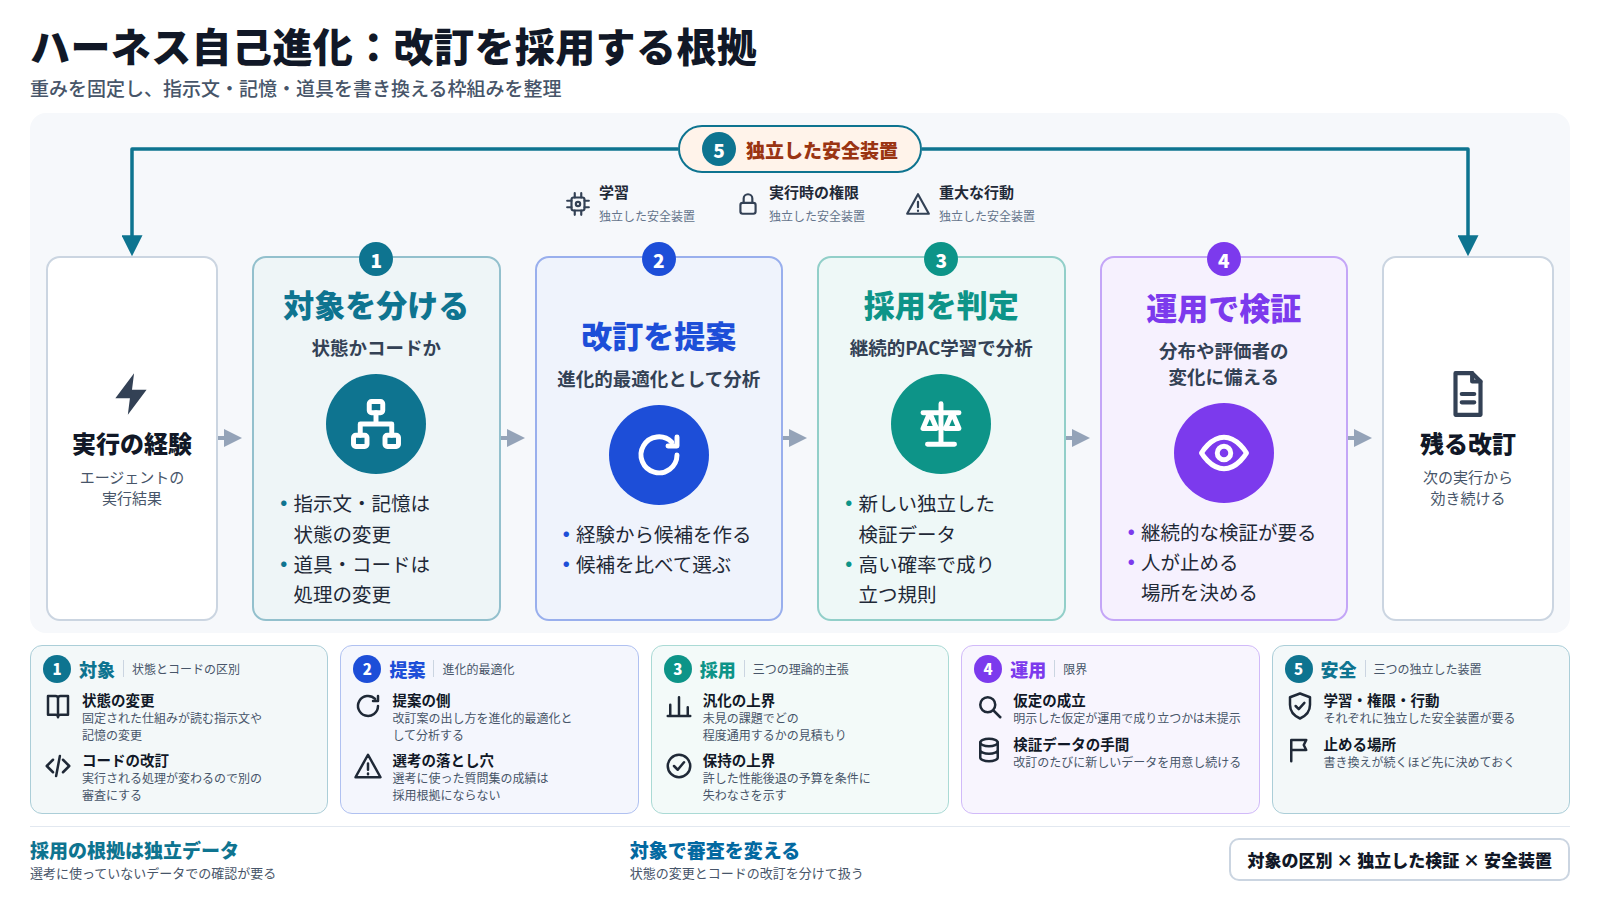
1. この論文は何を問題にしているか
LLM エージェントの振る舞いは、モデルの重みだけでは決まらない。指示文(プロンプト)、記憶、作業の手順、呼び出す道具やコードといった「外枠」が大きく効く。この外枠をハーネスと呼ぶ。最近は、エージェントが実行の経験をもとに、このハーネスを自分で書き換えていく研究が相次いでいる。
本サイトでも、ハーネスの自己改善を扱うプレプリントをここ数週間で何本か取り上げてきた。書き換えを繰り返すと評価用の課題に過剰に合わせてしまうという懸念を示した研究もある[4]。手法の数が増えるにつれて、何を書き換え、どう提案し、何をもって採用するのかが、論文ごとにばらばらに語られるようになった。
本稿で扱う論文(arXiv のプレプリント、査読前)は、この「ハーネス自己進化」を一つの枠組みで整理しようとする。abstract の定義では、モデルの重みは固定したまま、プロンプト・記憶・ワークフロー・実行可能な部品を改め、採用された改訂は実行をまたいで残る[1]。残るという点が肝である。一度採用した書き換えは、次の実行からずっと効き続ける。
2. 何を提案しているか
手法の芯は、「何を書き換えるか」と「書き換えをどう提案し、どう採用するか」を切り分けることにある。abstract によれば、枠組みは更新の対象と、提案・採用の仕組みを分けて扱う[1]。
更新の対象については、さらに区別を置く。一方は、固定された仕組みが読み込む状態(指示文や記憶など)の変更である。もう一方は、道具やコードそのものの改訂、リポジトリ単位の制御ロジック、プラグインの組み合わせの変更である。前者は書き換えても動き方の枠は変わらないが、後者は実行される処理そのものが変わる。リスクの性質が違うものを同じ「改善」と呼ばない、という整理である。
提案の側は進化的最適化として、採用の側は継続的な PAC 学習(どれだけのデータでどの程度の確からしさで汎化を保証できるかを扱う学習理論)として分析している。
3. 何を示したか ── abstract に書かれた範囲だけ
この論文の結果は実験の数字ではなく、明示した仮定のもとでの理論的な主張である。abstract が挙げるのは次の三つである[1]。
- 期待値で見た汎化の上界(書き換えが未見の課題でどの程度通用するかの見積もり)。
- 過去に許した性能後退の予算を条件とする、保持の上界(以前できていたことをどの程度失わずにいられるか)。
- 新しく、独立した検証データを使う、高い確率で成り立つ採用規則。
加えて、先行研究の事例から、モデルとハーネスの協調設計、分散実行、プラグインの再利用を例示している。abstract は、信頼できる運用には課題の分布や評価者が変わるなかでの継続的な検証と、学習・実行時の権限・重大な行動それぞれに独立した安全装置が要る、と結んでいる。
abstract によると、関連研究・理論・アルゴリズム・評価・応用・社会的影響をまとめた 66 ページの議論が GitHub で公開されている。ただし arXiv に載った版はそれより短い本文であり、長い議論の本体は GitHub 側にある。
4. 具体例で見る
社内の問い合わせ対応を支援するエージェントで、ハーネスの自動改訂を試している場面を考える。
運用担当と品質保証担当のやりとり
運用担当:「先週の失敗事例から、エージェントが自分で指示文に一文を足す改訂を提案しました。評価用の質問集で試したら成績が上がったので、採用したいです」
品質保証担当:「その評価用の質問集は、改訂案を選ぶときにも使いましたか」
運用担当:「はい。候補をいくつか比べて、一番良いものを選びました」
品質保証担当:「それなら、選ぶのに使った質問集での成績は採用の根拠になりません。選考に一度も使っていない質問で確かめてください。それと、今回は指示文の変更ですが、次に道具のコードを書き換える案が出たら、別の手順で審査します」
品質保証担当の二つの指摘は、論文の整理にそのまま対応する。採用の判断には新しく独立した検証データを使うこと。指示文のような状態の変更と、コードの改訂とを分けて扱うこと。
5. 何が新しくないか/限界はどこか
まず、この論文は新しい手法を実験で示したものではない。公開されている GitHub と案内ページは、この仕事を「サーベイ」と明記し、作業中の草稿と位置づけている[2][3]。リポジトリにあるのは草稿、文献一覧、分類表、根拠の評価基準などで、動かせるエージェントの実装は含まれていない[2]。
理論の部分にも条件がつく。汎化と保持の上界は「明示した仮定のもとで」導かれたものであり、その仮定が実際の運用でどの程度成り立つかは、abstract の範囲では示されていない。採用規則が求める「新しく独立した検証データ」は、改訂のたびに用意し続ける必要があり、その手間をどう賄うかも課題として残る。
著者ら自身も、根拠の弱さを率直に書いている。案内ページの評価では、採用された改訂が採点時に実際に動いていたか(作動)と、その改訂が成績の差を生んだのか(帰属)が、既存研究の根拠として最も手薄だとしている。順位付けや採用に使った保留データは、探索から完全には独立していないとも注記している[3]。
付け加えると、本サイトの選定設計は、サーベイやポジションペーパーだけの論文を「hot topic」から除く方針をとっている。この論文が選ばれたのは、整理の枠組みとして読む価値があるという判断であり、一次の発見を報告した論文として扱うべきではない。
6. この主題が今なぜ束になっているか
今回の収集では、この論文と同じ束に入った論文は無く、束の大きさは 1 だった。単独の論文としての話題性は、Hugging Face での票が 185、GitHub のスターが 43 である。これらは読者と実装者の関心を示す数字であって、内容の正しさを示すものではない。とくにこのリポジトリには実行できるコードが無いため、スターは実装の追随ではなく、文献一覧や資料への関心を表していると読むのが妥当である。
束は今回できていないが、主題そのものは続いている。本サイトはここ数週間、ハーネスの部品ごとの自己改善、書き換えの正則化、ハーネスの組み合わせなどを扱うプレプリントを続けて取り上げてきた。キーワードに並ぶ「継続的な検証」「プラグインの組み合わせ」「モデルとハーネスの協調設計」は、そうした個別の手法が共通して抱える論点である。手法が増えたあとに、整理の枠組みが出てくる。この論文はその段階に当たる。
7. 製薬・規制の現場から見ると何が接続するか
採用された改訂が実行をまたいで残る、という性質は、規制のかかる業務では変更管理の問題そのものである。エージェントが自分の指示文や道具を書き換えるなら、いつ、何が、どの根拠で採用されたかを記録し、元に戻せる形で版を管理する必要がある。
論文が採用規則に「独立した検証データ」を求める点は、コンピュータ化システムのバリデーションの考え方と重なる。変更を承認する根拠には、その変更を選ぶ過程で使っていないデータでの確認が要る。さらに、指示文の変更とコードの改訂を分ける整理は、変更の影響度に応じて審査の深さを変える実務の発想と同じ向きである。
abstract が結びで挙げる、学習・実行時の権限・重大な行動それぞれへの独立した安全装置は、安全性情報の処理や規制当局向け文書の作成にエージェントを使う場面で、最初に設計すべき部分である。書き換えが続く仕組みほど、人が止められる場所を先に決めておく必要がある。