1. この論文は何を問題にしているか
いまの大規模言語モデルは、文章をそのままではなく「トークン」という単位に区切って読む。多くのモデルが使うのは、単語や単語の切れ端を 1 単位とするサブワード分割である。効率はよいが、切れ端の内側にある 1 文字ずつの情報が見えにくくなる。
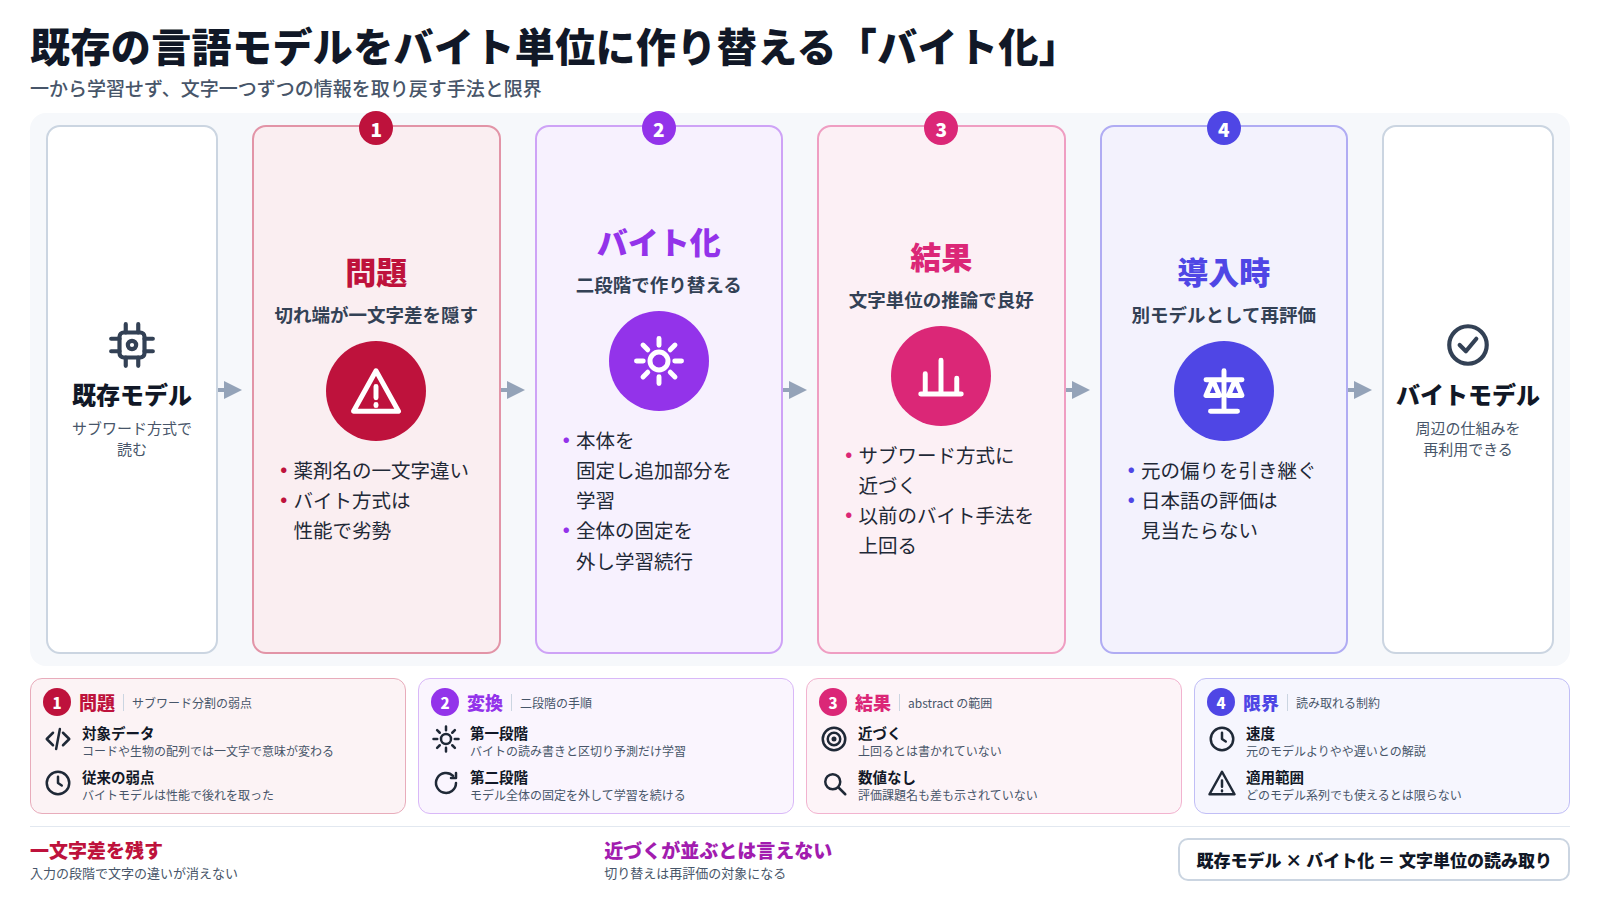
Nature に査読を経て掲載されたこの論文は、この点を問題にしている。abstract は、コンピュータのコードや生物の配列のように、1 文字・1 バイトの違いで意味が変わるデータでは、サブワード分割が細かな情報を覆い隠してしまうと書く[1]。
文字や配列を扱う実務では、この弱点は身近である。薬剤名の一文字違い、アミノ酸配列の一残基の置換、ロット番号の桁の取り違え。いずれも「切れ端」単位で読むモデルにとっては見落としやすい種類の差である。
バイト列をそのまま読むモデルなら、この問題は起きにくい。ところが abstract によれば、そうしたバイトレベルのモデルは、これまで性能でサブワード方式のモデルに後れを取ってきた。
2. 何を提案しているか
手法の芯は、バイトレベルのモデルを一から学習するのではなく、既存のサブワード方式のモデルを作り替えてバイトレベルにすることにある。著者らはこれを「バイト化(byteification)」と呼ぶ。abstract によれば、二段階の変換手順で、追加の学習を最小限に抑えて既存モデルをバイトレベルのモデルに作り替える[1]。
同じ研究グループの Ai2 が公開した解説では、二段階の中身がもう少し具体的に書かれている。第一段階では元のモデルの本体を固定し、新しく足したバイトを読み書きする部分と、バイト列をどこで区切るかを予測する部分だけを学習する。第二段階でモデル全体の固定を外して学習を続ける[2]。
この設計の利点として abstract が挙げるのは、元のモデルを取り巻く既存の仕組み(周辺のツールや追加学習の資産)を再利用できる点である。ゼロから作らないので、元のモデルが持っていた知識と、その上に積み上げられた資産を引き継げる、という主張である。
3. 何を示したか ── abstract に書かれた範囲だけ
abstract が述べている結果は次のとおりである[1]。
- バイト化したモデルは、サブワード方式のシステムの能力に近づく(abstract の語は approach であり、上回るとは書いていない)。
- 以前のバイトレベルの手法を上回る。
- 文字単位の推論を要する課題で特に良い成績を示す。
- バイト単位の情報を効率よく処理することで、実用的な推論速度を得る。
- 元のモデルの周辺の仕組みを再利用できるため、適応しやすい。
著者らはこれらをもって、バイトレベルの言語モデルが抱えてきた性能の壁を取り除いたと主張し、生の文字コードを読むモデルも競争力を保ったまま規模を大きくできると結論づけている。ここで注意したいのは、abstract に具体的な評価課題名や数値が書かれていないことである。どの規模のモデルで、どの課題で、どれだけの差だったかは、abstract の範囲では分からない。
4. 具体例で見る
添付文書や社内資料の点検で、名称の似た薬剤や配列データを扱う場面を考える。
サブワード方式のモデル
薬剤名や配列は、意味のまとまりとは関係なく切れ端に区切られる。一文字だけ違う二つの名称が、似た切れ端の並びとして扱われることがある。「この配列の中に特定の並びは何回出てくるか」「この二つの名称はどの文字が違うか」といった問いでは、切れ端の内側が見えないことが誤りの原因になりうる。
バイト化したモデル
文字コードを 1 バイトずつ読むため、一文字の違いが入力の段階で消えない。abstract が「文字単位の推論で良い成績」と書くのは、この種の問いである。一方で、同じ文章でも読む単位が細かくなる分、入力の列は長くなる。速度を保つ工夫が必要になるのはそのためである。
ただし、この論文が薬剤名や医薬品の文書で評価したとは abstract に書かれていない。上の対比は、abstract が挙げる「コードや生物の配列」と同じ性質の問題が実務にもある、という接続を示すにとどまる。
5. 何が新しくないか/限界はどこか
バイト列を直接読む言語モデルという発想そのものは新しくない。abstract 自身が「以前のバイトレベルの手法」と比べており、Ai2 の解説も先行するバイトレベルのモデルを比較相手に挙げている[2]。新しいのは、既存のサブワード方式のモデルを出発点にして、少ない追加学習で作り替えるという道筋のほうである。
限界として読み取れる点を挙げる。
- 「近づく」であって「並ぶ」ではない。abstract の表現は、一般的な課題での性能がサブワード方式に追いついたとまでは言っていない。Ai2 の解説も、幅広い評価で元のモデルに「近い」という書き方をしている[2]。
- 速度の比較対象が abstract では分からない。「実用的な推論速度」と書かれているが、何と比べて実用的なのかは abstract の範囲では示されていない。Ai2 の解説では、元のサブワード方式のモデルよりやや遅いことが述べられている[2]。
- 元のモデルを引き継ぐ。作り替えである以上、元のモデルが持つ偏りや弱点もそのまま引き継ぐと考えるのが自然である。どこまで引き継がれるかは abstract の範囲では示されていない。
- 日本語での評価は見当たらない。日本語の文字は UTF-8 では 1 文字が複数バイトになるため、英語より入力の列が長くなりやすい。日本語でどの程度の性能と速度になるかは、abstract の範囲では示されていない。
- どのモデル系列にも使えるとは限らない。Ai2 の解説は、追加学習済みの重みを移す工夫について、互換性がどのモデル系列でも保証されるわけではないと注記している[2]。
6. 紹介記事は何をどう伝えたか
本サイトの選定処理は、この論文の紹介媒体として Nature と Allen AI(Ai2)を挙げた。見出しは Nature が論文題目そのもの、Ai2 が「Now in Nature: Retrofitting language models to operate over bytes」である。
この二つを「独立した媒体による紹介」と数えるのは慎重であるべきだ。前者は掲載誌そのものの論文ページであり、後者は著者が所属する研究機関の告知である。第三者の報道が論文の主張をどう受け止めたかは、この二件からは分からない。論文と報道の見出しのずれを見ようにも、比べる相手がまだ無い状態である。
もう一つ押さえておきたいのは時系列である。同じ手法は、2025 年 12 月にプレプリント(arXiv)と Ai2 の解説記事として先に公開され、モデルとコードも公開されていた[2][3][4]。コードのリポジトリは、この仕事が Nature に掲載されたことを告知している[4]。今回の掲載は「新しい手法の登場」ではなく、先に公開された手法が査読を経たという出来事として読むのが正確である。ただしプレプリント版と Nature 版の記述の異同は、本記事では細かく照合していない。
査読誌に載ったこと、本サイトの選定で上位に来たことは、手法の正しさや実用上の価値を保証するものではない。
7. 製薬・規制の現場から見ると何が接続するか
abstract が名指しする「生物の配列」は、創薬研究に直結する。アミノ酸配列や塩基配列を言語モデルで扱うとき、1 文字単位の情報が保たれることには意味がある。化合物の文字表記や、構造式を文字列で表した記法も同じ性質を持つ。ただし、これらの領域での評価は abstract に示されておらず、効果は個別に確かめる必要がある。
文書の実務では、名称の似た薬剤の取り違え防止や、表記ゆれの検出が関わる。一文字の差を見落とさないことは、資材の点検や安全性情報の照合でも求められる性質である。
規制の観点では、トークンの扱いを変えたモデルは、元のモデルとは別のモデルとして扱うべきである。社内で LLM を組み込んだシステムの妥当性を確認している場合、バイト化したモデルへの切り替えは、名前が似ていても再評価の対象になる。作り替えの手軽さと、検証の手間は別の問題である。