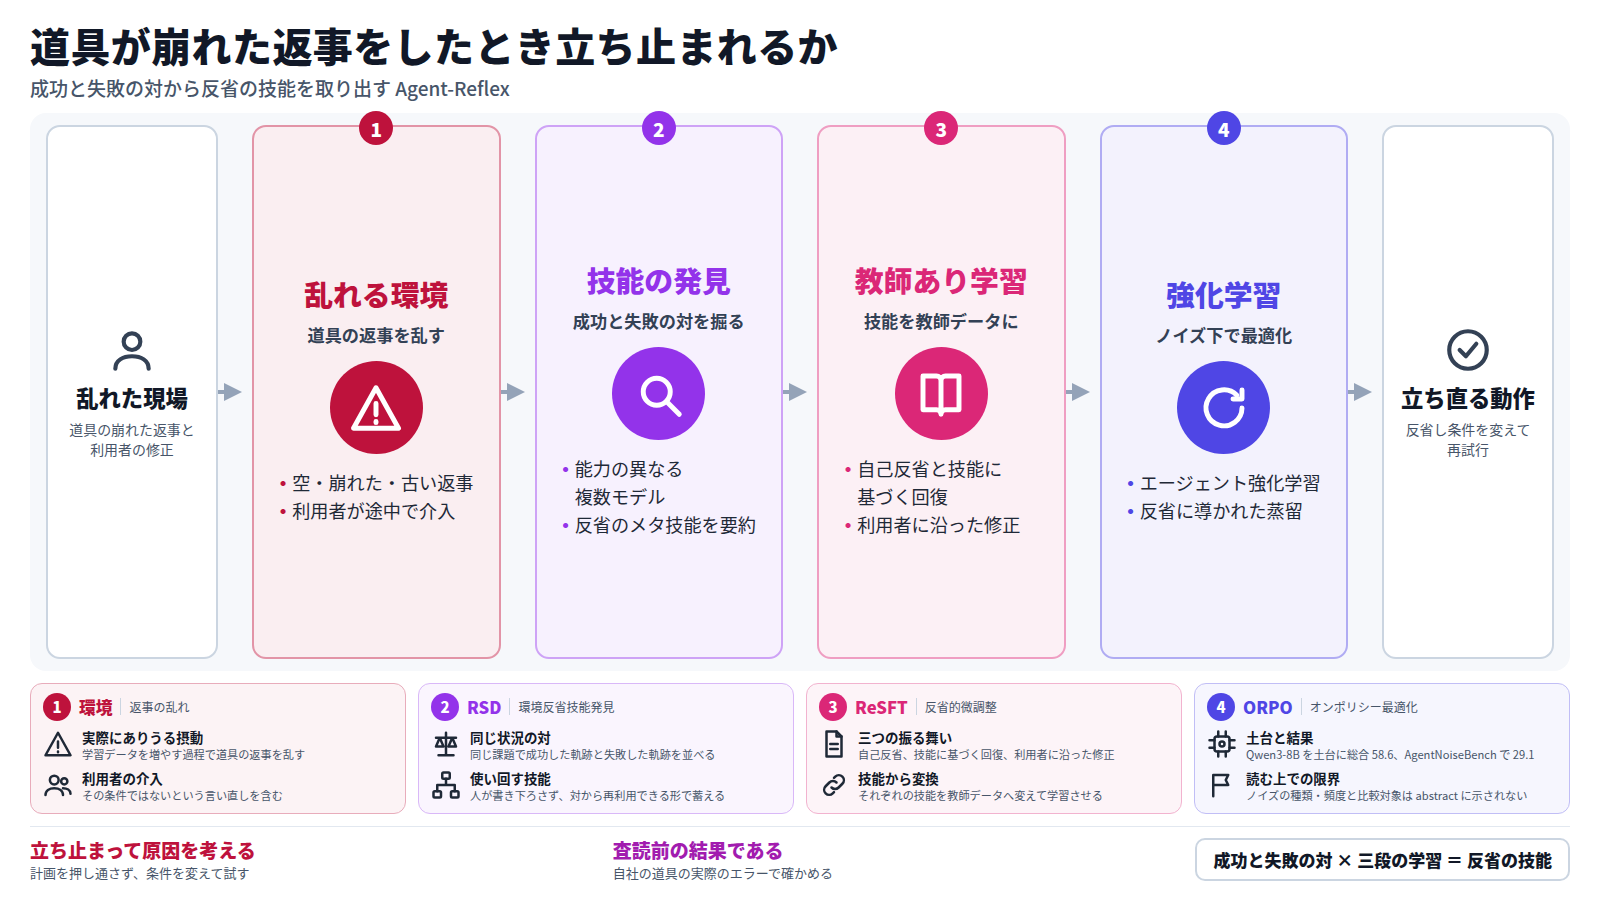
1. 道具は間違った返事をし、利用者は途中で口をはさむ
大規模言語モデルは、一問一答のチャットから、長い手順を自分で進めるエージェントへと使われ方が広がってきた。abstract が問題にするのは、そのエージェントが実際の運用で出会う二つの状況である。一つは、MCP(モデルが外部の道具を呼び出すための共通の接続方式)でつないだ道具が、ノイズの混じった返事を返すこと。もう一つは、利用者が途中で介入し、エージェントの進め方を正すことである。[1]
どちらも、実務では珍しくない。検索の道具が空の結果を返す、形式の崩れたデータを返す、古い情報を返す。利用者が「その条件ではない」と言い直す。こうした場面でエージェントに求められるのは、最初の計画をそのまま押し通すことではなく、立ち止まって何がおかしいかを考え、やり方を変えることである。著者らはこれを「反省(reflection)」と「失敗からの回復」と呼び、既存の手法ではこの二つを学ばせるための教師信号が限られていると指摘する。
2. 提案の芯 ── 反省のしかたを、成功と失敗の対から取り出す
Agent-Reflex は、エージェントに自分から反省する振る舞いを身につけさせるための学習の枠組みで、三段で構成される。手法の芯は第一段にある。反省のしかたを、人が書き下ろすのではなく、成功例と失敗例を並べて取り出し、再利用できる「反省の技能」として蓄えるという点である。
第一段の環境反省技能発見(RSD)では、環境を広げて学習データを増やす過程に、実際にありうる形で道具の返事を乱す摂動を入れる。そのうえで能力の異なる複数の言語モデルに同じ課題を解かせ、同じ状況で成功した軌跡と失敗した軌跡の対を掘り出し、そこから使い回せる反省の「メタ技能」を要約する。
第二段の反省的教師あり微調整(ReSFT)では、それぞれの技能を教師データに変換する。対象は、自己反省、技能に基づく回復、利用者に沿った修正の三つの振る舞いである。第三段の ORPO(On-Policy Reflective Policy Optimization)では、ノイズのある環境でのエージェント強化学習と、反省に導かれたオンポリシー蒸留を組み合わせる。オンポリシー蒸留は、生徒モデルが自分で生成した系列に対して教師が評価を与える学習法で、先行研究で提案されている。[5]
3. abstract の範囲で示されたこと
- 土台:Qwen3-8B を土台に学習したとされる。
- 結果:長い手順の道具使用を測る五つのベンチマークで総合 58.6、ノイズへの対応を測る AgentNoiseBench で 29.1 に達し、環境を広げる手法や反省を扱う手法の強い比較対象を上回ったとされる。
- 範囲:六つのエージェント評価群で有効性を示したと書かれている。
- 分析:ノイズへの耐性を高めながら、学習の挙動は安定していたと著者らは主張している。コードは公開されている。[3]
総合 58.6 という値が、五つのベンチマークの平均なのか別の集計なのかは abstract には書かれていない。比較対象の具体名や差の大きさも示されていない。AgentNoiseBench の値が低めに見えるのは、それだけ難しい評価だということでもあり、ノイズのもとでの道具使用がまだ解けた問題ではないことを示している。
4. 具体例で見る ── 文献検索の道具が崩れた返事をしたとき
製薬の現場に近い一例で、反省と回復がどう違って見えるかを示す。以下は手法の考え方を説明するための例であり、論文がこの種の課題を扱ったかどうかは abstract の範囲では分からない。
利用者:この成分の肝機能障害に関する症例報告を集めて、一覧にしてほしい。
エージェント:(文献検索の道具を呼ぶ)返事が空でした。検索条件の書式が道具の仕様と合っていない可能性があります。条件を分けて再検索します。
エージェント:(再検索)結果が返りました。ただし一部の項目で、出版年の欄に誌名が入っています。返事の形式が崩れているので、この項目は書誌を確認し直します。
利用者:一般名ではなく、販売名でも探して。
エージェント:了解しました。販売名を条件に加えて検索をやり直し、前の結果と重複を除いてまとめます。
ここには、abstract が挙げた三つの振る舞いが順に出ている。道具の返事を疑う自己反省、条件を分けて検索し直す回復、利用者の言い直しに沿った修正である。反省を学んでいないエージェントとの違いを並べると次のようになる。
反省を学んでいないエージェント
空の返事を「該当なし」と受け取って終える。崩れた項目もそのまま一覧に載せる。利用者の言い直しは、それまでの結果と関係のない新しい依頼として扱う。
反省を学んだエージェント(著者らの狙い)
返事が想定と違えば原因を考え、条件を変えて試す。形式の崩れた項目は確認し直す。利用者の修正は、それまでの作業を活かしたまま計画に組み込む。
5. 何が新しくないか、どこに限界があるか
言語エージェントが言葉で反省し、その内容を次の試行に活かすという考え方は、Reflexion などの先行研究にある。[4] オンポリシー蒸留も既存の手法である。この論文の新しさは、成功と失敗の対から反省の技能を掘り出す段取りと、それを教師あり学習と強化学習の両方に流し込む三段の設計にあると読むのが妥当だろう。
限界は複数ある。第一に、ノイズの作り方である。道具の返事を乱す摂動は「実際にありうる形で」入れたとされるが、どの種類の乱れをどの程度の頻度で入れたかは abstract の範囲では示されていない。実運用で起きる乱れの分布と合っているかは分からない。
第二に、利用者の介入の扱いである。利用者に沿った修正を学ばせたとされるが、その介入がどのように作られたのか(人が書いたのか、モデルが模擬したのか)は書かれていない。
第三に、反省が常に良い方向に働くとは限らないことである。正しい道具の返事を疑いすぎれば、無駄な再試行が増える。abstract はノイズへの耐性の向上を述べるが、ノイズが無い場面での余計な反省のコストには触れていない。
6. この主題が今なぜ注目されたか
選定の仕組みは、この論文を「エージェントと自律性」の分類で拾った。束の大きさは 1 だが、立った系統は二つある。Hugging Face の論文ページでの upvote が 49、コメントが 2、そして公開コードの GitHub スターが 75 である。[2] 読者の票と実装者の票が両方立っている点は、単なる話題で終わっていないことを示す材料にはなる。ただし、どちらも主張の正しさを保証するものではない。
論文に付いた特徴語は、長い手順の推論、道具使用、強化学習、オンポリシー蒸留である。エージェントを実際の環境で長く動かすと、道具や利用者とのやりとりの中で計画が崩れる。その崩れからどう立ち直るかを、評価だけでなく学習の対象にしようとする流れの中に、この論文は位置づけられる。
7. 製薬・規制の現場から見ると何が接続するか
社内でエージェントを使う場合、つなぐ道具は文献データベース、安全性情報のデータベース、文書管理システムなどになる。これらは必ずしも安定した返事を返さない。空の結果、途中で切れた結果、形式の違う結果を、エージェントがそのまま報告に混ぜると、誤りが人の目に触れにくい形で残る。
この論文が扱う反省と回復は、品質管理でいう逸脱への対応に近い。想定と違う結果に気づき、原因を考え、手順を変えてやり直す。ただし規制のある業務では、立ち直ったことだけでなく、何が起きて何を変えたかが記録に残ることが求められる。エージェントの反省の内容と再試行の経過を、後から人が読める形で残す仕組みが前提になる。
プレプリントの段階のベンチマーク結果は、社内の道具環境での性能を保証しない。導入を考えるなら、自社の道具が返す実際のエラーや形式の乱れを集め、その上でエージェントがどう振る舞うかを確かめることが先になる。