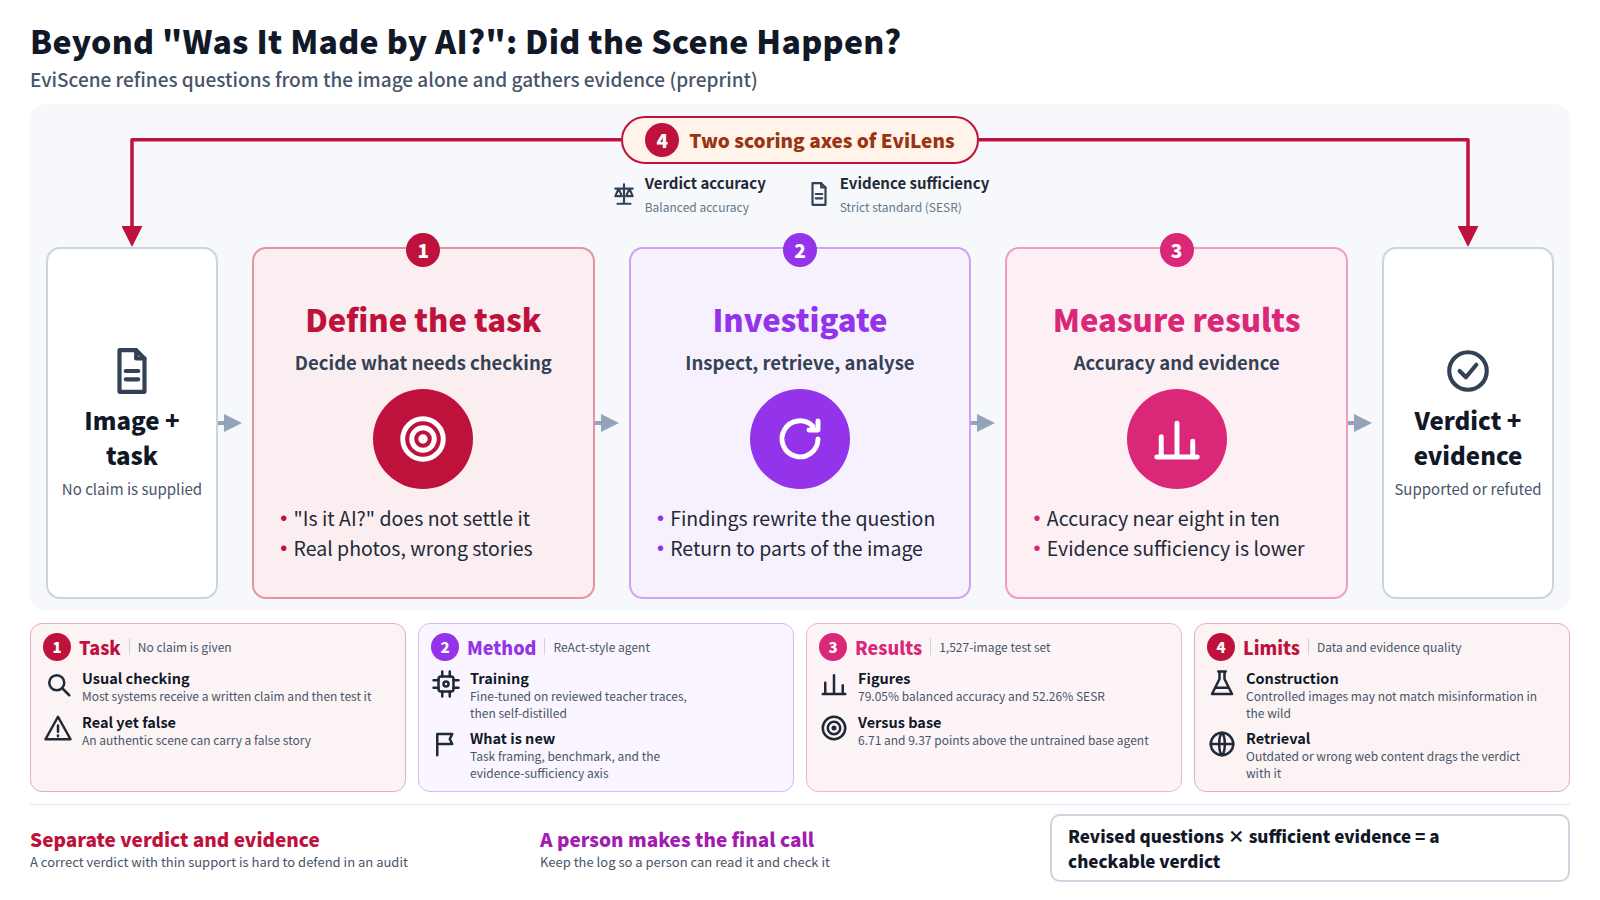
1. "क्या यह AI है?" और "क्या यह सच है?" अलग-अलग प्रश्न हैं
इमेज सत्यापन पर हाल के अधिकांश कार्य ने एक ही प्रश्न पर ध्यान केंद्रित किया है: क्या यह तस्वीर किसी जनरेटिव मॉडल द्वारा बनाई गई थी? एब्स्ट्रैक्ट की शुरुआत यह बताते हुए होती है कि इससे उस प्रश्न का उत्तर नहीं मिलता जो व्यवहार में मायने रखता है। यह जान लेना कि कोई इमेज AI द्वारा बनाई गई है या नहीं, यह सिद्ध नहीं करता कि उसमें दर्शाई गई स्थिति तथ्यों द्वारा समर्थित है या नहीं।[1]
मुश्किल मामले आम तौर पर साधारण ही होते हैं। एक असली तस्वीर को इस तरह दोबारा पोस्ट किया जाता है मानो वह किसी दूसरे दिन या किसी दूसरी जगह की हो। दृश्य असली है, लेकिन उससे जुड़ी कहानी झूठी है। उलटा भी होता है: संपादित की गई तस्वीर भी कुछ सटीक बात बता सकती है। इनमें से कई मामलों में, "असली" या "जनरेट की गई" बताने वाला डिटेक्टर किसी काम का नहीं होता।
एक दूसरी कठिनाई भी है। अधिकांश तथ्य-जाँच प्रणालियाँ एक लिखित दावा प्राप्त करती हैं, जैसे "यह फ़ोटो X को दर्शाती है," और फिर उसे परखती हैं। यह शोधपत्र उस दावे को हटा देता है। प्रणाली को केवल छवि और उसे सत्यापित करने का एक सामान्य निर्देश मिलता है। उसे स्वयं तय करना होता है कि जाँचने लायक क्या है।
2. मूल विचार: जाँच करते हुए प्रश्न को संशोधित करें
लेखक कार्य को इस प्रकार परिभाषित करते हैं। एक छवि और एक सामान्य सत्यापन निर्देश दिए जाने पर, प्रणाली एक निर्णय लौटाती है, जो या तो समर्थित या खंडित होता है, साथ में साक्ष्य पर आधारित स्पष्टीकरण भी देती है। क्योंकि कोई दावा नहीं दिया जाता, प्रणाली को जाँच आगे बढ़ने के साथ अपने तथ्यात्मक प्रश्नों को सीमित करना होगा और मिलने वाले बाहरी साक्ष्य को चित्र में दिखाई गई विशिष्ट स्थिति से मिलाना होगा।
EviScene इसी कार्य के लिए बनाया गया है। सार के अनुसार, यह ReAct शैली का एक मल्टीमॉडल एजेंट है जो तीन क्रियाओं के बीच बारी-बारी से काम करता है: छवि का निरीक्षण, बाहरी जानकारी की खोज, और साक्ष्य का विश्लेषण। ReAct एक पहले का ढाँचा है जिसमें भाषा मॉडल तर्क-चरणों को खोज जैसी क्रियाओं के साथ क्रमबद्ध रूप से मिलाता है।[4]
यह समीक्षा पद्धति को एक बिंदु तक सीमित करती है: एजेंट नए निष्कर्षों का उपयोग अपने प्रश्नों को दोबारा लिखने और छवि के प्रासंगिक हिस्सों पर वापस जाने के लिए करता है। वह उसी प्रश्न के साथ खोज जारी नहीं रखता जिससे उसने शुरुआत की थी। लेखकों का तर्क है कि जब खोज को टिकाने के लिए कोई दावा न हो, तब यही आगे-पीछे की प्रक्रिया निर्णय की गुणवत्ता तय करती है।
प्रशिक्षण की विधि का भी वर्णन किया गया है। एक संक्षिप्त पॉलिसी को पहले एक शिक्षक मॉडल के जाँच-ट्रेस पर फ़ाइन-ट्यून किया जाता है, जिनकी मनुष्यों ने समीक्षा की थी। फिर उसे अपनी ही जाँचों के उन निर्णयों पर, जिन्हें सत्यापित किया जा सका, विशेषाधिकार-प्राप्त ऑन-पॉलिसी स्व-आसवन (privileged on-policy self-distillation) से प्रशिक्षित किया जाता है। "विशेषाधिकार-प्राप्त" जानकारी में क्या शामिल है, यह सार (abstract) में नहीं बताया गया है।
3. एब्स्ट्रैक्ट क्या बताता है
- बेंचमार्क (EviLens): 10,174 समर्थित और खंडित छवियाँ, जिनकी विशेषज्ञों ने समीक्षा की है, नियंत्रित निर्माण और वेब संग्रह दोनों से ली गई हैं। यह तथ्यात्मक त्रुटि के बारह प्रकारों को कवर करता है और निर्णय की सटीकता तथा उद्धृत प्रमाण के पर्याप्त होने, दोनों का आकलन करता है।
- मॉडल: Qwen3.5-9B बैकबोन पर प्रशिक्षित एक एजेंट।
- परिणाम: 1,527 छवियों के परीक्षण सेट पर, प्रशिक्षित एजेंट 79.05% संतुलित सटीकता और 52.26% की Strict Evidence Sufficiency Rate (SESR) हासिल करता है।
- तुलना: ये उसी बैकबोन पर बिना प्रशिक्षित बेस एजेंट से क्रमशः 6.71 और 9.37 प्रतिशत अंक अधिक हैं। इसकी SESR का वर्णन मूल्यांकित एजेंटों में सबसे अधिक के रूप में किया गया है।
एक अंतर साफ़ दिखता है। साक्ष्य की पर्याप्तता निर्णय की सटीकता से काफ़ी कम है, यानी सही निर्णय के साथ अक्सर ऐसे साक्ष्य होते हैं जो कड़ी समीक्षा में खरे नहीं उतरेंगे। सार (एब्स्ट्रैक्ट) में यह नहीं बताया गया कि तुलना किन अन्य एजेंटों से की गई या अंतर कितने बड़े थे।
4. एक उदाहरण: कंपनी के भीतर प्रसारित होने वाली एक तस्वीर
दवा क्षेत्र के काम से जुड़े एक मामले पर विचार करें। एक आंतरिक चैट में फार्मेसी की शेल्फ पर रखे एक अपरिचित पैकेज की तस्वीर पोस्ट की जाती है और लोग पूछने लगते हैं कि क्या यह नकली है। नीचे का आदान-प्रदान केवल उदाहरण के लिए EviScene के तरीके को लागू करता है; सार यह नहीं बताता कि शोधपत्र में इस प्रकार की तस्वीरें शामिल थीं या नहीं।
कर्मचारी: कृपया जाँचें कि क्या यह फ़ोटो तथ्यात्मक है।
एजेंट: (छवि की जाँच करते हुए) मुझे पैकेज का लेबल, शेल्फ़ पर लगा मूल्य टैग और स्टोर में एक सूचना दिखाई दे रही है। मेरा पहला सवाल है कि क्या यह पैकेज मौजूदा असली डिज़ाइन से मेल खाता है।
एजेंट: (खोज करते हुए) निर्माता की साइट पर पैकेजिंग बदलाव की एक सूचना है, और नया डिज़ाइन फ़ोटो से मेल खाता है।
एजेंट: (प्रश्न को संशोधित करते हुए) अगला: इस फ़ोटो को कब और कहाँ खींचा गया बताकर प्रस्तुत किया जा रहा है? स्टोर की सूचना के पाठ को एक बार फिर देखा जाए।
एजेंट: निर्णय: समर्थित। आधिकारिक सूचना पैकेज से मेल खाती है, इसलिए नकली होने की कहानी समर्थित नहीं है। यह पुष्टि नहीं हो सकी कि फ़ोटो कहाँ खींची गई थी।
इस उदाहरण का मुद्दा यह है कि पहला प्रश्न (क्या यह नकली है?) और संशोधित प्रश्न (यह कब और कहाँ लिया गया था?) अलग-अलग हैं। निर्णय के साथ वह भी लौटाना जिसकी पुष्टि नहीं हो सकी, इसी कारण को दर्शाता है कि यह शोधपत्र साक्ष्य की पर्याप्तता को सटीकता से अलग आँकता है।
5. क्या नया नहीं है, और सीमाएँ कहाँ हैं
कुछ हिस्से जाने-पहचाने हैं। तर्क को खोज के साथ पिरोना ReAct की शोध-धारा का अनुसरण करता है। दावों को बाहरी साक्ष्य से जाँचने का शोध इतिहास लंबा है। शिक्षक मॉडल के निशानों को छोटे मॉडल में आसवित करना एक मानक तकनीक है। योगदान को बेहतर ढंग से कार्य के निरूपण (बिना दिए गए दावे के तथ्यात्मकता), बेंचमार्क, और ऐसे मूल्यांकन के रूप में पढ़ा जाना चाहिए जो पूछता है कि साक्ष्य पर्याप्त है या नहीं, न कि केवल यह कि निर्णय सही है या नहीं।
सीमाएँ कई हैं। पहली, EviLens को कैसे बनाया गया। नियंत्रित निर्माण में तैयार की गई तस्वीरों में त्रुटियों के प्रकारों को व्यवस्थित करना आसान होता है, लेकिन हो सकता है कि वे इस बात से मेल न खाएँ कि दुष्प्रचार असल दुनिया में कैसे फैलता है। सार में यह नहीं बताया गया है कि विशेषज्ञ समीक्षा कितनी व्यापक थी।
दूसरा, स्वयं साक्ष्य की गुणवत्ता। एजेंट रिट्रीवल पर निर्भर करता है। यदि उसे मिली वेब सामग्री पुरानी, गलत या जानबूझकर डाली गई है, तो निर्णय भी उसी का अनुसरण करेगा। सार यह नहीं बताता कि खोज का दायरा या खोज की तारीख कैसे तय की गई थी।
तीसरा, संख्याओं को कैसे पढ़ें। दस में से लगभग आठ के करीब संतुलित सटीकता (balanced accuracy) का यह भी अर्थ है कि एजेंट लगभग हर पाँच मामलों में एक बार गलत है, और साक्ष्य की पर्याप्तता (evidence sufficiency) उससे भी कम है। यह ऐसा स्तर नहीं है जिस पर मानवीय समीक्षा को छोड़ा जा सके, और लेखक ऐसा दावा भी नहीं करते।
चौथा, पुनरुत्पादन क्षमता। सार में कहा गया है कि कोड, मॉडल और डेटा जारी किए जाएँगे। यह एक घोषित योजना है; इस समीक्षा ने यह जाँच नहीं की है कि रिलीज़ हुई है या नहीं।
6. यह विषय अभी क्यों उभर रहा है
चयन पाइपलाइन ने इस शोधपत्र को आकार 2 वाले "Agents and Autonomy" क्लस्टर में रखा। दूसरा शोधपत्र, "Beyond the Verdict", आधिकारिक सबमिशन खर्च किए बिना प्रतिस्पर्धी प्रोग्रामिंग समाधानों के आकलन और निदान का अध्ययन करता है, और वह उत्पन्न प्रतिउदाहरणों को जाँचे जा सकने योग्य साक्ष्य मानता है।[3]
इमेज और प्रोग्राम बहुत अलग सामग्री हैं। दोनों शोधपत्रों में साझा बात यह है कि वे केवल सही-गलत के निर्णय पर रुकने से इनकार करते हैं। दोनों सिस्टम से ऐसा प्रमाण मांगते हैं जिसे कोई तीसरा पक्ष जाँच सके। जैसे-जैसे एजेंटों को अधिक फैसले सौंपे जा रहे हैं, सवाल इससे बदलकर कि निर्णय सही है या नहीं, यह हो जाता है कि क्या कोई बाद में उसका ऑडिट कर सकता है, और दोनों शोधपत्र इस आवश्यकता को अपने मूल्यांकन में शामिल करते हैं।
रिकॉर्ड के लिए, संकेत मामूली हैं। Hugging Face के पेपर पेज पर इस काम को 44 अपवोट और 1 टिप्पणी मिली है, और इसकी GitHub रिपॉजिटरी के 0 स्टार हैं।[2] अपवोट दिखाते हैं कि शोधकर्ताओं ने पेपर पर ध्यान दिया। वे यह नहीं बताते कि इसके दावे सही हैं या व्यवहार में उपयोगी हैं। दो का क्लस्टर छोटा है, और इसे पूरी तरह विकसित प्रवृत्ति कहना जल्दबाज़ी होगी।
7. यह फ़ार्मास्युटिकल और नियामक कार्य से कहाँ जुड़ता है
फ़ार्मास्युटिकल कंपनियों के पास अनिश्चित मूल की तस्वीरें हर समय आती रहती हैं: सोशल मीडिया पर उत्पादों की तस्वीरें, संभावित नकली पैकेजिंग, प्रतिकूल घटना संबंधी पूछताछ के साथ संलग्न तस्वीरें, और प्रचार सामग्री में उपयोग के लिए प्रस्तावित तस्वीरें जिनके स्रोत की जाँच ज़रूरी है। इनमें से किसी का समाधान यह पूछने से नहीं होता कि तस्वीर जनरेट की गई थी या नहीं। मायने यह रखता है कि चित्रित स्थिति वास्तविक है या नहीं।
व्यवहार के लिहाज़ से सबसे प्रासंगिक डिज़ाइन विकल्प है निर्णय और उसके प्रमाणों की पर्याप्तता को अलग करना। विनियमित निर्णयों में, निष्कर्ष तक कैसे पहुँचा गया, इसका रिकॉर्ड अक्सर उतना ही मायने रखता है जितना कि निष्कर्ष। कमज़ोर आधार वाले सही निर्णय का ऑडिट में बचाव करना कठिन होता है। प्रमाणों की पर्याप्तता को उसके अपने अलग पैमाने पर आँकने से यह सोचने का तरीका मिलता है कि सत्यापन कार्य में AI जोड़े जाने पर स्वीकृति मानदंड क्या होने चाहिए।
फिर भी, इस तरह का एजेंट पहले चरण की छँटाई और जाँच के मसौदा लॉग के स्तर पर ही रहेगा। चूँकि यह इस पर निर्भर करता है कि किसी क्षण retrieval क्या लौटाता है, इसके निष्कर्ष उसी क्षण से बँधे होते हैं। लॉग को रखा जाना चाहिए, अंतिम निर्णय किसी व्यक्ति के पास रहना चाहिए, और वह व्यक्ति लॉग को पढ़कर उसकी जाँच कर सके। इस चरण पर किसी प्रीप्रिंट से जो लिया जा सकता है, वह विशिष्ट प्रदर्शन आँकड़ा कम और निष्कर्ष तथा साक्ष्य को अलग-अलग दर्ज करने की डिज़ाइन-आदत अधिक है।