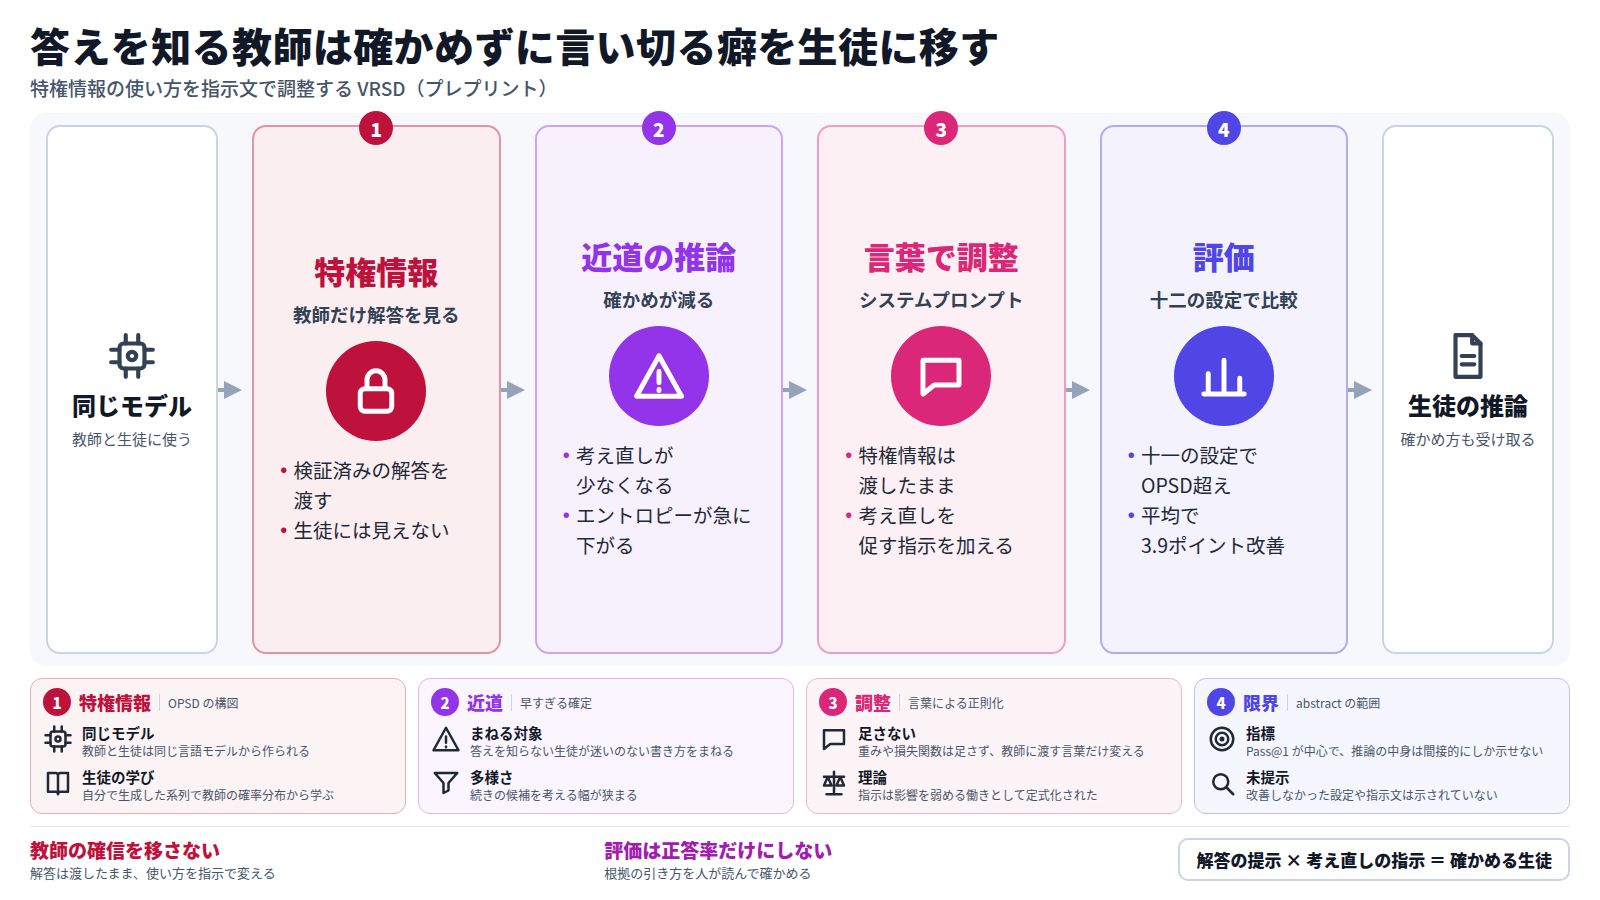
1. 答えを知っている教師は、確かめずに答えへ向かう
この論文が扱うのは、オンポリシー自己蒸留(OPSD)と呼ばれる学習法の弱点である。OPSD では、教師と生徒が同じ言語モデルから作られる。教師には、検証済みの解答のような「特権情報(PI)」が与えられる。生徒にはそれが見えない。生徒は自分で答えを生成し、その答えに沿って、教師が次の語ごとに出す確率分布から学ぶ。[1] 生徒が自分で生成した系列の上で教師の評価を受ける、という形は、先行研究のオンポリシー蒸留を受け継いでいる。[5]
問題は、答えを知っている教師のふるまいにある。著者らによれば、特権情報は教師の指導を「近道の推論」へ偏らせる。途中で確かめたり考え直したりする過程が少なくなり、それと同時に出力の分布のエントロピー(どれだけ多様な続きを考えているかの目安)が急に下がる。生徒は、答えを知らないまま、答えを知っている者の迷いのない書き方をまねることになる。著者らはこれを「早すぎる確定(premature commitment)」の問題として捉えている。
2. 提案の芯 ── 特権情報の使い方を、指示文で調整する
提案された VRSD(言葉による正則化つきの自己蒸留)の芯は一つである。教師が特権情報をどう使うかを、システムプロンプトで調整する。特権情報を取り去るのではなく、教師に渡したまま、考え直しや別の筋の検討を促す指示を加える。そうすることで、教師の出す分布が答えへ一直線に偏るのを抑え、早すぎる確定を打ち消すことを狙う。
この論文は、手法を経験則だけで終わらせず、理論の側からも説明しようとしている。プロンプトによる指示を「教師の分布に対する特権情報の影響を弱める働き」として定式化し、エントロピーが保たれる条件を導いたという。学習のための重みや損失関数を新しく足すのではなく、教師に与える言葉を変えることで正則化をかける点が、名前の「言葉による正則化」の意味である。
3. abstract の範囲で示されたこと
- 規模:三つのモデルと四つの課題を組み合わせた設定で評価したとされる。
- 結果:Pass@1(一回目の答えが正解になる割合)で、OPSD を十二の設定のうち十一で上回り、平均の改善は 3.9 ポイントだったとされる。
- エントロピー:多くの場合、OPSD よりも語ごとのエントロピーを高く保ったと書かれている。
- 理論:プロンプトを特権情報の影響を弱めるものとして扱い、エントロピーが保たれる条件を導いたとされる。
abstract の書き方には慎重さもある。改善しなかった設定が一つあり、エントロピーも「概ね」高く保たれたという表現である。どのモデルとどの課題で評価したか、改善しなかった設定がどれだったかは、abstract の範囲では示されていない。
4. 具体例で見る ── 解答を持った教師の二つの書き方
教師への指示が何を変えるのかを、具体的な学習の場面で示す。以下は手法の考え方を説明するための例であり、論文で使われた課題やプロンプトそのものではない。社内文書をもとにした質問に答えるモデルを、検証済みの模範解答を特権情報として使って自己蒸留する場面を考える。
指示なしで解答を見た教師(OPSD)
解答を知っているので、該当箇所を一度だけ引いてすぐに結論を書く。別の条項を確かめる、例外がないか見直す、といった語の続きにはほとんど確率を置かない。生徒は「迷わず書く」形だけを受け取る。
考え直しを促す指示つきの教師(VRSD)
同じ解答を見ているが、「結論の前に根拠を確かめ、別の読み方がないか検討する」よう指示されている。確認や見直しにつながる語の続きにも確率が残る。生徒は答えに至る途中の確かめ方も受け取る。
学習担当者:模範解答を教師に渡すと、正答率は上がるはずでは。
解説:教師の答えは正しくなります。ただ生徒は解答を見られないので、教師の確信だけをまねると、根拠の確かめ方を身につけないまま断定する癖がつく、というのが著者らの見立てです。
学習担当者:だから解答は渡したまま、使い方を指示で変えるわけですね。
解説:そうです。この論文の範囲では、それで多くの設定の正答率が上がり、出力の多様さも概ね保たれたと報告されています。
5. 何が新しくないか、どこに限界があるか
同じモデルを教師にも生徒にも使う自己蒸留、生徒の生成した系列で教師が評価するオンポリシー蒸留、教師だけが見られる情報を使う学習は、いずれも先行研究に例がある。システムプロンプトでモデルのふるまいを変えることも日常的に行われている。この論文の新しさは、OPSD で起きる近道とエントロピーの低下を問題として切り出し、それを教師への指示で抑えるという組み合わせと、その理論的な説明にあると読むのが妥当だろう。
限界は複数ある。第一に、評価の指標が Pass@1 に限られている点である。正答率が上がっても、途中の推論が実際に確かめる過程を含むようになったかは別の問題で、abstract はエントロピーの数値でそれを間接的に示すにとどまる。エントロピーが高いことは、考え直していることと同じではない。
第二に、プロンプトへの依存である。どのような指示文を使ったか、指示を変えると結果がどれだけ変わるかは、abstract の範囲では示されていない。指示の書き方しだいで効果が変わるなら、他の課題に移すときに調整の手間がかかる。
第三に、理論の範囲である。プロンプトを「特権情報の影響を弱めるもの」とみなすのは単純化した模型であり、実際の言語モデルでその仮定がどこまで成り立つかは、abstract からは判断できない。
6. この主題が今なぜ束になっているか
選定の仕組みは、この論文を「LLM の基盤技術」の分類で拾い、もう一本の論文と束にした。束の大きさは 2 である。相手は「VASPO: Self-Distillation with Privileged Value Estimation」で、題名から読む限り、同じく特権情報を使う自己蒸留を扱い、教師の分布ではなく価値の推定の側に特権情報を使う方向をとっている。[4] 束に付いた特徴語には、価値の予測、critic、語ごとのアドバンテージといった強化学習の語が並ぶ。
二本に共通する問いは、「答えを知っている自分」をどう教師として使えば、生徒の推論を損なわずに済むか、である。外部の大きな教師モデルに頼らず、同じモデルから教師を作る自己蒸留は、計算の費用を抑えられる方法として関心を集めている。そこで特権情報の使い方が新たな課題として浮かび上がった、という流れである。
話題性の数字も記しておく。Hugging Face の論文ページでの upvote は 27、コメントは 2、公開コードの GitHub スターは 4 である。[2][3] いずれも話題性の目安であって、主張の正しさを示すものではない。束も二本と小さく、主題として大きく立ち上がったと言える段階ではない。
7. 製薬・規制の現場から見ると何が接続するか
製薬企業が社内文書や規制文書に沿って答えるモデルを調整するとき、検証済みの模範解答は手元にあることが多い。この論文は、その模範解答の使い方に注意を向ける。解答を見せた教師から学ばせると、正答率は上がっても、根拠を確かめずに言い切る書き方まで受け継ぐおそれがある。資材の審査や問い合わせ対応のように、結論より根拠の示し方が問われる業務では、この癖のほうが問題になりやすい。
もう一つの接点は評価の仕方である。この論文でも、改善は正答率で測られている。社内でモデルを評価するなら、正答率と並べて、根拠をどの資料のどこから引いたか、別の解釈を検討したか、といった推論の中身を人が読んで確かめる工程が要る。
プレプリントの段階の結果をそのまま社内の学習に持ち込むことはできない。ただ、「正しい答えを渡した教師は、確かめる過程を省いた手本を見せてしまう」という指摘は、人の教育にもモデルの学習にも当てはまる論点として、学習データの設計を見直す材料になる。