1. この論文は何を問題にしているか
LLM の医療応用をめぐる研究の多くは、正答率を問うてきた。診断名を当てられるか、試験問題に答えられるか、医師より正確か。けれども診療の現場で AI の提案が採用されたとき、最初に動くのは検査のオーダーであり、紹介状であり、処方である。そこには必ず費用が伴う。
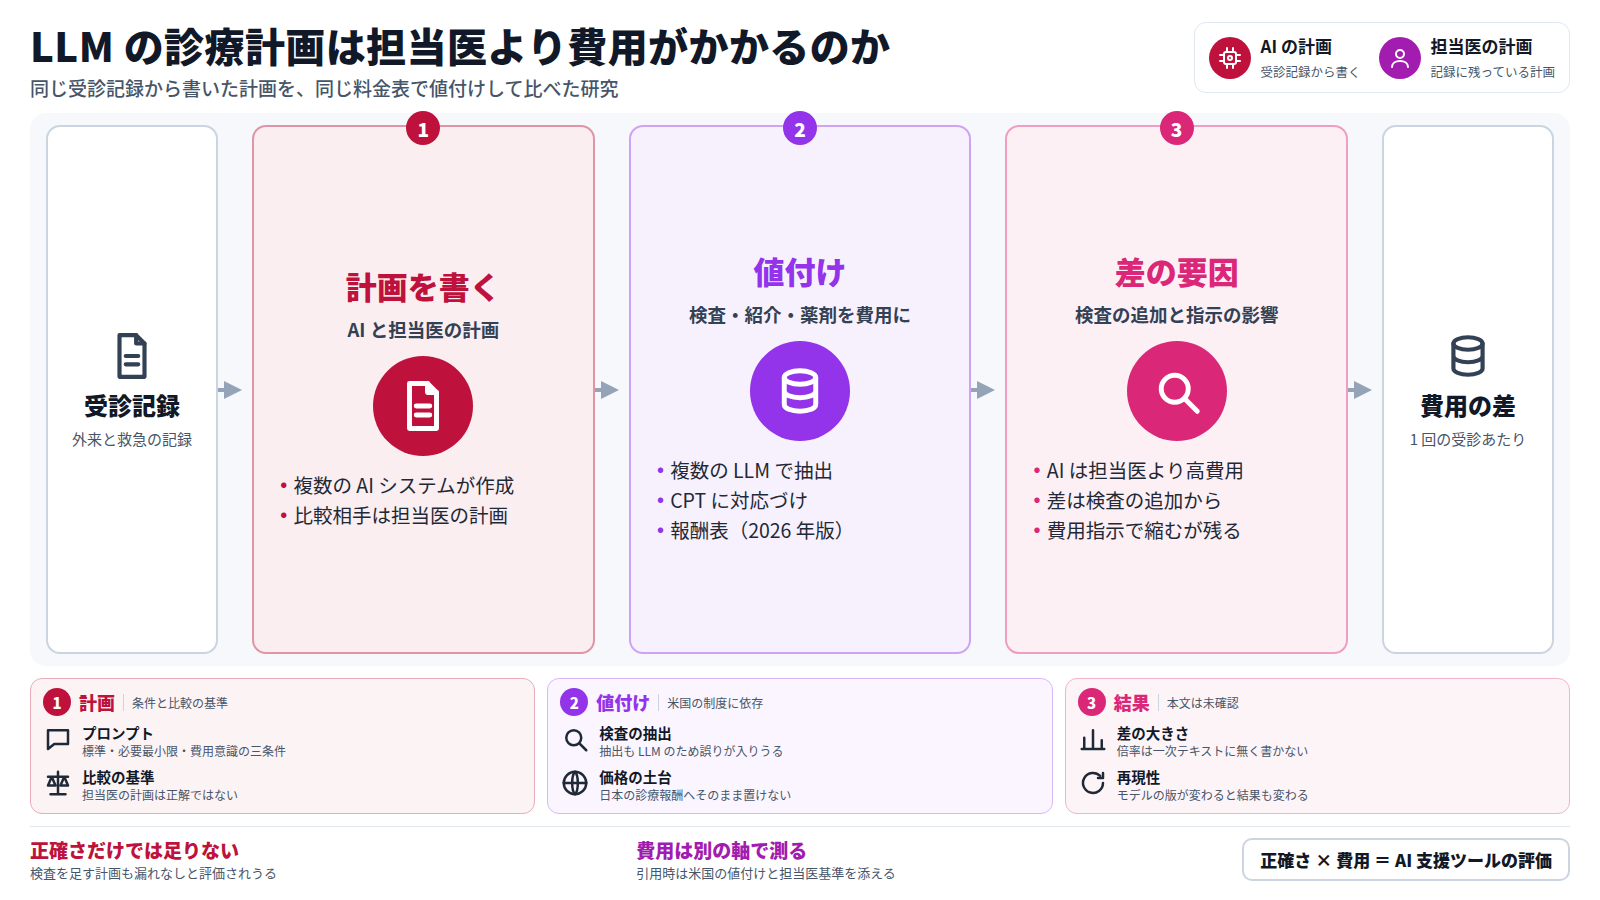
NEJM AI に査読を経て掲載されたこの原著論文は、問いを正確さから費用へ移している。同じ受診記録を読んだとき、LLM が書く診療計画と、実際にその患者を診た担当医の計画とでは、かかる費用が違うのか。違うとすれば何が差を生み、指示の出し方(プロンプト)で差は変わるのか[1]。
正答率が高い AI でも、念のための検査を積み上げる傾向があれば、医療費と患者の負担は増える。逆に費用を抑えすぎれば見逃しが増える。正確さと費用は別の軸で測らなければならない、というのがこの論文の出発点である。
2. 何を提案しているか
手法の芯は、AI の計画と担当医の計画を「同じ料金表」で値付けして比べるという設計にある。著者らが公開したデータと解析コードの説明によれば、外来と救急の受診記録から患者の提示情報を取り出し、汎用 LLM と医療特化システムを合わせた複数の AI システムに、評価と診療計画を書かせた。比較の相手は、記録に残っている担当医の計画である[3][4]。
計画に含まれる検査・紹介・薬剤は、互いに独立した複数の LLM で抽出し、米国の診療行為コード(CPT)に対応づけた。そのうえで米国メディケアの医師報酬表(2026 年版)で値付けし、薬剤は米国の薬価調査データで値付けしている。プロンプトは標準の指示に加えて、「必要最小限に絞る」指示と「費用を意識する」指示の二つの条件を用意した[4]。
つまりこの研究は、AI に新しい能力を与える提案ではない。すでにある AI の出力を、医療経済の物差しで測り直す提案である。
3. 何を示したか ── 確認できた範囲だけ
まず断っておく。本サイトが収集した書誌情報では、この論文の abstract 欄は「NEJM AI, Ahead of Print.」の一文だけで、要旨は含まれていなかった。執筆時点で NEJM AI の論文ページは参照できず、本文は読めていない。以下は、著者グループが自らの発表一覧に載せた要約に基づく[2]。
その要約によれば、AI システムが勧めた診療は、1 回の受診あたりの費用が担当医の診療を上回った。差の多くは、担当医が検査を出さなかった受診で AI が検査を加えたことから生じていた。費用を意識させるプロンプトは差を縮めたが、なくしはしなかった、と著者らは書いている。
要約には差の大きさを示す倍率も載っている。ただし本記事は、収集した一次テキストに無い数値を書かない方針をとっているため、ここでは倍率を挙げない。大きさを確かめたい読者は、NEJM AI の本文と著者らの要約に直接当たってほしい。
公開リポジトリには、医師による適切性の評価、AI と担当医の診断の一致、繰り返し実行したときの再現性なども解析項目として並んでいる[4]。これらの結果が本文でどう報告されているかは、本記事の範囲では確認できていない。
4. 具体例で見る
製薬企業のメディカル部門で、医療従事者向けの AI 支援ツールを検討している場面を考える。
社内検討会での一場面
開発担当:「評価用の症例で、診断の一致は担当医とほぼ同じ水準でした。計画にも漏れがありません」
医療経済の担当:「計画に出てくる検査の数は数えましたか。担当医が経過観察にした受診で、AI は血液検査や画像検査を足していませんか」
開発担当:「念のための検査が多い印象はあります。ただ、見逃しを防ぐ意味では安全側です」
医療経済の担当:「安全側かどうかは、その検査で方針が変わったかで決まります。費用も患者の負担も増えるので、正確さとは別に測らないと評価になりません」
この論文が持ち込んだのは、二人目の担当者の視点である。正答率の比較では、検査を足しすぎる計画も「漏れのない計画」として高く評価されうる。費用で並べ直すと、その偏りが見えてくる。
5. 何が新しくないか/限界はどこか
LLM と医師を比べる研究そのものは多数ある。診断の正確さ、試験問題、画像の読影など、比較の枠組みは新しくない。この論文の新しさは比較の物差しを費用に変えた点にあり、手法の部品(記録からの抽出、コード対応、報酬表による値付け)はいずれも医療経済研究で使われてきたものである。限界としては、少なくとも次の点が読み取れる。
- 担当医の計画は正解ではない。比較の基準は担当医の計画であり、担当医が検査を出さなかったことが適切だったとは限らない。AI が加えた検査の一部は、担当医の見落としを補うものだった可能性も残る。費用の差だけでは、どちらが患者にとって良かったかは決まらない。
- 値付けは米国の制度に依存する。メディケアの報酬表と米国の薬価データで値付けしているため、日本の診療報酬や薬価にそのまま置き換えることはできない。差の向きは参考になっても、大きさは制度によって変わる。
- 受診記録は文字情報である。AI は記録を読んで計画を書いたが、担当医は患者と対面し、本人の希望や保険の事情も踏まえて決めている。同じ情報で比べたとは言い切れない。リポジトリには公開の医療文書コーパスの写しも収められているが、症例がどこから採られたかの詳細は、本記事の範囲では確認できていない。
- 再現には限りがある。リポジトリの説明自体が、モデルの版や API の提供状況は変わるため再実行しても同じ結果にはならない、と断っている。保存された出力は 2026 年の春に観察されたモデルの振る舞いである[4]。
- 抽出も LLM が担っている。計画から検査や薬剤を取り出す工程に LLM を使っているため、その抽出誤りが費用の推定に入りうる。複数の LLM を使う設計で誤りを抑えようとしているが、誤りの程度は本記事の範囲では確認できていない。
6. 紹介記事は何をどう伝えたか
本サイトの選定処理は、この論文を「査読を通り、独立した複数の媒体が紹介した論文」として選んだ。紹介媒体として挙がったのは Nature、Science、Frontiers、Neurology Today、medRxiv の 5 つである。ところが見出しを並べると、いずれもこの論文を扱ったものではない。
- Nature「Multimodal large language models challenge NEJM image challenge」── 画像問題での正答
- Science「Performance of a large language model on the reasoning tasks of a physician」── 医師の推論課題での成績
- Neurology Today「Large Language Model Beats Doctors in Accuracy of Diagnostic Coding」── 診断コード付けの正確さ
- medRxiv「Multimodal Large Language Model Passes Specialty Board Examination…」── 専門医試験の得点
- Frontiers「Blinded two-phase evaluation of large language models in complex cardiac surgery…」── 心臓外科での課題別の性能
五つとも、題目に LLM と医師との比較を含む別の研究である。選定処理は語の重なりで紹介記事を拾っており、この論文そのものが報道された証拠にはなっていない。「独立した複数の媒体が紹介した」という選定理由は、この論文については成り立っていないと見るべきである。
ただ、このずれは読み方の手がかりにもなる。拾われた見出しはどれも「AI は医師より正確か」という問いの上にある。この論文はその外側、つまり正確さが同等でも費用は同等とは限らない、という側を扱っている。報道の関心が正確さに集まっている時期に、費用という別の物差しが査読誌に出たことは記録しておく価値がある。なお、査読誌に掲載されたことも、本サイトで選ばれたことも、結果の正しさや臨床的な価値、新規性を保証するものではない。
7. 製薬・規制の現場から見ると何が接続するか
第一に、AI 支援ツールの評価項目である。医療従事者向けに AI が診療の選択肢を示す仕組みを作るなら、正確さに加えて、その提案が検査・紹介・処方をどれだけ増やすかを評価に入れる必要がある。この論文の設計は、そのための一つの型を示している。
第二に、プロンプトが結果を動かすという点である。著者らの要約では、費用を意識させる指示で差が縮んだ。システムプロンプトは製品の振る舞いを決める仕様の一部であり、変更管理と記録の対象になる。指示一つで推奨の傾向が変わる以上、どの指示で評価したかを残しておかなければ、評価結果は再現できない。
第三に、医療経済評価との接続である。AI が推奨に関わる場面が増えれば、薬剤や検査の使われ方そのものが変わりうる。費用対効果の評価や市販後の使用実態の調査で、AI の推奨がどの程度関わったかを把握する視点が、今後必要になる可能性がある。
いずれも、この論文の結果を日本の制度にそのまま当てはめてよいという意味ではない。値付けの土台が米国の制度である点、比較の基準が担当医の判断である点は、引用するときに必ず添えておきたい。