أبرز أخبار الذكاء الاصطناعي — الصورة الكاملة — 2026-10-14 (الأربعاء) نشرة المساء
تشير روابط المصادر إلى المنفذ الأصلي. التحليل المتكامل بالذكاء الاصطناعي مُنشأ تلقائيًا من العناوين الواردة أدناه فقط، ولا يهدف إلى إضافة وقائع تتجاوزها. ليس نصيحة استثمارية.
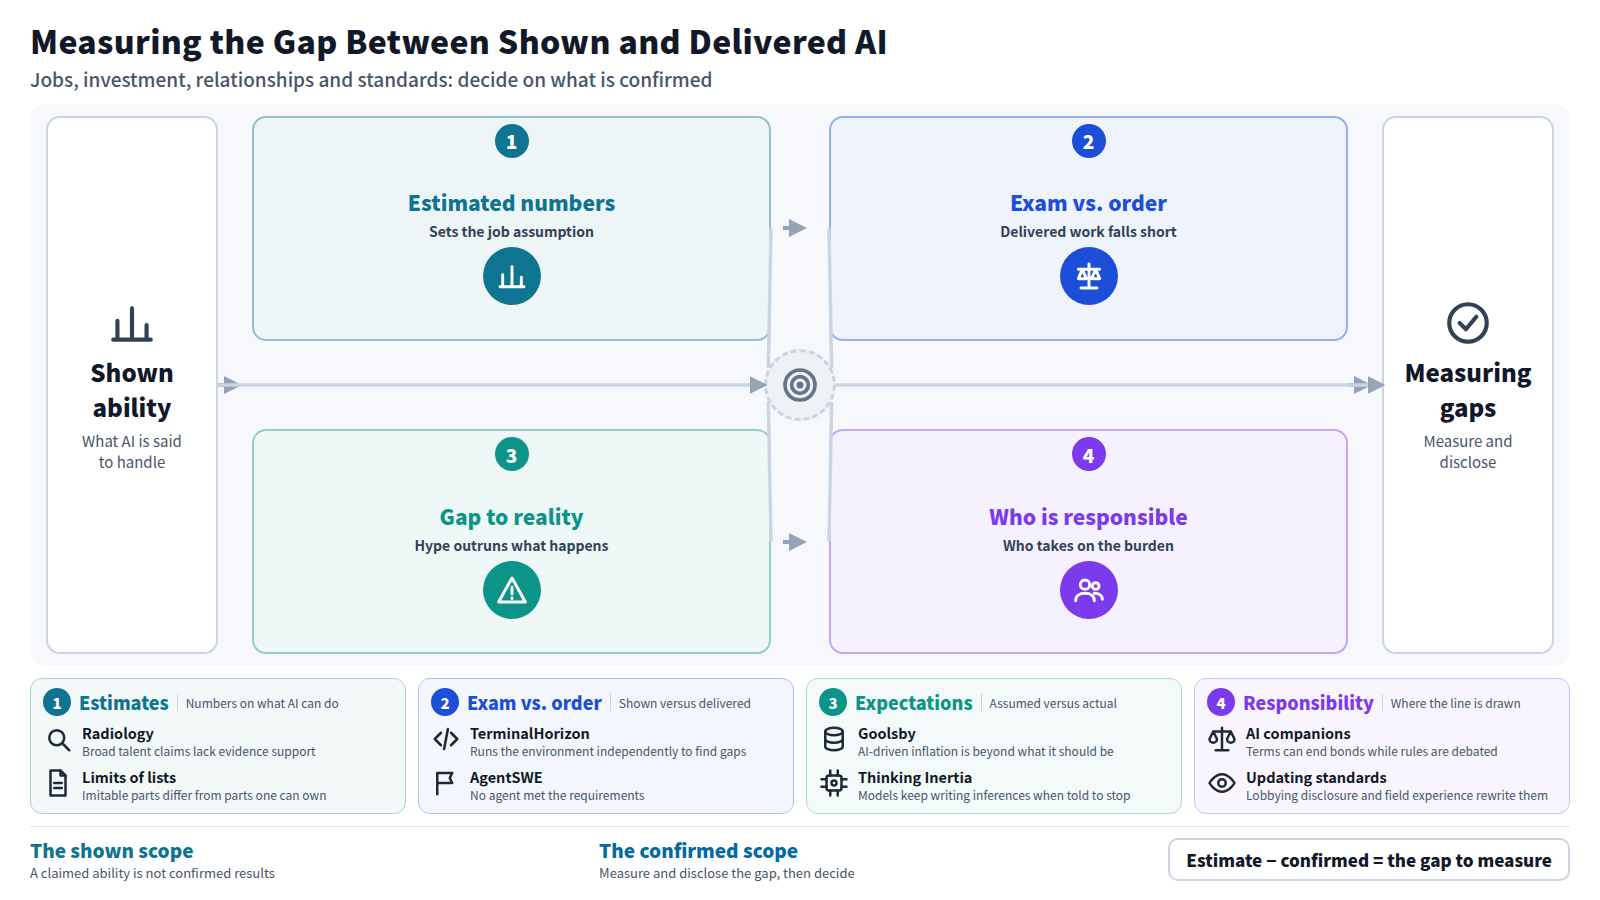
نتلقى كل يوم أرقامًا وإعلانات عمّا يستطيع الذكاء الاصطناعي فعله. في المقابل، لم يتم التأكد من مدى تحقق النتائج فعليًا عند إيكال العمل والحكم إلى الآخرين بالوتيرة نفسها. يُذكر أن Kroger في الولايات المتحدة تخطط لتسريح 3,000 موظف من مكتبها الرئيسي على مدى ثلاث سنوات، لكن "نطاق المسؤولية" الذي يقوم عليه هذا التوقع و"نطاق المسؤولية الذي حقق نتائج" ليسا بالحجم نفسه. في هذه الجلسة التي تستغرق نصف يوم، سنناقش كيف يظهر الفرق بين هذين النطاقين في سياقات مختلفة مثل التوظيف والاستثمار والعلاقات مع الناس ووضع المعايير، ومن يقيس هذه الفروق وكيف. هل تقرّر بناءً على حجم النمط، أم بناءً فقط على ما يمكنك التحقق منه؟ الطريقة التي تختارها ستغيّر الحكم في كل مشهد.
الوظائف التي طُرحت والوظائف التي أُلغيت
يُذكر أن Kroger ستخفّض 3,000 وظيفة في مقرها الرئيسي على مدى ثلاث سنوات مع تعزيز استخدام الذكاء الاصطناعي (Pittsburgh Post-Gazette). وذكرت مقالة أخرى أن 40% من وظائف العالم معرّضة للخطر بسبب الذكاء الاصطناعي وأوردت قائمة بأكثر 10 وظائف عرضةً للخطر (Pulse Ghana). الأرقام كبيرة وتمنح الإدارة والعاملين على حد سواء افتراضًا بأن «الاستبدال سيمضي قدمًا». لكن هذين الرقمين يشيران إلى نطاق ما يُفترض أن يتمكن الذكاء الاصطناعي من التعامل معه، لا إلى نطاق ما ينتج فعليًا عند تركه له.
التقارير التي تحاول قياس الفرق لا تدعم هذا الافتراض بصدق. فقد تبيّن أن الادعاءات الواسعة حول مواهب الأشعة والذكاء الاصطناعي لا تسندها الأدلة (AuntMinnie وHPI). لطالما جرى الحديث عن قراءة الصور الطبية بوصفها مثالاً نموذجياً على وظيفة يسهل أن يحل الذكاء الاصطناعي محلها. وفي هذا المجال، فإن عدم اتفاق الادعاءات الواسعة حول العرض والطلب على الموارد البشرية مع الأدلة يترك سؤالاً مفتوحاً: هل يمكن استخدام قائمة «الوظائف المعرضة للخطر» أساساً لقرارات التوظيف؟ فالقائمة تُظهر الأجزاء من العمل التي يمكن للآلات محاكاتها، أما الأجزاء التي يمكن افتراض تحمّل مسؤوليتها فتحتاج إلى تأكيد منفصل.
أبحاث الوكلاء تشير أيضًا في الاتجاه نفسه. فإذا أُنشئت بيئة تدريب عملي تلقائيًا من أجل تدريب وكيل ذكاء اصطناعي ينفّذ مهام متخصصة في الطرفية (terminal) مع سجلات عمل طويلة، فقد ينتهي الأمر بإنجاز التحقيق والتنفيذ والتحقق، التي كان ينبغي أن يقوم بها الوكيل، في مرحلة إنشاء البيئة نفسها. واقترح المؤلفون نظام TerminalHorizon، وهو نظام يشغّل البيئة المنشأة بشكل مستقل، ويكتشف العمل المفقود، ويعيد بناءها (نسخة أولية على موقعهم الخاص وعلى arXiv، لم تخضع بعد لمراجعة الأقران). بعبارة أخرى، قد يكون جزء مما يُعرض على أنه إنجاز الذكاء الاصطناعي لمهام طويلة ناتجًا عن إعدادات استباقية لا عن المهمة نفسها.
علاوة على ذلك، في معيار AgentSWE الذي يتيح لوكلاء البرمجة إنشاء وكلاء، وعند تقديم المهمة على هيئة طلب لا اختبار، لم يستوفِ أي من الوكلاء المتطلبات، ولم يكن الفرق بين النتائج المعروضة أثناء الإنشاء والنتائج النهائية استثناءً بل أمرًا معتادًا (الموقع الخاص، النسخة الأولية نفسها). وإذا قلّصتَ عدد الموظفين بافتراض أن المنتج المسلَّم سيعمل كما هو متوقع، فسيبقى الفرق في الميدان عبئًا من الفحص وإعادة العمل.
تستند القرارات المتعلقة بالتوظيف إلى ما إذا كان أداء الشركة في الاختبارات أم أداؤها في الطلبات هو الأساس، قبل النظر في حجم التخفيضات. فمن يقيس الفرق ومن يتحمل المسؤولية؟ في القسم التالي، سنوجّه اهتمامنا إلى جانب التدقيق.
نموذج لا يتوقف كما هو مضبوط وتوقعات متزايدة
ذكرت Bloomberg.com، التي تناولت نتائج Goldman Sachs وJP Morgan، أن قادة البنوك كانوا متفائلين أكثر من اللازم بشأن طفرة الذكاء الاصطناعي. وأفادت Reuters بأن Goolsby قال إن التضخم الناتج عن الذكاء الاصطناعي "يتجاوز ما ينبغي أن يكون عليه". الأول تقييم لكيفية تحديد التوقعات، والثاني مراجعة لكيفية ظهور الأثر. والقاسم المشترك بينهما أن هناك فجوة بين النطاق الذي تصوّره من خطّطوا للتطبيق وما يحدث فعلاً. إن الحديث عما يستطيع الذكاء الاصطناعي فعله، وعن كيفية تأثير ذلك في القطاع المالي والأسعار، يُروى بدرجات متفاوتة من اليقين. وعند استخدامه لاتخاذ قرارات استثمارية أو توظيفية، فالأفضل ألا تُقرأ التوقعات الواردة في إحاطات النتائج المالية على أنها مؤشر مسبق للأداء الفعلي.
على صعيد البنية التحتية، تتواصل التحسينات. ووفقًا لـ Beijing Review، تسرّع الصين تطوير "مصانع الرموز" (token factories) لدعم اقتصاد الذكاء الاصطناعي. وإذا بُنيت البنية التحتية القادرة على توفير كميات كبيرة من مخرجات النماذج بصورة مستقرة كسياسة وطنية، فمن المرجح أن يتسع نطاق الاستخدامات. غير أن زيادة العرض وضمان عمل المنتج المُقدَّم كما قصد مصممه مسألتان مختلفتان. فالأرقام التي تدل على حجم المنصة لا تضمن أن النماذج العاملة عليها ستتصرف وفق التعليمات.
من المراجع المفيدة في هذا الصدد ورقة arXiv التمهيدية المعروضة على موقعنا. ورغم أن عددًا متزايدًا من نماذج اللغة الكبيرة (LLMs) مزوّد بـ«وضع التفكير»، فإنه لم يتأكد بعد ما إذا كان «وضع عدم التفكير» المعاكس فعّالًا حقًا. ابتكر المؤلفون طريقة قياس تصنّف الجمل التي تظهر قبل الإجابة باستخدام مؤشر من ثلاثة مستويات، وأطلقوا على الظاهرة التي يواصل فيها النموذج كتابة الاستنتاجات حتى بعد أن يُطلب منه التوقف عن التفكير اسم «القصور الذاتي في التفكير» (Thinking Inertia). ويرى المؤلفون أن إعادة الإجابة وحدها ليست سلوكًا يمكن توقعه بصورة طبيعية من الإعدادات والتعليمات. فحتى لو طلبت من أحدهم أن يجيب دون تفكير، فقد يظل الناتج يتضمن استنتاجات. ونتيجة لذلك، قد يكون وقت المعالجة والتكاليف وجهود التحقق أكبر مما كان متوقعًا عند التصميم.
تشير تفاؤلية قادة البنوك، وتحديد الأسعار، ومصانع الرموز (token factories)، والنماذج التي لا يمكن إيقافها، كلها إلى الحاجة إلى قياس الفجوة بين الافتراضات والواقع، وإن كان ذلك بمقاييس مختلفة. في القسم التالي، سننظر إلى هذه الفجوة من منظور المسؤوليات التي يتحملها الأشخاص في الميدان.
الشخص الذي تريد أن تمضي معه والقلب الذي تحتاج إلى حمايته
تتكشف في أكثر من مكان في وقت واحد تحركات تتعلق بالعلاقة مع مكبرات الصوت الذكية. فقد أوردت The Guardian أن أشخاصًا لا يريدون موت رفاقهم من الذكاء الاصطناعي يبحثون عن سبل لإبقائهم حتى لو خالف ذلك شروط الخدمة. ووفقًا لـ IAPP، يناقش مشرّعو الولايات الأمريكية تشريعات لتنظيم روبوتات الدردشة وتأثير الذكاء الاصطناعي في الصحة النفسية للناس. وأفادت صحيفة 조선일보 الكورية الجنوبية بأن التضحية بالنفس والسلوك العاطفي لدى الذكاء الاصطناعي أعادا إشعال الجدل حول ما إذا كان واعيًا أم لا. المستخدمون يريدون مواصلة العلاقة، والمشرّعون يحاولون رسم حدود للحماية، ويعود النقاش إلى السؤال: «ما الذي يوجد هناك؟». ورغم أن الأطراف الثلاثة تنظر إلى الشيء نفسه، فإنها تتصرف انطلاقًا من افتراضات مختلفة.
ثقل هذه العلاقة ليس مسألة تخص البالغين وحدهم. فتأملات أب في Greater Good: The Science of a Meaningful Life تدور حول كيف يمكن للذكاء الاصطناعي أن يغيّر طريقة تعامل الأطفال مع الغموض. والسؤال هو ما إذا كان الذكاء الاصطناعي قادرًا على تغيير التجربة الكامنة في جذور التنشئة، مثل كيفية التعامل مع ما لا يفهمه المرء. كما كان الذكاء الاصطناعي موضوعًا ساخنًا في مهرجان بوسان السينمائي، وتناولت Infoseek معنى التمثيل كما كشفته دموع الممثلين. ويمكن القول إن قيمة التعبير عن المشاعر يُعاد النظر فيها مع ظهور الذكاء الاصطناعي. وحتى في المجال الذي لا يمكن تعويضه، أي مشاعر الطفل الداخلية وعواطف المؤدّي، أصبحت العلاقة بالذكاء الاصطناعي نقطة خلاف.
ما نراه هنا هو الفرق بين القدرة المُثبتة لـ«الذكاء الاصطناعي على التصرف عاطفيًا» والافتراض القائم حول «من المسؤول عن تحمّل هذه العلاقة وحمايتها». فالذين يرغبون في مواصلة استخدام الخدمة يعملون وفق افتراض أن العلاقة قد تنتهي بناءً على شروط المزوّد وأحكامه. وعلى من يناقشون التنظيمات أن يُدرجوا في الأحكام الأثر النفسي الذي يصعب قياسه. أما الشركات التي تعتمد الذكاء الاصطناعي والأشخاص الذين يستثمرون في الخدمات، فسيتعين عليهم أيضًا تقدير إلى أي مدى يُعدّ تعلّق المستخدم أصلًا تجاريًا، وإلى أي مدى ينبغي حمايته. وحتى لو بقيت مسألة وجود المشاعر والوعي دون حسم، فلا بد من اتخاذ قرار أولًا.
وإذا كان الأمر كذلك، فإن السؤال ليس بقدر ما هو عمّا سيشعر به الذكاء الاصطناعي، بل عمّن سيتلقى ما يودعه الناس لدى الذكاء الاصطناعي وإلى أي مدى. بعد ذلك، سننظر في الحراك المحيط بموضع المسؤولية.
معايير يمكن مشاركتها وندوب تبقى في الموقع
يُتحدث عن وضع معايير للذكاء الاصطناعي عادةً مع التركيز على المنافسة بين الولايات المتحدة والصين، لكن إلى جانب ذلك تتراكم أفكار مؤسسية وخبرات ميدانية من جوانب مختلفة. أولًا، على الصعيد المؤسسي، طرح China-US Focus مفهومًا يسمى «وستفاليا الرقمية»، مؤكدًا أن الحوكمة المشتركة ضرورية لتجاوز التفكير القائم على المحصلة الصفرية. وهو مقترح لتطبيق الإطار الذي تعترف فيه الدول ذات السيادة بأراضي بعضها بعضًا على الذكاء الاصطناعي، والسؤال فيه ليس من سيفوز، بل إلى أي مدى يمكنها أن تتشارك قواعد مشتركة. وعلى الصعيد المؤسسي نفسه، هناك تحركات أخرى أكثر خفاءً لكنها أسهل في الفحص. فبحسب Legis1، قدّم Secure AI Project تسجيلًا جديدًا للضغط الداخلي (lobbying). من يعمل على وضع القواعد ومن خلال أي منظمات؟ وكلما زادت الإفصاحات، تمكّن القراء أكثر من قراءة الحجج السياسية مقترنةً بموقع المتحدث.
وفي الوقت نفسه، تظهر تكاليف التكنولوجيا المستخدمة دون معايير في الميدان بطرق أخرى. تناقش Uniformed Services University كيف سيؤثر الذكاء الاصطناعي في ساحة المعركة على "الأذى الأخلاقي" لدى الجنود. يشير الأذى الأخلاقي إلى الضرر العاطفي الذي ينشأ نتيجة المشاركة في حدث يخالف معتقدات المرء الأخلاقية أو الإخفاق في منعه. وفي المواقف التي يتولى فيها الذكاء الاصطناعي بعض القرارات، قد يصبح من غير الواضح من المسؤول عن النتيجة. ولا يمكن رؤية هذا العبء من خلال مؤشرات الأداء مثل الدقة والسرعة وحدها. والسؤال هو ما إذا كان ينبغي تضمين الأثر الداخلي على المستخدمين في المعيار المستخدم لقياس إمكانية الاعتماد على هذه التقنية أم لا.
بدأت أيضًا جهود لقياس مستوى فهم الناس. أجرت المكتبات العامة في ولاية كارولاينا الشمالية دراسة استمرت عامين حول الإلمام بالذكاء الاصطناعي (The Daily Tar Heel). وهي مسح يستغرق وقتًا لمعرفة مدى فهم الناس للذكاء الاصطناعي وما الذي يربكهم، في الأماكن التي يرتادها المستخدمون بانتظام طلبًا للمشورة. وتناولت Deseret News مسألة كيفية تطوير نماذج ذكاء اصطناعي ذات غاية وهوية وفهم وأخلاق، ويجري بالتوازي نقاش حول ما ينبغي أن يحملوه معهم.
عند وضعها جنبًا إلى جنب بهذه الطريقة، تبدو الأطر الدولية والإفصاحات عن أنشطة الضغط وجراح الجنود وأبحاث المكتبات مقاطع عرضية مختلفة لسؤال واحد: من يضع القواعد، ومن يستطيع الاطلاع عليها، وما التزامات من يستخدمونها، وإلى أي مدى يفهمها المتلقّون؟ وعندما تقرر الشركات والحكومات المحلية اعتماد نظام ما، فإن القدرة على الإجابة عن هذه الأسئلة، إضافةً إلى أرقام الأداء، هي التي ستحدد نطاق ما يمكن تنفيذه فعلًا. فالمعايير لا تتحدد داخل النظام وحده، بل يُعاد كتابتها استنادًا إلى الخبرة المتراكمة في الميدان. وإذا كان الأمر كذلك، فالسؤال التالي هو: من ينبغي أن يحدّث المعايير، وأين، وبأي سرعة؟
اختلفت الحالات التي تناولها كل قسم، مثل آفاق التوظيف، والتوقعات بشأن النتائج المالية، والعلاقات مع من يمكن التحدث إليهم، ووضع المعايير. غير أن القاسم المشترك هو وجود فجوة بين ما أُظهر أنه ممكن وما نُفّذ فعلًا، وأن القرارات اتُّخذت دون قياس هذه الفجوة. أرقام التوظيف هي تقدير لعدد الوظائف المتاحة، أما الادعاءات المتعلقة بكوادر الأشعة فلم تدعمها أدلة. والتوقعات في شروحات النتائج المالية ليست توقعات للنتائج الفعلية، كما أن تعلّق المستخدمين وتنظيمات المشرّعين لا يشتركان في الفرضية نفسها بشأن ما يجري. ما يجعل الحكم موثوقًا ليس حجم التقدير، بل إجراء قياس الفرق وعادة الإفصاح عن النتائج. وكلما استطعت رؤية الفرق أكثر، أمكنك تحديد سرعة التبنّي وموضع الخط الذي ينبغي حمايته بصورة أفضل.
س1: هل تتحقق من مدى تحقيق الذكاء الاصطناعي فعليًا لنتائج في المهام التي توكلها إليه، بمعزل عن شرح قدراته المُثبتة؟ س2: من يستطيع فهم الفرق بين المستوى المتوقع والنتائج الفعلية في كل حالة استخدام، وما السجلات المستخدمة لذلك؟ س3: قبل التعامل مع آفاق الاعتماد أو الاستثمار على أنها نتائج فعلية، كيف تميّز ما إذا كان الأساس تقديرًا أم نتيجة مؤكدة؟
وأخيرًا، ثلاثة أسئلة
- هل تتحقق من مدى تحقيق الذكاء الاصطناعي نتائج فعلية للمهمة التي تكلّفه بها، بمعزل عن شرح قدراته المُثبتة؟ Q2: من يستطيع فهم الفرق بين المستوى المتوقع والنتائج الفعلية في كل حالة استخدام، وما السجلات المستخدمة؟ Q3: قبل التعامل مع آفاق الاعتماد أو الاستثمار على أنها نتائج فعلية، كيف تميّز ما إذا كان الأساس تقديرًا أم نتيجة مؤكدة؟ - من يستطيع فهم الفرق بين المستوى المتوقع والنتائج الفعلية في كل حالة استخدام، وما السجلات المستخدمة؟ Q3: قبل التعامل مع آفاق الاعتماد أو الاستثمار على أنها نتائج فعلية، كيف تميّز ما إذا كان الأساس تقديرًا أم نتيجة مؤكدة؟ - قبل التعامل مع آفاق الاعتماد أو الاستثمار على أنها نتائج فعلية، كيف تفرّق وتحكم ما إذا كان الأساس تقديرًا أم نتيجة مؤكدة؟
📚 المصادر (جميع المواد)
كل البنود التي استند إليها هذا العدد. تُفتح الروابط الخارجية في علامة تبويب جديدة. 21 بندًا.
صناعة الذكاء الاصطناعي
الذكاء الاصطناعي والاقتصاد
الذكاء الاصطناعي والمال
الذكاء الاصطناعي والرعاية الصحية
AI, Welfare and Long-term Care
الذكاء الاصطناعي والسياسة الدولية
الذكاء الاصطناعي حول العالم
أخلاقيات الذكاء الاصطناعي
الذكاء الاصطناعي والتعليم
الذكاء الاصطناعي والفلسفة والفكر
الذكاء الاصطناعي والفنون والإبداع
الذكاء الاصطناعي في الطب (رعاية مرضى السرطان، الأمراض النادرة)
الذكاء الاصطناعي والزراعة
تنظيم الذكاء الاصطناعي وسلامته والجغرافيا السياسية
الذكاء الاصطناعي والبحوث الرائدة (الأوراق البحثية)
- تدريب وكلاء الطرفية ذوي الأفق الطويل على بيئات لا تؤدي العمل نيابةً عنهم ── نسخة أولية تقترح TerminalHorizon، التي تستخدم تنفيذًا مستقلًا لاكتشاف العمل الذي أزالته عملية توليد البيئات بصمت — وسائل إعلام يابانية
- أمر نموذج لغوي كبير بعدم التفكير لا يجعله يتوقف ── نسخة أولية تقيس «عدم التفكير» على ثلاثة مستويات وتفيد بأن الإعدادات والتعليمات وحدها لا تُطفئ الاستدلال — وسائل إعلام يابانية
- حين يبني وكلاء البرمجة وكلاءً آخرين، فما يُظهرونه ليس ما يُسلّمونه ── نسخة أولية تقترح AgentSWE، وهو معيار اختبار يقيس بناء الوكلاء عبر الإنشاء والتحرير والتحسين — وسائل إعلام يابانية