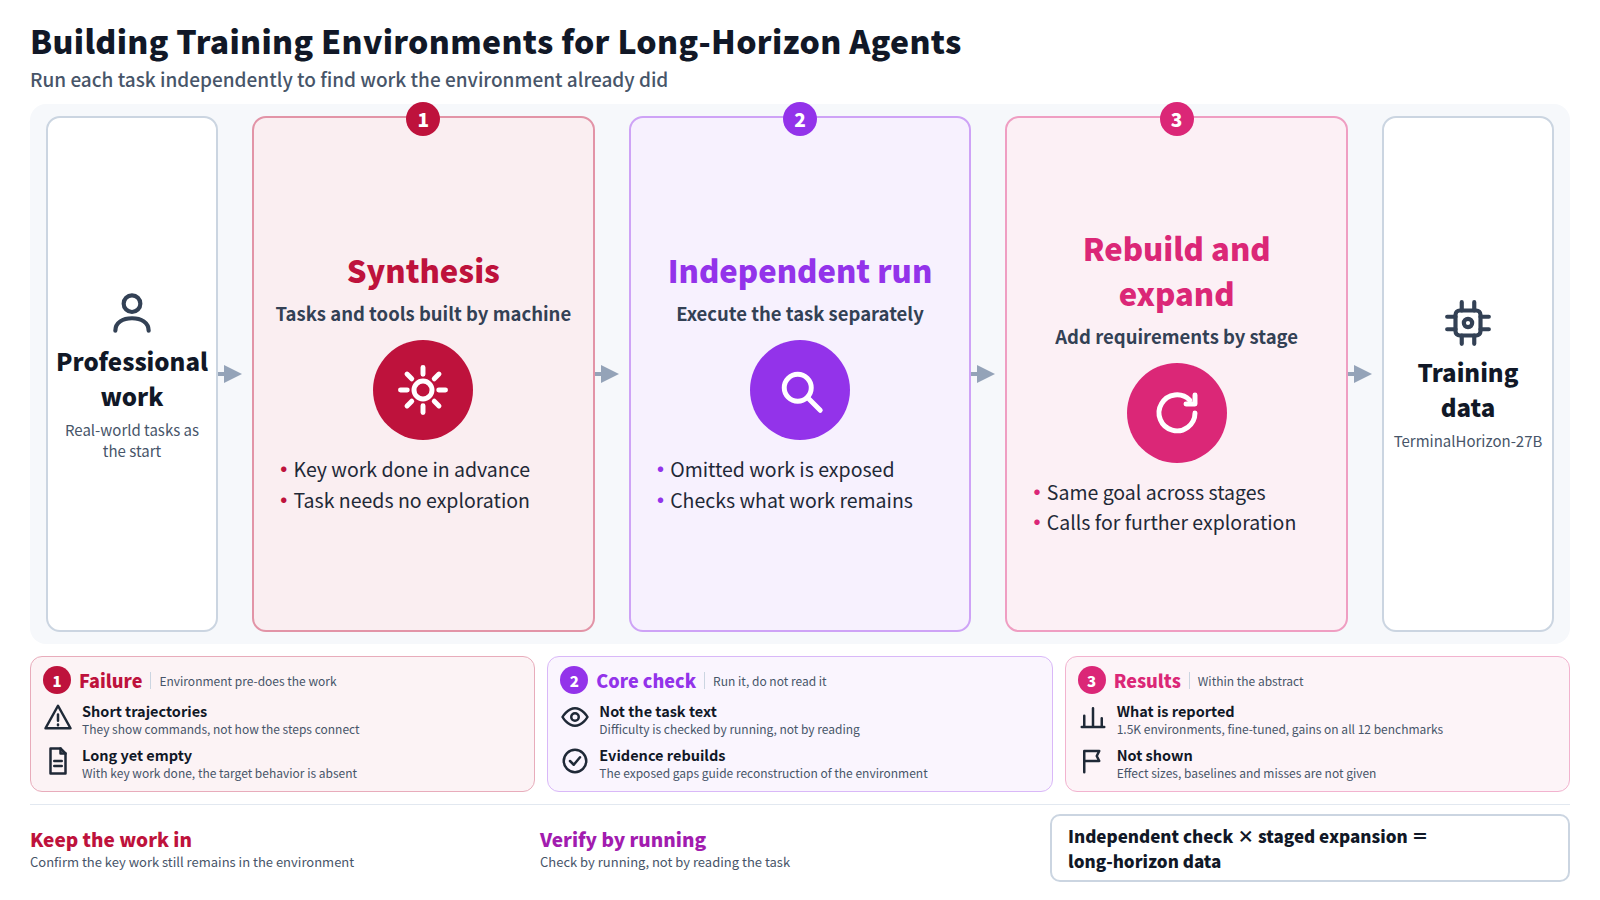
1. المسارات القصيرة لا تُظهر كيف يُنجَز العمل فعليًا
الوكيل الطرفي هو نظام ذكاء اصطناعي يعمل عبر سطر الأوامر: فهو يحرّر الملفات ويشغّل البرامج ويتحقق من النتائج بنفسه. ويصف الملخص هذه الوكلاء بأنها تتجاوز العمليات المحلية نحو إنجاز مهام مهنية حقيقية.[1]
تسليم مهمة حقيقية يتطلب أكثر من معرفة الأوامر المنفردة. فعلى الوكيل أن يستكشف ويجمع الأدلة، ويستخدمها لإصدار الأحكام، ويغيّر مساره عندما تقتضي الملاحظات ذلك، ويحوّل النتائج الوسيطة إلى شيء قابل للتسليم. ويشير المؤلفون إلى أن المسارات القصيرة يمكنها إظهار الأوامر واستدعاءات الأدوات، لكنها لا تلتقط هذه السلسلة من السلوك ولا كيفية ترابط خطواتها داخل حلقة واحدة لحل المشكلة.
ينبغي للمسارات الطويلة أن تسد هذه الفجوة. وتكمن الصعوبة في كيفية إنتاج بيئات التدريب. فعندما تُصنَّع المهمة وملفاتها وأدواتها تلقائيًا، قد تُنجز خطوة البناء العمل الأساسي مسبقًا أو تبسّطه. والنتيجة مهمة لم تعد تتطلب الاستكشاف أو التنفيذ أو التحقق. وجمع مسارات طويلة على مثل هذه المهام لا يعلّم السلوك الذي كان يُفترض أن تتضمنه هذه المسارات. وهذه هي المشكلة التي يسعى الملخص إلى معالجتها.
2. الفكرة الأساسية: شغّل المهمة لتكتشف ما فعلته البيئة بالفعل
يوصف TerminalHorizon بأنه محرك آلي بالكامل لتركيب بيانات التدريب لوكلاء الطرفية ذوي الأفق الطويل، انطلاقًا من أعمال مهنية واقعية.
تتناول هذه المقالة آلية واحدة بوصفها محور المنهج: الفحص عبر التنفيذ المستقل. يشغّل المحرّك المهمة بشكل منفصل داخل البيئة المبنية. ويكشف هذا التشغيل عن العمل الأساسي الذي أُغفل أو أُنجز مسبقًا أثناء البناء، وتوجّه الأدلة الناتجة عملية إعادة بناء البيئة. فبدلًا من تقدير الصعوبة بقراءة نص المهمة، يتحقق التصميم، عبر التشغيل الفعلي، مما إذا كان العمل الذي يُفترض أن ينجزه الوكيل لا يزال موجودًا.
الآلية الثانية هي التوسع التدريجي. ففي ظل الهدف العام نفسه، يضيف المحرك متطلبات جديدة تبني على نتائج المراحل السابقة وتستدعي مزيدًا من الاستكشاف والتحسين. ووفقًا للمؤلفين، فإن ذلك يمدّ نمط الاستكشاف والحكم والمراجعة عبر عدة مراحل من مهمة واحدة. ولا يذكر الملخص أي نموذج ينفّذ التنفيذ المستقل ولا الإجراء الذي يتبعه.
3. ما يورده الملخص
- حجم البيئات: استُخدم المحرك لبناء 1.5K بيئة مهام.
- التدريب: جرى ضبط Qwen3.5-27B بالتعلم الخاضع للإشراف على البيانات الناتجة، مما أنتج TerminalHorizon-27B.
- التقييم: يفيد المؤلفون بتحقيق مكاسب كبيرة في جميع المعايير الـ12، التي تشمل مهام وكلاء البرمجة، والمهام الوكيلية في بيئات الإنتاج الواقعية، والاستدلال العام.
- دراسات حالة: يُقال إن عدة دراسات حالة للتحسين الذاتي التكراري (RSI)، لكل منها ميزانية بحثية مدتها 12 ساعة، تُظهر أن النموذج يواصل التجريب بعد الحل الأولي، ويراجع أساليبه استناداً إلى التغذية الراجعة، ويحتفظ بالتحسينات الفعالة في المخرج النهائي. يستخدم الملخص الاختصار فقط؛ ويُفهم منه أنه التحسين الذاتي التكراري.
هناك تحفظان يجب الانتباه إليهما. عبارة "مكاسب كبيرة" هي صياغة الملخص نفسه؛ فهو لا يقدّم أحجام تأثير ولا خطوط أساس ولا أسماء معايير اختبار. إن كانت المقارنة مع النموذج نفسه قبل الضبط الدقيق أو مع نماذج مضبوطة على بيانات وكيلية أخرى، فإن ذلك يغيّر معنى النتيجة. أما بالنسبة لدراسات الحالة، فلا يوضح الملخص كيف جرى الحكم على النجاح ولا مدى تكراره.
4. مثال تطبيقي: إعادة بناء جدول ملخص من بيانات محدّثة
أين بالضبط يختفي العمل الجوهري عندما تُولَّد المهام الطويلة تلقائيًا؟ لنتأمل مهمة قريبة من الممارسة الصيدلانية. تحتوي البيئة على برنامج الملخصات الخاص بدراسة سريرية وبياناتها المصدرية. والتعليمات هي: "أعد توليد جداول الملخص من أحدث لقطة للبيانات واكتب ملاحظة تشرح ما تغيّر منذ النسخة السابقة."
بيئة أُنجز فيها العمل الأساسي بالفعل
أثناء البناء، جرت بالفعل تسوية اختلافات الصيغ في البيانات الجديدة، وتم بالفعل تعديل برنامج التلخيص ليعمل عليها. يمكن للوكيل أن ينهي المهمة بتشغيل البرنامج وتصدير الجداول. يبقى المسار قصيرًا، وحتى لو طال فلن يتضمن أي استكشاف أو تقييم أو إصلاح.
بيئة جرى التحقق منها بتنفيذ مستقل وأُعيد بناؤها
يُظهر تشغيل منفصل أن خطوة «العثور على عدم تطابق التنسيق وإصلاحه» لم تعد موجودة. فتُعاد بناء البيئة مع إبقاء عدم التطابق في مكانه. وعلى الوكيل الآن أن يفحص البيانات، ويتتبع سبب فشل البرنامج، ويصلحه، ثم ينتج الجداول فقط بعد ذلك. وتضيف مرحلة لاحقة متطلبًا جديدًا: شرح الفروق عن الإصدار السابق.
هذا مثال توضيحي لفكرة TerminalHorizon، وليس مهمة مأخوذة من الورقة البحثية؛ فالملخص لا يذكر مجالات مهامها. والفكرة أن التعليمة نفسها قد تنتج مسارات مختلفة جدًا بحسب ما إذا كانت البيئة لا تزال تتضمن العمل.
5. ما ليس جديدًا وأين تكمن الحدود
تركيب بيئات الوكلاء تلقائيًا وضبط النماذج بدقة على المسارات المجمّعة فيها خط عمل راسخ. كما يقترح ProgramGym، الذي نُشر في الأسبوع نفسه، بناء بيئات تدريب قابلة للتحقق انطلاقًا من المستودعات.[3] كما أن تغذية نتائج التنفيذ مرة أخرى في بناء البيئة أمر مألوف في الأساليب التي تشغّل الاختبارات للتحقق من جودة المهام. أما على جانب التقييم، فإن معايير مثل Terminal-Bench تقرن بالفعل كل مهمة طرفية مستمدة من سير عمل حقيقي ببيئتها الخاصة واختباراتها الآلية.[4] لا يذكر الملخص ما إذا كان Terminal-Bench ضمن المعايير الـ12 المستخدمة هنا. أما الإسهام هنا، بقدر ما يظهره الملخص، فهو تسمية نمط إخفاق محدد، وهو البيئات التي تؤدي عمل الوكيل مسبقاً، وإقران خطوة اكتشاف وإعادة بناء له بتوسيع تدريجي للمهام تحت هدف ثابت.
تظهر عدة حدود من الملخص وحده. أولاً، لم يُذكر حجم المكاسب ولا خطوط الأساس. ثانياً، من دون قائمة المعايير الاثني عشر (12 benchmarks)، لا توجد طريقة لتقدير مدى قرب مهام التقييم من مهام التدريب؛ فإذا كانت من أنواع متشابهة من العمل، فقد يعكس جزء من التحسّن هذا التداخل. ثالثاً، لا يوجد مقياس لمدى موثوقية التنفيذ المستقل في اكتشاف العمل المُغفَل، ولا لمقدار ما يفوته.
رابعًا، تُظهر دراسات الحالة قدرة معيّنة، لكنها ليست تقييمًا لمدى تكرار ظهورها. خامسًا، لا يذكر الملخص ما إذا كانت البيانات أو النموذج سيُتاحان، ولم يكن هناك مستودع GitHub مسجّل وقت جمع الورقة. لا يمكن التحقق من إعادة الإنتاج حتى الآن.
6. لماذا يتكتل هذا الموضوع: الاهتمام يتحول إلى كيفية بناء بيئات التدريب
يمنح نظام الاختيار الذي يقف وراء هذا المقال وزنًا للعناقيد: أوراق مستقلة تطرح السؤال نفسه في نافذة زمنية قصيرة. حجم هذا العنقود 2. والورقة الأخرى هي ProgramGym.[3]
تشمل الكلمات المفتاحية المشتركة: الأفق الطويل، والبيئات، والتوسّع، والتدريب. يستهدف ProgramGym الوكلاء الذين يدرسون برنامجًا مرجعيًا ثم يعيدون بناءه من الصفر، ويُنشئ بيئات تدريب قابلة للتحقق من المستودعات على نطاق واسع. تختلف المجالات، فالعمل عبر الطرفية يقابل إعادة إنتاج البرامج، لكن كليهما يجيب عن السؤال نفسه: السلوك طويل الأفق يحتاج إلى بيئات تدريب لا توجد بعدُ بعدد أو جودة كافيين. وثمة قراءة ترى أن الجهد يتحول من تغيير النموذج إلى تغيير المكان الذي يُدرَّب فيه النموذج.
حصلت الورقة على 132 تصويتًا مؤيدًا في Hugging Face Daily Papers.[2] يدل هذا الرقم على أن الورقة لفتت انتباه الباحثين. لكنه لا يدل على صحة الادعاءات ولا على أن أحداً أعاد إنتاجها. كما أن مجموعة من ورقتين صغيرة، ويعتمد ما إذا كان هذا سيصبح موضوعاً مستمراً على ما سيأتي لاحقاً.
7. ما يرتبط بالممارسة الدوائية والتنظيمية
تنفّذ المؤسسات الدوائية كثيرًا من المهام الطويلة القائمة على الطرفية: تحديث برامج الملخصات السريرية، وتجديد بيئات التحليل، وتجميع مجموعات البيانات للتقديمات التنظيمية. وتتبع كل منها المسار نفسه: التقصّي، ثم القرار، ثم الإصلاح، ثم التسليم. وإذا فُوّض مثل هذا العمل يومًا إلى وكلاء، فإن سؤال المهام التي تدرّب عليها الوكيل يستحق أن يوضع إلى جانب درجاته في الاختبارات المعيارية.
ينطبق نمط الفشل الذي تسميه هذه الورقة أيضًا على كل من يقيّم وكيلًا داخل المؤسسة. فإذا كان الشخص الذي يعدّ مهمة الاختبار هو نفسه من ينظّف البيانات مسبقًا، يمكن للوكيل أن ينجح دون أداء الجزء المهم. وقبل الاعتماد، ينبغي أن يشغّل المهمةَ شخصٌ آخر غير مؤلفها ويتأكد من أن العمل الذي تريد المؤسسة فعلًا تفويضه لا يزال حاضرًا. وهذا يتوافق مع ممارسة التحقق من صحة النظم المحوسبة القائمة على فصل من يكتبون نصوص الاختبار عمّن ينفذونها ويراجعونها.
المسألة الثانية هي وكيل يواصل التجريب على مدى فترات طويلة ويعدّل أساليبه بنفسه. وقد يفيد ذلك في البحث الاستكشافي. أما في بيئة GxP فيتطلب سجلًا يتيح للمراجع إعادة بناء متى تغيّر الشيء وماذا تغيّر ولماذا. يذكر الملخص أن النموذج يحتفظ بالتحسينات الفعّالة في مخرجاته النهائية، لكنه لا يقول شيئًا عن كيفية تسجيل العملية. وعلى المؤسسات التي تفكر في استخدام مثل هذه الوكلاء أن تحدد شكل سجل العملية قبل أن يبدأ الوكيل، لا شكل المخرجات فحسب.