1. «Это ИИ?» и «Это правда?» — разные вопросы
Значительная часть недавних работ по проверке изображений сосредоточена на одном вопросе: было ли это изображение создано генеративной моделью? Аннотация начинается с замечания, что это не отвечает на вопрос, который важен на практике. Знание того, сгенерировано ли изображение ИИ, не показывает, подтверждается ли фактами ситуация, которую оно изображает.[1]
Более трудные случаи — обычные. Настоящая фотография публикуется повторно так, будто она показывает другой день или другое место. Сцена подлинная, но приписанная ей история ложна. Бывает и наоборот: отредактированное изображение всё же может передавать нечто верное. Во многих таких случаях детектор, говорящий «настоящее» или «сгенерировано», не помогает.
Есть и вторая трудность. Большинство систем проверки фактов получают письменное утверждение, например «на этом фото показано X», и затем проверяют его. В этой работе утверждение убрано. Система получает только изображение и общую инструкцию проверить его. Она сама должна решить, что стоит проверять.
2. Основная идея: пересматривать вопрос по ходу исследования
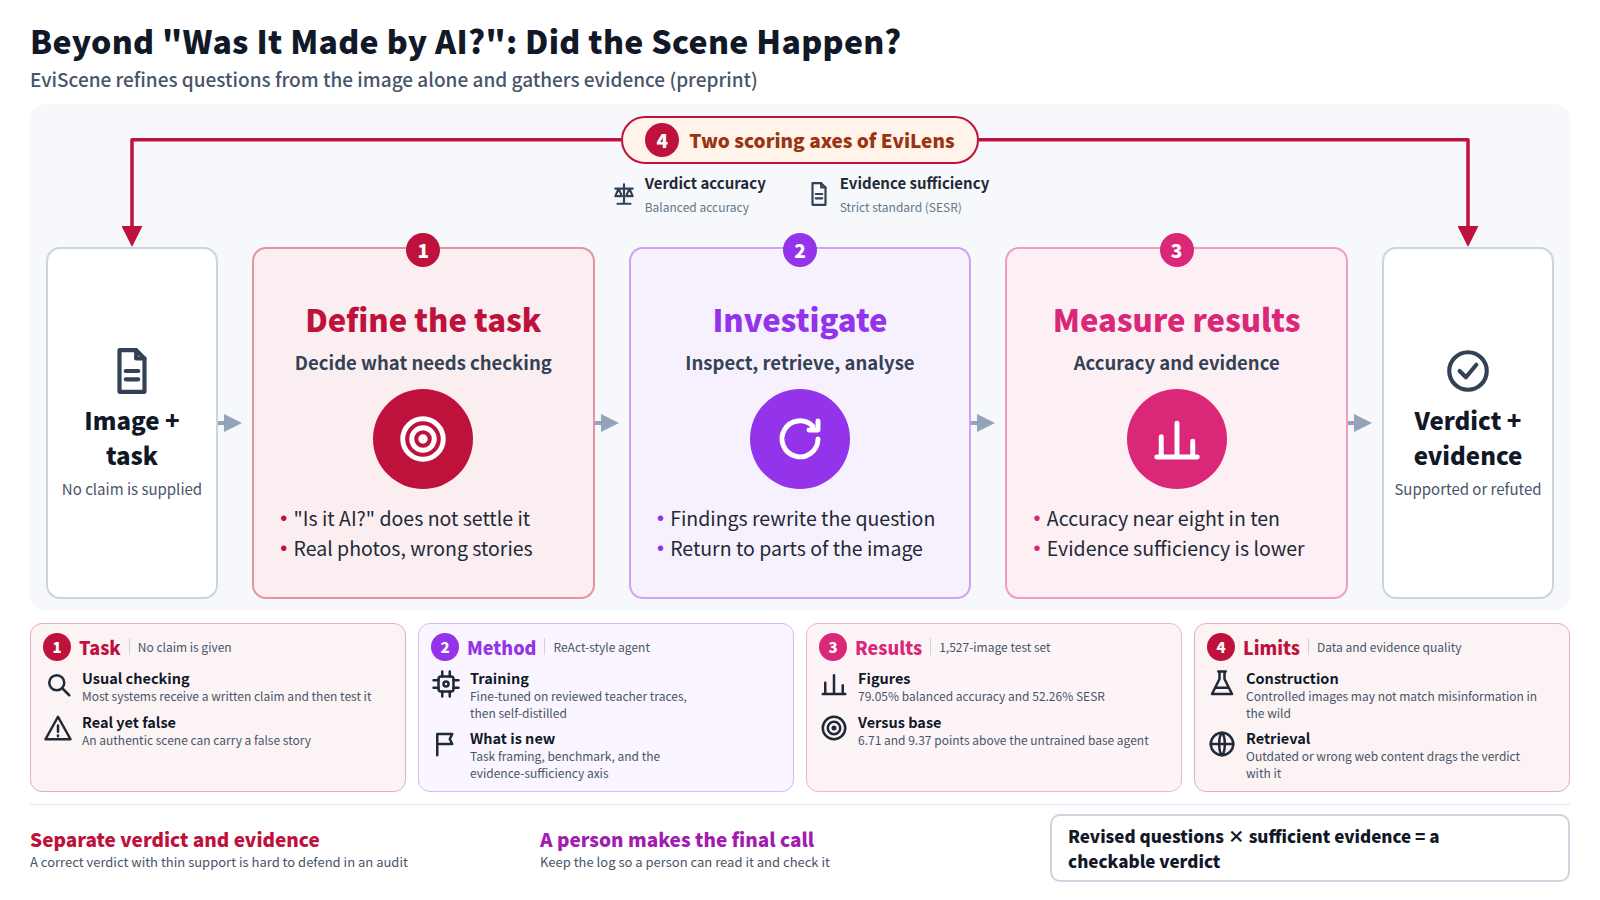
Авторы определяют задачу следующим образом. По изображению и общей инструкции по проверке система выдаёт вердикт — подтверждено или опровергнуто — вместе с объяснением, опирающимся на доказательства. Поскольку утверждение не задано, система должна по ходу расследования сужать свои фактические вопросы и сопоставлять найденные внешние свидетельства с конкретной ситуацией на изображении.
EviScene создан для этой задачи. Согласно аннотации, это мультимодальный агент в стиле ReAct, который чередует три действия: осмотр изображения, поиск внешней информации и анализ доказательств. ReAct — более ранняя платформа, в которой языковая модель чередует шаги рассуждения с такими действиями, как поиск.[4]
Этот обзор сводит метод к одному пункту: агент использует новые находки, чтобы переписывать свои вопросы и возвращаться к соответствующим частям изображения. Он не продолжает поиск с тем вопросом, с которого начал. Когда нет утверждения, к которому можно привязать поиск, утверждают авторы, именно это движение туда и обратно определяет качество вердикта.
Описан также рецепт обучения. Компактная политика сначала дообучается на трассах расследований модели-учителя, проверенных людьми. Затем она обучается с помощью привилегированной самодистилляции на собственных решениях (on-policy), принятых в ходе её же расследований и поддающихся проверке. Из чего состоит «привилегированная» информация, в аннотации не указано.
3. О чём сообщает аннотация
- Бенчмарк (EviLens): 10 174 подтверждённых и опровергнутых изображений, проверенных экспертами, полученных как в ходе контролируемого создания, так и путём сбора из интернета. Охватывает двенадцать типов фактических ошибок и оценивает как точность вердикта, так и достаточность приведённых доказательств.
- Модель: агент, обученный на базе Qwen3.5-9B.
- Результаты: на тестовом наборе из 1 527 изображений обученный агент достигает сбалансированной точности 79,05% и Strict Evidence Sufficiency Rate (SESR) 52,26%.
- Сравнение: эти показатели на 6,71 и 9,37 процентного пункта выше, чем у необученного базового агента на той же основе. Его SESR описывается как самый высокий среди оцениваемых агентов.
Одно расхождение бросается в глаза. Достаточность доказательств заметно ниже точности вердикта, а значит, верный вердикт нередко сопровождается доказательствами, которые не прошли бы строгую проверку. В аннотации не названы другие агенты, с которыми проводилось сравнение, и не указано, насколько велики были различия.
4. Пример из практики: фотография, которая ходит по компании
Рассмотрим случай, близкий к фармацевтической работе. Во внутреннем чате публикуют фото незнакомой упаковки на аптечной полке, и люди начинают спрашивать, не подделка ли это. Приведённый ниже диалог применяет подход EviScene лишь для иллюстрации; в аннотации не сказано, включала ли статья изображения такого рода.
Сотрудник: Пожалуйста, проверьте, соответствует ли это фото действительности.
Агент: (осматривает изображение) Я вижу этикетку на упаковке, ценник на полке и объявление в магазине. Первый вопрос: соответствует ли эта упаковка актуальному оригинальному дизайну.
Агент: (ищет) На сайте производителя есть уведомление об изменении упаковки, и новый дизайн совпадает с фотографией.
Агент: (пересматривает вопрос) Далее: когда и где, по утверждению, была сделана эта фотография? Я ещё раз посмотрю на текст объявления в магазине.
Агент: Вердикт: подтверждено. Официальное уведомление совпадает с упаковкой, поэтому версия о подделке не подтверждается. Место съёмки фото подтвердить не удалось.
Смысл примера в том, что первый вопрос (поддельное ли это?) и пересмотренный вопрос (когда и где это было снято?) — разные вопросы. Возврат того, что не удалось подтвердить, вместе с вердиктом отражает причину, по которой в статье достаточность доказательств оценивается отдельно от точности.
5. Что не является новым и где пределы
Часть элементов знакома. Чередование рассуждений и поиска следует линии работ ReAct. Проверка утверждений по внешним свидетельствам имеет долгую исследовательскую историю. Дистилляция трасс учителя в меньшую модель — стандартный приём. Вклад лучше рассматривать как постановку задачи (фактичность без заданного утверждения), бенчмарк и оценку, которая спрашивает, достаточно ли доказательств, а не только верен ли вердикт.
Ограничений несколько. Во-первых, способ создания EviLens. Изображения, полученные в контролируемых условиях, позволяют легко упорядочивать типы ошибок, но могут не соответствовать тому, как дезинформация распространяется в реальной среде. В аннотации не описано, насколько масштабной была экспертная проверка.
Во-вторых, качество самих доказательств. Агент опирается на поиск. Если найденный им веб-контент устарел, неверен или подложен, вердикт последует за ним. В аннотации не сказано, как были определены область поиска или дата поиска.
В-третьих, как читать эти цифры. Сбалансированная точность около восьми из десяти означает также, что агент ошибается примерно в одном случае из пяти, а достаточность доказательств ещё ниже. На таком уровне нельзя отказываться от проверки человеком, и авторы этого не утверждают.
В-четвёртых, воспроизводимость. В аннотации сказано, что код, модели и данные будут опубликованы. Это заявленный план; в рамках этого обзора не проверялось, состоялся ли релиз.
6. Почему эта тема набирает обороты именно сейчас
Конвейер отбора отнёс эту статью к кластеру «Agents and Autonomy» размером 2. Другая статья, «Beyond the Verdict», посвящена оценке и диагностике решений задач по спортивному программированию без расходования официальных посылок и рассматривает сгенерированные контрпримеры как проверяемые доказательства.[3]
Изображения и программы — очень разный материал. Две статьи объединяет отказ ограничиваться простым вердиктом «верно/неверно». Обе требуют, чтобы система предоставляла доказательства, которые может проверить третья сторона. По мере того как агентам поручают всё больше решений, вопрос смещается от того, верен ли вердикт, к тому, может ли кто-то проверить его впоследствии, и обе статьи закладывают это требование в свою оценку.
Для справки: сигналы скромные. На странице статьи на Hugging Face у работы 44 голоса «за» и 1 комментарий, а у её репозитория на GitHub 0 звёзд.[2] Апвоуты показывают, что исследователи заметили статью. Они ничего не говорят о том, верны ли её утверждения и полезна ли она на практике. Кластер из двух работ невелик, и было бы преждевременно называть это полностью сформировавшимся трендом.
7. Где это пересекается с фармацевтической и регуляторной работой
Фармацевтические компании постоянно получают изображения неясного происхождения: фотографии продуктов в социальных сетях, упаковку, которая может быть контрафактной, изображения, приложенные к запросам о нежелательных явлениях, и фотографии, предлагаемые для использования в рекламных материалах, источник которых нужно проверить. Ни один из этих случаев не решается вопросом о том, было ли изображение сгенерировано. Важно, реальна ли показанная ситуация.
Наиболее важное для практики проектное решение — разделение вердикта и достаточности его доказательной базы. В регулируемых решениях запись о том, как был получен вывод, часто важна не меньше самого вывода. Правильный вердикт с слабым обоснованием трудно защитить при аудите. Оценка достаточности доказательств по отдельной оси даёт способ думать о критериях приёмки при добавлении ИИ в работу по верификации.
Даже в этом случае такой агент остался бы на уровне первичной сортировки и черновика журнала расследования. Поскольку он зависит от того, что поиск возвращает в данный момент, его вердикты привязаны к этому моменту. Журнал следует сохранять, окончательное решение должно оставаться за человеком, и этот человек должен иметь возможность прочитать журнал и проверить его. Из препринта на этом этапе стоит взять не столько конкретный показатель эффективности, сколько привычку проектирования — записывать вердикт и доказательства отдельно.