1. 论文要解决什么问题?
医学领域关于大语言模型(LLMs)的研究大多围绕准确性发问。模型能否说出诊断、通过考试、胜过医生?然而,当AI建议在临床中被付诸行动时,最先发生变化的是检查医嘱、转诊和处方。而其中每一项都伴随着成本。
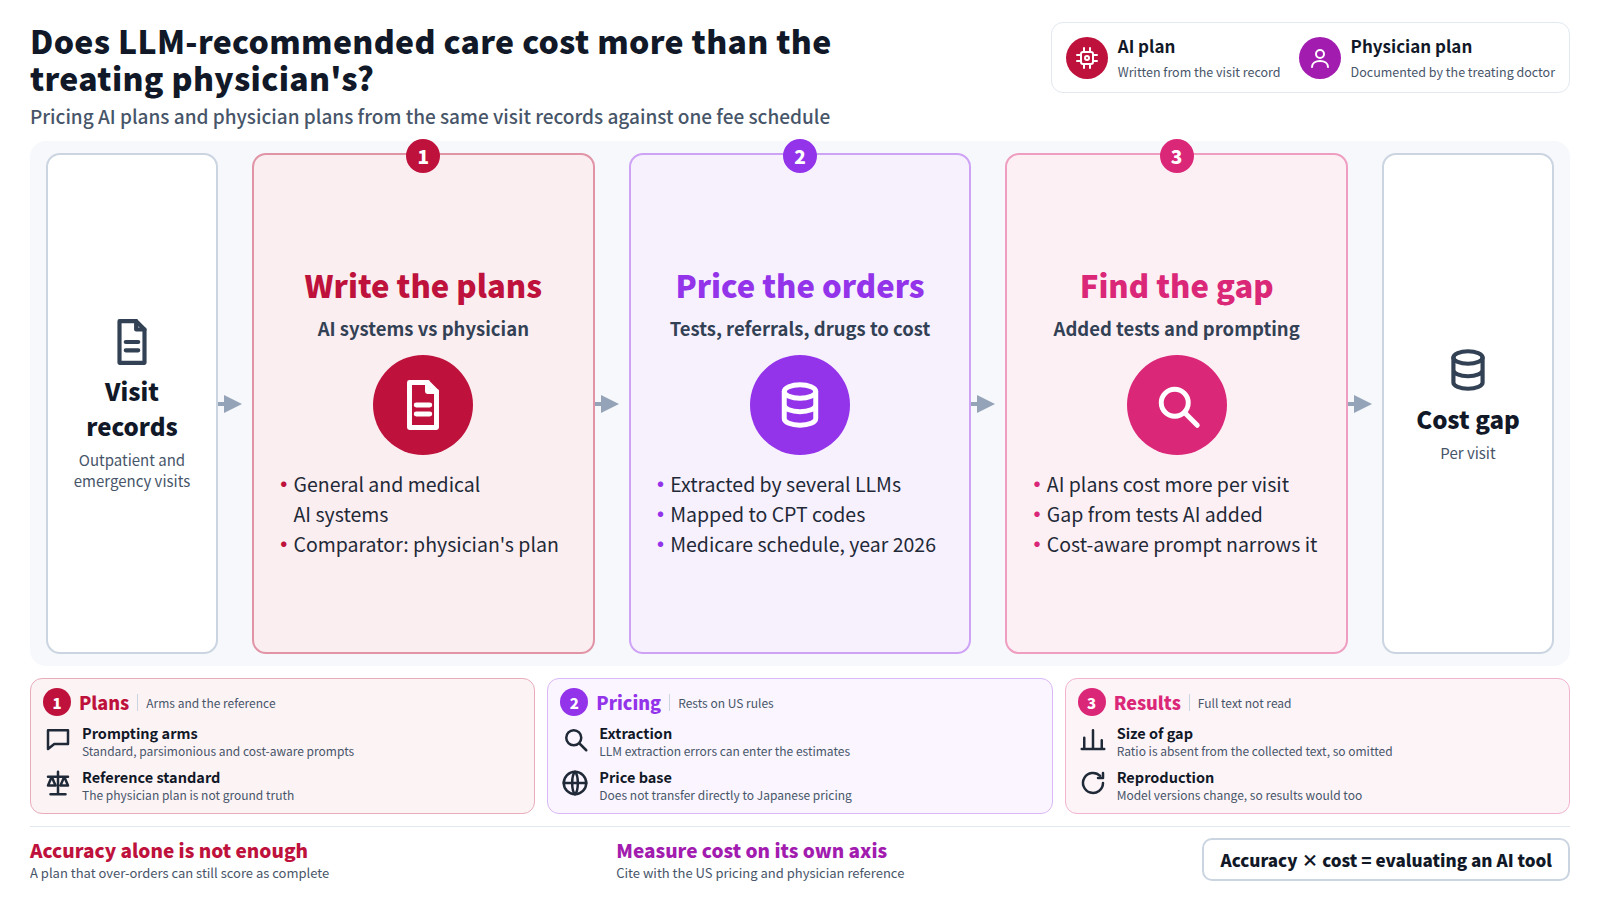
这篇经同行评审后发表于 NEJM AI 的原创论文将问题从准确性转向了成本。面对同一份就诊记录,由 LLM 撰写的诊疗方案与实际接诊医生所写方案的费用是否会有所不同?如果是,是什么造成了差异,而提示模型的方式又是否会改变它[1]?
一个准确率得分很高的 AI,如果倾向于“以防万一”而堆砌检查,仍可能推高支出和患者负担。而过度压缩成本又会造成遗漏。准确率与成本必须在不同的轴上分别衡量;这正是这篇论文的出发点。
2. 它提出了什么?
该方法的核心是按照同一收费标准对AI方案和医生方案进行定价。根据作者对其数据和分析代码的公开描述,就诊信息取自门诊和急诊就诊记录,并要求一组AI系统(既包括通用大语言模型,也包括专业医疗系统)撰写评估与方案。对照对象是主治医生记录在案的方案[3][4].
每个方案中的检查、转诊和用药由多个独立的LLM提取,并映射到美国操作代码(CPT)。随后,医嘱按2026历年的Medicare医师费用表(Medicare Physician Fee Schedule)定价,药品则参照美国全国药品价格调查定价。除标准提示外,还运行了两种提示方案:一种要求给出精简方案,另一种要求模型具备成本意识[4].
因此,这项研究并未赋予AI新的能力。它只是用健康经济学的标尺对AI现有的输出进行了重新测量。
3. 在可核查的范围内,它表明了什么?
首先要说明一点。在本站收集的书目记录中,摘要字段仅包含一行"NEJM AI, Ahead of Print."。截至撰写时,NEJM AI 的文章页面无法访问,全文尚未阅读。以下内容依据的是作者团队发布在其自身出版物页面上的摘要[2].
根据该摘要, AI 系统推荐的诊疗每次就诊的费用高于主治医生推荐的诊疗。大部分差距来自 AI 在医生原本未安排任何检查的就诊中新增的检查。作者写道, 具备成本意识的提示缩小了差距, 但从未完全消除差距。
该摘要还给出了差距大小的一个比值。本文不刊登其所收集的一手文本中未出现的数字,因此此处省去了该比值。想了解差距量级的读者应直接查阅 NEJM AI 论文和作者的摘要。
该公开代码库还列出了对医生适当性评级、AI与医生之间的诊断一致性以及重测信度的分析[4]. 论文中如何报告这些结果,无法在本篇文章范围内得到确认。
4. 具体示例
以某制药公司的医学事务团队为例,他们正在权衡一款面向医疗专业人员的AI支持工具。
内部评审会议
开发者: "在评估病例中,与主治医生的诊断一致率大致相同。这些方案没有遗漏任何项目。"
卫生经济学负责人: "你数过那些方案里的检查项目吗?在医生选择观察等待的就诊中,AI 是否在增加验血和影像检查?"
开发者: "以备万一的检查似乎确实很多。但这样更保险。"
卫生经济学负责人: "是否安全取决于这些检查是否改变了治疗决策。它们会增加费用和患者负担,因此除非我们在准确性之外对此加以衡量,否则就不算评估了这个工具。"
该论文引入了第二位发言者的观点。在准确性比较中,一个过度订购的方案仍能凭“完整”获得高分。若把各方案按成本排成一列,这种偏差便一目了然。
5. 哪些并非新内容,局限又在哪里?
将大语言模型(LLM)与医生进行比较的研究已有很多:诊断准确性、考试题、影像判读。这种比较框架本身并不新鲜。这里的新颖之处在于衡量标准。其构成要素,即从病历中提取信息、编码映射以及对照收费表定价,都是卫生经济学研究中的标准做法。从现有材料中便可看出若干局限。
- 医生的方案并非真值。 参照标准是主治医生的实际做法,而医生不开任何检查未必就是对的。AI 增加的某些检查可能恰好弥补了医生遗漏之处。仅凭费用差异并不能说明哪个方案对患者更好。
- 定价取决于美国体系。 由于使用了 Medicare 收费标准和美国药品价格数据,研究结果无法直接套用于日本的医保报销或药品价格。差距的方向或许有参考价值,其大小则取决于医疗体制。
- 该就诊记录是文本。 AI 阅读病历记录并撰写方案;医生则接诊患者,权衡其意愿和保险情况。很难说双方掌握着相同的信息。该代码库包含一个公开医疗转录语料库的快照,但这些病例的确切来源在此无法确认。
- 转载受到限制。 该代码库本身提示,模型版本和 API 可用性会发生变化,重新运行查询将得不到相同的结果。已保存的输出反映的是 2026 年春季观察到的模型行为[4].
- 提取工作也由LLM完成。 从方案中提取检查和药物依赖 LLM,因此提取误差可能传导到费用估算中。使用多个模型旨在控制这一风险,但误差水平在此无法确认。
6. 这篇论文是如何被报道的?
本网站的筛选步骤将该论文选为已通过同行评审并被多家独立媒体报道的论文。所列媒体为Nature、Science、Frontiers、Neurology Today和medRxiv,共五家。然而,把这些标题逐一排列对照便会发现,其中没有一篇是关于这篇论文的。
- 《自然》:“多模态大语言模型挑战《新英格兰医学杂志》图像挑战”(图像问题准确率)
- Science: "大型语言模型在医生推理任务上的表现"(医生推理任务)
- 《今日神经病学》:“大语言模型在诊断编码准确性上击败医生”(编码准确性)
- medRxiv:“多模态大语言模型通过专科医师资格考试…”(考试成绩)
- Frontiers:《复杂心脏手术中大语言模型的盲法两阶段评估…》(心脏手术中的任务表现)
这五项都是各自独立的研究,只是标题恰好把大语言模型(LLM)与医生搭配在一起。筛选步骤是依据共有的词汇将它们匹配起来的;它们并不能证明这篇论文曾被报道过。就这篇论文而言,所声称的“独立报道”这一筛选理由并不成立。
这种错位仍然具有信息量。每一条被捕捉到的标题都落在“AI是否比医生更准确?”这个问题上,而本文则置身于该问题之外:准确性相同并不意味着成本相同。在媒体注意力聚焦于准确性之际,一把成本标尺得以登上同行评审期刊,这一点值得记录。无论是发表于同行评审期刊,还是被本站选中,都不能保证结果是正确的、具有临床价值的或新颖的。
7. 这与制药和监管工作有何关联?
首先是AI支持工具的评估标准。如果系统向医疗专业人员呈现诊疗选项,评估不仅应涵盖准确性,还应涵盖这些建议在多大程度上增加了检查、转诊和处方。该研究的设计为此提供了一个模板。
其次,提示词会左右结果。在作者的总结中,注重成本的指令缩小了差距。因此,系统提示词是产品规格的一部分,应纳入变更控制与记录保存。如果一条指令就能改变建议的模式,那么除非记录下所用的提示词,否则评估无法复现。
第三,卫生经济学评估。随着 AI 参与越来越多的推荐,药物和检查的使用方式本身可能发生变化。成本效益研究和上市后使用情况研究可能需要一种方法来捕捉 AI 推荐的参与程度。
以上内容均不意味着这些结果可按现状应用于日本的制度。引用该研究时,值得说明的是:其定价依据的是美国规则,且参考标准为主治医生的判断。