1. "Apakah ini AI?" dan "Apakah ini benar?" adalah pertanyaan yang berbeda
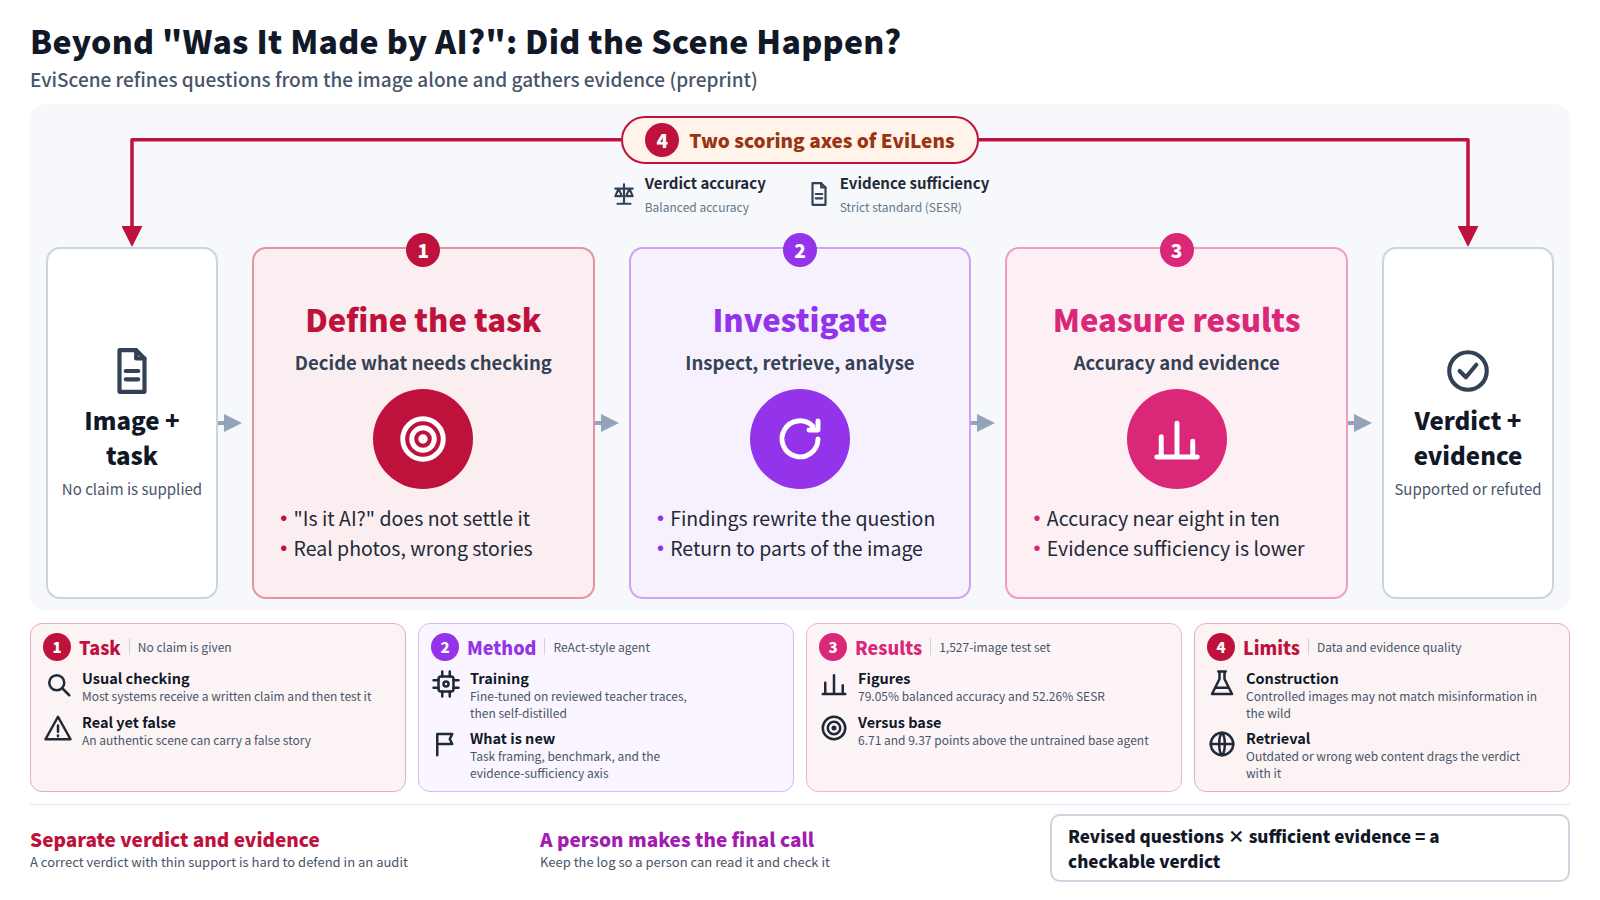
Sebagian besar riset terbaru tentang verifikasi gambar berfokus pada satu pertanyaan: apakah gambar ini dihasilkan oleh model generatif? Abstrak dibuka dengan menunjukkan bahwa hal ini tidak menjawab pertanyaan yang penting dalam praktik. Mengetahui apakah sebuah gambar dihasilkan AI tidak menentukan apakah situasi yang digambarkannya didukung oleh fakta.[1]
Kasus yang lebih sulit justru yang biasa saja. Foto asli diunggah ulang seolah-olah menunjukkan hari atau tempat yang berbeda. Adegannya asli, tetapi cerita yang menyertainya palsu. Kebalikannya juga terjadi: gambar yang telah disunting masih bisa menyampaikan sesuatu yang akurat. Dalam banyak kasus seperti ini, pendeteksi yang menyatakan "asli" atau "buatan" tidak membantu.
Ada kesulitan kedua. Sebagian besar sistem pemeriksaan fakta menerima klaim tertulis, seperti "foto ini menunjukkan X," lalu mengujinya. Makalah ini menghilangkan klaim tersebut. Sistem hanya mendapatkan gambar dan instruksi umum untuk memverifikasinya. Sistem harus memutuskan sendiri apa yang layak diperiksa.
2. Gagasan inti: merevisi pertanyaan sambil menyelidiki
Para penulis mendefinisikan tugas tersebut sebagai berikut. Dengan diberikan sebuah gambar dan instruksi verifikasi umum, sistem mengembalikan putusan, yaitu didukung atau dibantah, beserta penjelasan yang berlandaskan bukti. Karena tidak ada klaim yang diberikan, sistem harus mempersempit pertanyaan faktualnya seiring berjalannya penyelidikan dan mencocokkan bukti luar yang ditemukannya dengan situasi spesifik dalam gambar.
EviScene dibuat untuk tugas ini. Menurut abstraknya, ini adalah agen multimodal bergaya ReAct yang bergantian menjalankan tiga tindakan: memeriksa gambar, mencari informasi dari luar, dan menganalisis bukti. ReAct adalah kerangka kerja sebelumnya di mana model bahasa menyelingi langkah penalaran dengan tindakan seperti pencarian.[4]
Tinjauan ini mempersempit metode menjadi satu hal: agen menggunakan temuan baru untuk menulis ulang pertanyaannya dan kembali ke bagian gambar yang relevan. Agen tidak terus mencari dengan pertanyaan awal yang digunakannya. Ketika tidak ada klaim yang dapat dijadikan jangkar pencarian, menurut para penulis, proses bolak-balik inilah yang menentukan kualitas putusan.
Resep pelatihannya juga dijelaskan. Sebuah kebijakan (policy) ringkas pertama-tama di-fine-tune pada jejak investigasi dari model guru yang telah ditinjau oleh manusia. Kemudian model itu dilatih dengan self-distillation on-policy berprivilese pada keputusan dari investigasinya sendiri yang dapat diverifikasi. Isi dari informasi "berprivilese" tersebut tidak disebutkan dalam abstrak.
3. Apa yang dilaporkan abstrak
- Tolok ukur (EviLens): 10.174 gambar yang didukung dan dibantah, ditinjau oleh pakar, bersumber dari konstruksi terkendali maupun pengumpulan dari web. Dataset ini mencakup dua belas jenis kesalahan faktual dan menilai baik akurasi putusan maupun apakah bukti yang dikutip memadai.
- Model: sebuah agen yang dilatih dengan tulang punggung Qwen3.5-9B.
- Hasil: pada set uji 1.527 gambar, agen yang dilatih mencapai akurasi seimbang 79,05% dan Strict Evidence Sufficiency Rate (SESR) sebesar 52,26%.
- Perbandingan: angka-angka ini 6,71 dan 9,37 poin persentase lebih tinggi daripada agen dasar yang tidak dilatih pada backbone yang sama. SESR-nya digambarkan sebagai yang tertinggi di antara agen yang dievaluasi.
Satu kesenjangan menonjol. Kecukupan bukti jauh lebih rendah daripada akurasi putusan, artinya putusan yang benar sering disertai bukti yang tidak akan lolos tinjauan ketat. Abstrak tidak menyebutkan agen lain yang menjadi pembanding maupun seberapa besar perbedaannya.
4. Contoh kasus: foto yang beredar di dalam sebuah perusahaan
Pertimbangkan kasus yang dekat dengan dunia farmasi. Sebuah foto diunggah di obrolan internal yang menunjukkan kemasan tak dikenal di rak apotek, dan orang-orang mulai bertanya apakah itu barang palsu. Pertukaran di bawah ini menerapkan pendekatan EviScene hanya sebagai ilustrasi; abstraknya tidak menyebutkan apakah makalah tersebut menyertakan gambar semacam ini.
Anggota staf: Tolong periksa apakah foto ini faktual.
Agen: (memeriksa gambar) Saya bisa melihat label kemasan, label harga di rak, dan pengumuman di toko. Pertanyaan pertama saya adalah apakah kemasan ini sesuai dengan desain asli yang berlaku saat ini.
Agen: (mencari) Situs produsen memuat pengumuman tentang perubahan kemasan, dan desain barunya sesuai dengan foto tersebut.
Agen: (merevisi pertanyaan) Selanjutnya: kapan dan di mana foto ini diklaim diambil? Saya akan memeriksa lagi teks pada pengumuman toko.
Agen: Putusan: didukung. Pemberitahuan resmi sesuai dengan kemasannya, sehingga cerita pemalsuan tidak didukung. Saya tidak dapat memastikan di mana foto tersebut diambil.
Inti dari contoh ini adalah bahwa pertanyaan pertama (apakah ini palsu?) dan pertanyaan yang direvisi (kapan dan di mana ini diambil?) adalah dua hal yang berbeda. Menampilkan apa yang tidak dapat dikonfirmasi bersama dengan putusannya mencerminkan alasan makalah tersebut menilai kecukupan bukti secara terpisah dari akurasi.
5. Apa yang bukan hal baru, dan di mana batasnya
Sebagian bagiannya sudah familier. Menyisipkan penalaran di antara pencarian mengikuti rangkaian riset ReAct. Memeriksa klaim terhadap bukti dari luar memiliki sejarah riset yang panjang. Mendistilasi jejak seorang guru ke model yang lebih kecil adalah teknik standar. Kontribusinya lebih tepat dibaca sebagai pembingkaian tugas (faktualitas tanpa klaim yang diberikan), tolok ukurnya, dan evaluasi yang menanyakan apakah buktinya cukup, bukan hanya apakah putusannya benar.
Keterbatasannya ada beberapa. Pertama, cara EviLens dibangun. Gambar yang dihasilkan dalam konstruksi terkendali membuat jenis kesalahan mudah diorganisasi, tetapi mungkin tidak sesuai dengan cara misinformasi disebarkan di dunia nyata. Abstrak tidak menjelaskan seberapa luas tinjauan pakar tersebut.
Kedua, kualitas bukti itu sendiri. Agen ini bergantung pada pencarian. Jika konten web yang ditemukannya sudah usang, salah, atau sengaja ditanam, putusannya akan mengikutinya. Abstraknya tidak menjelaskan bagaimana cakupan pencarian atau tanggal pencarian ditetapkan.
Ketiga, soal cara membaca angkanya. Akurasi seimbang yang mendekati delapan dari sepuluh juga berarti agen itu keliru sekitar satu dari lima kasus, dan kecukupan bukti masih lebih rendah lagi. Ini bukan tingkat yang memungkinkan peninjauan oleh manusia ditiadakan, dan para penulis tidak mengklaim demikian.
Keempat, reproduktibilitas. Abstrak menyatakan kode, model, dan data akan dirilis. Itu baru rencana yang dinyatakan; tinjauan ini belum memeriksa apakah rilisnya sudah terjadi.
6. Mengapa topik ini mengelompok sekarang
Alur seleksi mengelompokkan makalah ini ke dalam klaster "Agents and Autonomy" yang beranggotakan 2. Makalah lainnya, "Beyond the Verdict," mempelajari penilaian dan diagnosis solusi pemrograman kompetitif tanpa menggunakan pengiriman resmi, dan memperlakukan contoh tandingan yang dihasilkan sebagai bukti yang dapat diperiksa.[3]
Gambar dan program adalah materi yang sangat berbeda. Yang sama-sama dimiliki kedua makalah ini adalah penolakan untuk berhenti pada vonis benar-salah semata. Keduanya meminta sistem menghasilkan bukti yang dapat diperiksa pihak ketiga. Seiring agen diberi lebih banyak keputusan, pertanyaannya bergeser dari apakah suatu vonis benar menjadi apakah seseorang dapat mengauditnya setelahnya, dan kedua makalah menanamkan persyaratan itu ke dalam evaluasinya.
Sebagai catatan, sinyalnya tergolong sederhana. Di halaman makalah Hugging Face, karya ini memiliki 44 upvote dan 1 komentar, dan repositori GitHub-nya memiliki 0 bintang.[2] Upvote menunjukkan bahwa para peneliti memperhatikan makalah tersebut. Upvote tidak menunjukkan apakah klaimnya benar atau apakah makalah itu berguna dalam praktik. Klaster yang terdiri dari dua makalah itu kecil, dan terlalu dini untuk menyebutnya tren yang sudah terbentuk sepenuhnya.
7. Titik temu dengan pekerjaan farmasi dan regulasi
Perusahaan farmasi terus-menerus menerima gambar yang asal-usulnya tidak jelas: foto produk di media sosial, kemasan yang mungkin palsu, gambar yang dilampirkan pada pertanyaan tentang kejadian tidak diinginkan, dan foto yang diusulkan untuk materi promosi yang sumbernya perlu diperiksa. Tidak satu pun dari ini diselesaikan dengan menanyakan apakah gambar tersebut dihasilkan oleh AI. Yang penting adalah apakah situasi yang digambarkan itu nyata.
Pilihan desain yang paling relevan dalam praktik adalah pemisahan antara putusan dan kecukupan buktinya. Dalam keputusan yang diatur regulasi, catatan tentang bagaimana suatu kesimpulan dicapai sering kali sama pentingnya dengan kesimpulan itu sendiri. Putusan yang benar tetapi dengan dukungan tipis sulit dipertahankan dalam audit. Menilai kecukupan bukti pada sumbu tersendiri memberi cara berpikir tentang kriteria penerimaan ketika AI ditambahkan ke pekerjaan verifikasi.
Meskipun demikian, agen seperti ini hanya akan berada pada tingkat triase tahap awal dan draf log investigasi. Karena bergantung pada apa yang dikembalikan oleh pencarian pada suatu saat tertentu, putusannya terikat pada saat itu. Log sebaiknya disimpan, keputusan akhir tetap berada di tangan manusia, dan orang tersebut harus dapat membaca log itu serta memeriksanya. Yang dapat diambil dari preprint pada tahap ini bukanlah angka kinerja yang spesifik, melainkan kebiasaan desain untuk mencatat putusan dan bukti secara terpisah.