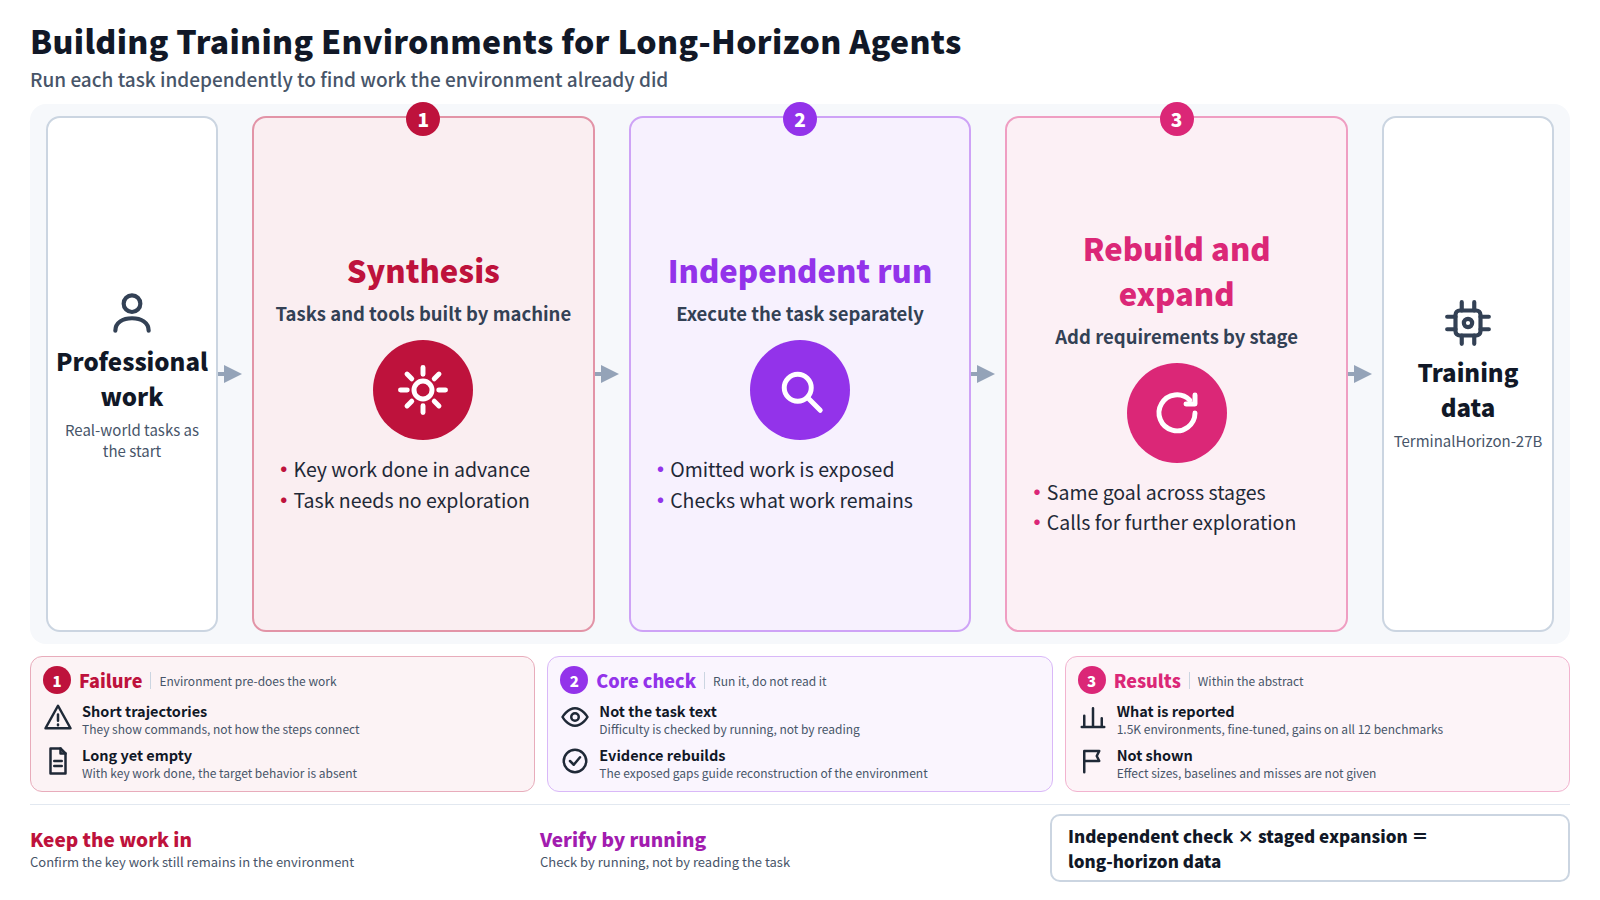
1. छोटे ट्रैजेक्टरी यह नहीं दिखाते कि काम वास्तव में कैसे होता है
टर्मिनल एजेंट एक AI सिस्टम है जो कमांड लाइन के ज़रिए काम करता है: यह फ़ाइलें संपादित करता है, प्रोग्राम चलाता है और नतीजों की जाँच खुद करता है। एब्सट्रैक्ट इन एजेंटों का वर्णन ऐसे करता है कि वे स्थानीय संचालन से आगे बढ़कर वास्तविक पेशेवर कार्यों को पूरा करने की ओर बढ़ रहे हैं।[1]
किसी वास्तविक कार्य को सौंपने के लिए अलग-अलग कमांड जानने से अधिक की आवश्यकता होती है। एजेंट को खोजबीन कर साक्ष्य जुटाने होते हैं, उन साक्ष्यों के आधार पर निर्णय लेने होते हैं, फीडबैक के अनुसार रास्ता बदलना होता है, और मध्यवर्ती परिणामों को ऐसे रूप में ढालना होता है जिसे सौंपा जा सके। लेखकों का कहना है कि छोटे ट्रैजेक्टरी कमांड और टूल कॉल दिखा सकते हैं, लेकिन वे व्यवहार की इस श्रृंखला को, या एक ही समस्या-समाधान प्रसंग में इसके चरणों के आपसी संबंध को, नहीं पकड़ पाते।
लंबी ट्रैजेक्टरी को इस कमी को भरना चाहिए। कठिनाई यह है कि अभ्यास के वातावरण कैसे तैयार किए जाते हैं। जब कोई कार्य, उसकी फ़ाइलें और उसके टूल स्वचालित रूप से संश्लेषित किए जाते हैं, तो निर्माण चरण मुख्य काम को पहले ही पूरा या सरल कर सकता है। नतीजतन ऐसा कार्य बनता है जिसमें अब खोज, क्रियान्वयन या सत्यापन की ज़रूरत नहीं रहती। ऐसे कार्यों पर लंबी ट्रैजेक्टरी इकट्ठा करने से वह व्यवहार नहीं सिखाया जाता जो उन ट्रैजेक्टरी में होना चाहिए था। यही वह समस्या है जिसे सार (एब्सट्रैक्ट) हल करने का लक्ष्य रखता है।
2. मूल विचार: यह जानने के लिए कार्य चलाएँ कि परिवेश ने पहले से क्या किया है
TerminalHorizon को लंबी अवधि के टर्मिनल एजेंटों के लिए प्रशिक्षण डेटा संश्लेषित करने वाला पूरी तरह स्वचालित इंजन बताया गया है, जो वास्तविक दुनिया के पेशेवर कार्य से शुरू होता है।
यह लेख एक तंत्र को पद्धति के केंद्र में रखता है: स्वतंत्र निष्पादन द्वारा निरीक्षण। इंजन बनाए गए परिवेश के भीतर कार्य को अलग से चलाता है। उस रन से वह मुख्य काम सामने आ जाता है जो निर्माण के दौरान छूट गया था या पहले ही पूरा कर दिया गया था, और इससे मिले प्रमाण परिवेश के पुनर्निर्माण का मार्गदर्शन करते हैं। कार्य-विवरण पढ़कर कठिनाई का अनुमान लगाने के बजाय, यह डिज़ाइन वास्तव में चलाकर जाँचता है कि एजेंट को जो काम करना है, वह अब भी मौजूद है या नहीं।
दूसरी प्रणाली प्रगतिशील विस्तार है। उसी समग्र लक्ष्य के अंतर्गत इंजन नई आवश्यकताएँ जोड़ता है, जो पहले के चरणों के परिणामों पर आधारित होती हैं और आगे की खोज और सुधार की माँग करती हैं। लेखकों के अनुसार, यह explore-judge-revise पैटर्न को एक ही कार्य के कई चरणों तक फैला देता है। सार यह नहीं बताता कि स्वतंत्र निष्पादन कौन-सा मॉडल करता है या वह किस प्रक्रिया का पालन करता है।
3. एब्स्ट्रैक्ट क्या बताता है
- परिवेशों का पैमाना: इस इंजन का उपयोग 1.5K कार्य परिवेश बनाने के लिए किया गया।
- प्रशिक्षण: Qwen3.5-27B को परिणामी डेटा पर सुपरवाइज़्ड लर्निंग से फ़ाइन-ट्यून किया गया, जिससे TerminalHorizon-27B बना.
- मूल्यांकन: लेखकों ने सभी 12 बेंचमार्क पर उल्लेखनीय सुधार की जानकारी दी है, जिनमें कोडिंग-एजेंट कार्य, वास्तविक उत्पादन परिवेश में एजेंटिक कार्य और सामान्य तर्क शामिल हैं।
- केस स्टडी: कई RSI केस स्टडी, जिनमें से प्रत्येक का शोध बजट 12 घंटे का था, बताते हैं कि मॉडल प्रारंभिक समाधान के बाद भी प्रयोग करता रहा, फ़ीडबैक से अपनी विधियाँ संशोधित करता रहा, और प्रभावी सुधारों को अंतिम परिणाम में बनाए रखा। एब्स्ट्रैक्ट केवल संक्षिप्त रूप का उपयोग करता है; इसे पुनरावर्ती स्व-सुधार (recursive self-improvement) के रूप में पढ़ा जाता है.
दो सावधानियाँ लागू होती हैं। "पर्याप्त सुधार" एब्स्ट्रैक्ट की अपनी शब्दावली है; इसमें न प्रभाव के आकार दिए गए हैं, न आधार रेखाएँ और न बेंचमार्क के नाम। तुलना फ़ाइन-ट्यूनिंग से पहले के उसी मॉडल से की गई है या अन्य एजेंटिक डेटा पर फ़ाइन-ट्यून किए गए मॉडलों से, इससे परिणाम का अर्थ बदल जाता है। केस स्टडी के बारे में एब्स्ट्रैक्ट यह नहीं बताता कि सफलता का मूल्यांकन कैसे किया गया या वह कितनी बार मिली।
4. एक उदाहरण: अद्यतन डेटा से सारांश तालिका को फिर से बनाना
जब लंबे कार्य स्वचालित रूप से तैयार किए जाते हैं, तो महत्वपूर्ण काम ठीक-ठीक कहाँ गायब हो जाता है? फ़ार्मास्यूटिकल व्यवहार के करीब का एक कार्य लीजिए। परिवेश में एक क्लिनिकल अध्ययन का सारांश प्रोग्राम और उसका स्रोत डेटा मौजूद है। निर्देश है: "नवीनतम डेटा कट से सारांश तालिकाएँ दोबारा बनाइए और एक नोट लिखिए जिसमें बताया गया हो कि पिछले संस्करण के बाद क्या बदला है।"
मुख्य कार्य पहले से पूरा किया हुआ परिवेश
निर्माण के दौरान, नए डेटा में प्रारूप के अंतर पहले ही सुलझा लिए गए थे और सारांश प्रोग्राम को उस पर चलने के लिए पहले ही पैच कर दिया गया था। एजेंट प्रोग्राम चलाकर और तालिकाएँ निर्यात करके काम पूरा कर सकता है। ट्रैजेक्टरी छोटी रहती है, और लंबी चलती भी तो उसमें कोई खोजबीन, निर्णय या सुधार नहीं होता।
स्वतंत्र निष्पादन द्वारा जाँचा गया और पुनर्निर्मित किया गया परिवेश
एक अलग रन से पता चलता है कि "फ़ॉर्मैट की असंगति खोजकर ठीक करें" वाला चरण अब मौजूद नहीं है। वातावरण को असंगति को जस का तस रखकर फिर से बनाया गया है। अब एजेंट को डेटा का निरीक्षण करना होगा, यह पता लगाना होगा कि प्रोग्राम क्यों विफल होता है, उसे ठीक करना होगा और उसके बाद ही तालिकाएँ तैयार करनी होंगी। एक बाद के चरण में नई आवश्यकता जोड़ी गई है: पिछले संस्करण से अंतर समझाना।
यह TerminalHorizon विचार का एक उदाहरण है, शोध-पत्र से लिया गया कार्य नहीं; सार में इसके कार्य-क्षेत्रों की सूची नहीं दी गई है। मुद्दा यह है कि एक ही निर्देश बहुत अलग प्रक्षेप-पथ दे सकता है, यह इस पर निर्भर करता है कि परिवेश में अब भी वह काम मौजूद है या नहीं।
5. क्या नया नहीं है, और सीमाएँ कहाँ हैं
एजेंट वातावरण को स्वचालित रूप से संश्लेषित करना और उनमें एकत्र किए गए प्रक्षेप-पथों पर फ़ाइन-ट्यूनिंग करना एक स्थापित कार्य-धारा है। उसी सप्ताह प्रकाशित ProgramGym भी रिपॉजिटरी से सत्यापन-योग्य प्रशिक्षण वातावरण बनाने का प्रस्ताव रखता है।[3] निष्पादन परिणामों को वापस परिवेश निर्माण में डालना उन विधियों से भी परिचित है जो कार्य की गुणवत्ता जाँचने के लिए परीक्षण चलाती हैं। मूल्यांकन के पक्ष में, Terminal-Bench जैसे बेंचमार्क पहले से ही वास्तविक वर्कफ़्लो से लिए गए प्रत्येक टर्मिनल कार्य को उसके अपने परिवेश और स्वचालित परीक्षणों के साथ जोड़ते हैं.[4] एब्स्ट्रैक्ट यह नहीं बताता कि Terminal-Bench यहाँ प्रयुक्त 12 बेंचमार्क में शामिल है या नहीं। एब्स्ट्रैक्ट जितना दिखाता है, यहाँ योगदान एक विशिष्ट विफलता-प्रकार को नाम देना है, यानी ऐसे परिवेश जो एजेंट का काम पहले ही कर देते हैं, और उसके लिए पहचानने-और-पुनर्निर्माण का चरण निश्चित लक्ष्य के तहत प्रगतिशील कार्य-विस्तार के साथ जोड़ना.
केवल सारांश से ही कई सीमाएँ दिखाई देती हैं। पहला, लाभ का आकार और आधार-रेखाएँ (बेसलाइन) नहीं दी गई हैं। दूसरा, 12 बेंचमार्क की सूची के बिना यह आँकने का कोई तरीका नहीं है कि मूल्यांकन के कार्य प्रशिक्षण के कार्यों के कितने करीब हैं; यदि वे एक जैसे कामों से आते हैं, तो सुधार का एक हिस्सा उसी समानता को दर्शा सकता है। तीसरा, इस बात का कोई माप नहीं है कि स्वतंत्र निष्पादन छूटे हुए कार्य को कितनी विश्वसनीयता से खोज पाता है, या कितना छोड़ देता है।
चौथा, ये केस स्टडी एक क्षमता को दर्शाती हैं; ये इस बात का मूल्यांकन नहीं हैं कि वह कितनी बार सामने आती है। पाँचवाँ, सार यह नहीं बताता कि डेटा या मॉडल जारी किया जाएगा या नहीं, और पेपर एकत्र किए जाने के समय कोई GitHub रिपॉजिटरी पंजीकृत नहीं थी। पुनरुत्पादन की अभी जाँच नहीं की जा सकती।
6. Why this topic is clustering: attention is moving to how training environments are built
इस लेख के पीछे की चयन प्रणाली क्लस्टरों को महत्व देती है: यानी कम समय के भीतर एक ही सवाल पूछने वाले स्वतंत्र शोधपत्र। इस क्लस्टर का आकार 2 है। दूसरा शोधपत्र ProgramGym है।[3]
साझा कीवर्ड में long-horizon, environments, scaling और training शामिल हैं। ProgramGym ऐसे एजेंटों को लक्ष्य बनाता है जो किसी संदर्भ प्रोग्राम का अध्ययन करके उसे शुरू से दोबारा बनाते हैं, और वह रिपॉज़िटरी से बड़े पैमाने पर सत्यापन-योग्य प्रशिक्षण परिवेश तैयार करता है। क्षेत्र अलग हैं, टर्मिनल कार्य बनाम प्रोग्राम पुनरुत्पादन, लेकिन दोनों एक ही सवाल का जवाब देते हैं: लंबी अवधि के व्यवहार के लिए ऐसे प्रशिक्षण परिवेश चाहिए जो अभी पर्याप्त संख्या या गुणवत्ता में मौजूद नहीं हैं। एक पठन यह है कि प्रयास मॉडल को बदलने से हटकर इस ओर जा रहा है कि मॉडल को कहाँ प्रशिक्षित किया जाए।
Hugging Face Daily Papers पर इस पेपर को 132 अपवोट मिले।[2] वह संख्या बताती है कि पेपर ने शोधकर्ताओं का ध्यान खींचा। यह नहीं बताती कि दावे सही हैं या किसी ने उन्हें पुनरुत्पादित किया है। दो का क्लस्टर भी छोटा है, और यह एक टिकाऊ विषय बनता है या नहीं, यह आगे क्या होता है उस पर निर्भर करता है.
7. What connects to pharmaceutical and regulatory practice
दवा संगठन टर्मिनल पर आधारित कई लंबे काम चलाते हैं: क्लिनिकल सारांश प्रोग्राम अपडेट करना, विश्लेषण परिवेश ताज़ा करना, नियामकीय प्रस्तुतियों के लिए डेटासेट तैयार करना। हर काम जाँच, निर्णय, सुधार और डिलीवरी के उसी क्रम से गुज़रता है। अगर कभी ऐसा काम एजेंटों को सौंपा जाए, तो एजेंट को किन कार्यों पर प्रशिक्षित किया गया था, यह सवाल उसके बेंचमार्क स्कोर के साथ ही रखा जाना चाहिए।
इस पेपर में बताया गया विफलता का तरीका उन सभी पर भी लागू होता है जो किसी एजेंट का आंतरिक रूप से मूल्यांकन करते हैं। यदि परीक्षण कार्य तैयार करने वाला व्यक्ति पहले से डेटा भी साफ़ कर देता है, तो एजेंट उस हिस्से को किए बिना ही पास हो सकता है जो वास्तव में मायने रखता है। अपनाने से पहले, कार्य के लेखक के अलावा किसी और को वह कार्य चलाना चाहिए और पुष्टि करनी चाहिए कि जो काम संगठन वास्तव में सौंपना चाहता है, वह अब भी मौजूद है। यह कम्प्यूटरीकृत सिस्टम वैलिडेशन की उस प्रथा से मेल खाता है जिसमें टेस्ट स्क्रिप्ट लिखने वालों को उन्हें चलाने और समीक्षा करने वालों से अलग रखा जाता है।
दूसरा मुद्दा ऐसे एजेंट का है जो लंबे समय तक प्रयोग करता रहता है और अपनी ही विधियों में संशोधन करता है। यह खोजपरक शोध में मददगार हो सकता है। GxP परिवेश में इसके लिए ऐसा रिकॉर्ड चाहिए जिससे समीक्षक यह दोबारा समझ सके कि कब, क्या और क्यों बदला गया। सार के अनुसार मॉडल प्रभावी सुधारों को अपने अंतिम परिणामों में बनाए रखता है, लेकिन प्रक्रिया कैसे दर्ज की जाती है, इस बारे में वह कुछ नहीं कहता। ऐसे एजेंटों पर विचार करने वाले संगठनों को एजेंट शुरू होने से पहले ही प्रक्रिया-रिकॉर्ड का रूप तय करना होगा, केवल अंतिम परिणाम का रूप नहीं।