1. ما المشكلة التي تعالجها هذه الورقة البحثية؟
معظم الدراسات حول النماذج اللغوية الكبيرة (LLMs) في الطب تناولت الدقة: هل يستطيع النموذج تسمية التشخيص، والنجاح في الامتحان، والتغلب على الطبيب؟ لكن حين يُنفَّذ اقتراح يقدمه الذكاء الاصطناعي في عيادة، فإن أول ما يتحرك هو طلبات الفحوصات والإحالات والوصفات الطبية. وكل واحد من ذلك يحمل تكلفة.
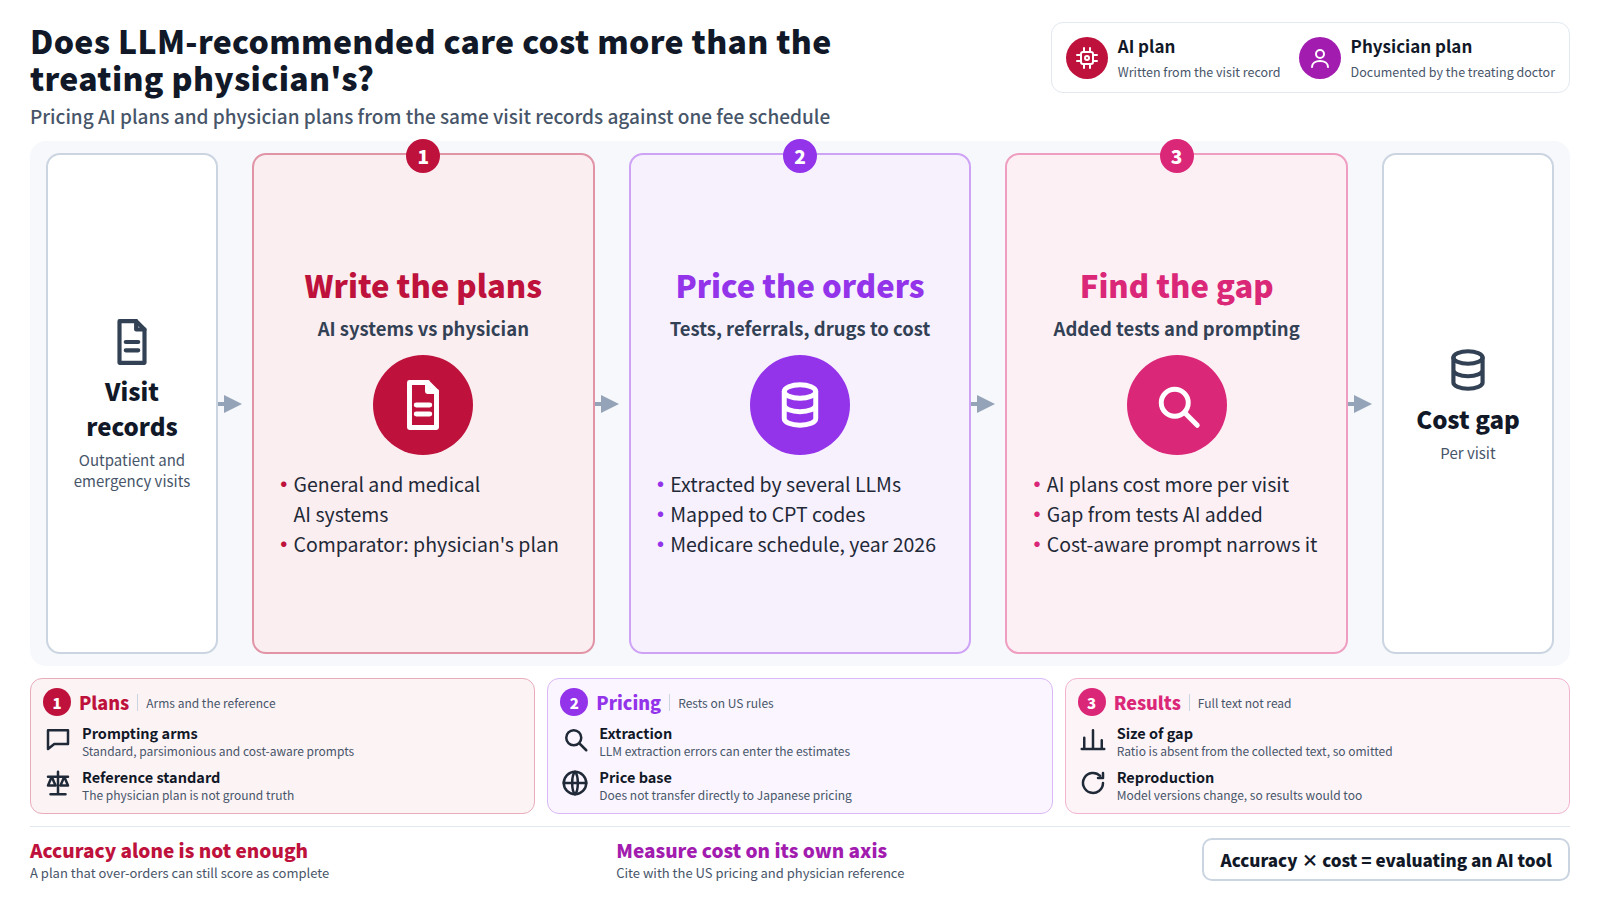
ينقل هذا المقال الأصلي، المنشور في NEJM AI بعد مراجعة الأقران، السؤال من الدقة إلى التكلفة. فبالنظر إلى سجل الزيارة نفسه، هل تبلغ خطة الرعاية المكتوبة بواسطة LLM تكلفة مختلفة عن خطة الطبيب الذي فحص المريض فعليًا؟ وإن كان الأمر كذلك، فما الذي يدير هذا الاختلاف، وهل تؤثر طريقة توجيه المطالب إلى النموذج فيه[1]?
قد يرفع نظام ذكاء اصطناعي حاصل على درجة دقة عالية الإنفاق وعبء المرضى رغم ذلك إذا كان يميل إلى تكديس الفحوصات "احتياطاً". وخفض التكاليف بقسوة مفرطة يعني تفويت أمور. يتعين قياس الدقة والتكلفة على محورين منفصلين; وهذه هي نقطة الانطلاق في الورقة البحثية.
2. ماذا يقترح؟
جوهر المنهجية هو تسعير خطة الذكاء الاصطناعي وخطة الطبيب وفقًا لجدول الرسوم نفسه. ووفقًا للوصف العلني للمؤلفين لبياناتهم وكود التحليل الخاص بهم، فقد جُمعت معلومات العرض من سجلات زيارات العيادات الخارجية والطوارئ، وطُلب من مجموعة من أنظمة الذكاء الاصطناعي، تشمل نماذج LLM للأغراض العامة وأنظمة طبية متخصصة، كتابة تقييم وخطة. والمقارَن هو الخطة الموثقة للطبيب المعالج[3][4].
تم استخراج الفحوصات والإحالات والأدوية في كل خطة بواسطة عدة نماذج لغوية كبيرة (LLMs) مستقلة وربطها برموز الإجراءات الأمريكية (CPT). ثم سُعِّرت الطلبات باستخدام جدول رسوم أطباء Medicare للعام التقويمي 2026، والأدوية عبر مسح وطني أمريكي لأسعار الأدوية. وبالإضافة إلى موجّه قياسي، نُفِّذت ذراعان للتوجيه: إحداهما تطلب خطة مقتصدة والأخرى تطلب من النموذج مراعاة التكلفة[4].
إذن، الدراسة لا تمنح الذكاء الاصطناعي قدرة جديدة. إنها تعيد قياس مخرجات الذكاء الاصطناعي القائمة بمسطرة اقتصاديات الصحة.
3. ما الذي أظهرته، ضمن ما كان يمكن التحقق منه؟
تنبيه أولًا. في السجل البيبليوغرافي المجمّع لهذا الموقع، لم يكن حقل الملخص يحتوي إلا على سطر "NEJM AI, Ahead of Print." وفي وقت كتابة هذه السطور تعذّر الوصول إلى صفحة مقالة NEJM AI، ولم يُقرأ النص الكامل. وما يلي يستند إلى الملخص الذي نشرته مجموعة المؤلفين على صفحة منشوراتها الخاصة[2].
وفقاً لذلك الملخص، كانت الرعاية التي أوصت بها أنظمة الذكاء الاصطناعي أعلى كلفة لكل زيارة من الرعاية التي أوصى بها الأطباء المعالجون. جاء معظم هذا الفارق من فحوصات أضافها الذكاء الاصطناعي في زيارات لم يطلب فيها الطبيب أي فحوصات. وكتب المؤلفون أن المطالبات المراعية للتكلفة ضيّقت الفارق لكنها لم تغلقه أبداً.
يقدم الملخص أيضاً نسبة لحجم الفجوة. وهذه المقالة لا تنشر أرقاماً غائبة عن النص الأساسي الذي جمعته، لذا تُترك النسبة جانباً هنا. والقراء الراغبون في معرفة الحجم ينبغي أن يرجعوا مباشرة إلى ورقة NEJM AI وملخص المؤلفين.
يسرد المستودع العام أيضًا تحليلات تقييمات ملاءمة الأطباء، والتوافق التشخيصي بين الذكاء الاصطناعي والطبيب، وثبات إعادة الاختبار[4]. تعذّر التأكد، ضمن نطاق هذا المقال، من كيفية الإبلاغ عن تلك النتائج في الورقة البحثية.
4. مثال تطبيقي
لنتأمل فريق الشؤون الطبية في إحدى شركات الأدوية وهو يقيّم أداة دعم قائمة على الذكاء الاصطناعي لمتخصصي الرعاية الصحية.
اجتماع مراجعة داخلي
المطوّر: "في حالات التقييم، كان الاتفاق التشخيصي مع الأطباء المعالجين بنفس المستوى تقريباً. الخطط لا تغفل شيئاً."
مسؤول اقتصاديات الرعاية الصحية: "هل أحصيت الفحوصات في تلك الخطط؟ في الزيارات التي اختار فيها الطبيب الانتظار اليقظ، هل يضيف الذكاء الاصطناعي تحاليل دم وتصويراً طبياً؟
المطوّر: "يبدو بالفعل أن هناك الكثير من الفحوصات الاحترازية. لكن ذلك يصب في مصلحة الأمان."
مسؤول اقتصاديات الرعاية الصحية: "يعتمد كون الأمر آمناً على ما إذا كانت تلك الفحوصات قد غيّرت التدبير العلاجي. فهي تضيف تكلفة وعبئاً على المريض، وما لم نقس ذلك بمعزل عن الدقة، فلن نكون قد قيّمنا الأداة."
تُدخل الورقة البحثية رأي المتحدث الثاني. ففي مقارنة الدقة، يمكن لخطة تفرط في إجراء الطلبات أن تنال درجة جيدة بوصفها «مكتملة». أما عند ترتيب الخطط حسب التكلفة فيصبح التحيّز ظاهرًا للعيان.
5. ما الذي ليس جديدًا، وأين تكمن الحدود؟
الدراسات التي تقارن نماذج LLM بالأطباء وفيرة: دقة التشخيص، وأسئلة الامتحانات، وقراءة الصور. إطار المقارنة نفسه ليس جديدًا. الجديد هنا هو المقياس المعتمد. أما اللبنات الأساسية، وهي استخلاص البيانات من السجلات ومطابقة الأكواد والتسعير وفق جدول الرسوم، فهي معيار قائم في أبحاث اقتصاديات الصحة. ويمكن قراءة عدة حدود من المادة المتاحة.
- خطة الطبيب ليست الحقيقة المرجعية. المرجع هو ما فعله الطبيب المعالج، والطبيب الذي لم يطلب أي فحص لم يكن بالضرورة على حق. فبعض الفحوصات التي أضافها الذكاء الاصطناعي ربما غطّت شيئاً أغفله الطبيب. واختلافات التكلفة وحدها لا تحدد أي خطة كانت أفضل للمريض.
- يعتمد التسعير على النظام الأمريكي. بما أن جدول رسوم Medicare وبيانات أسعار الأدوية الأمريكية هي المستخدمة، فإن النتائج لا تسري مباشرة على التعويض الطبي أو أسعار الأدوية في اليابان. وقد يكون اتجاه الفارق مفيداً بوصفه معلومة؛ أما حجمه فيتوقف على النظام.
- سجل الزيارة نص. قرأ الذكاء الاصطناعي ملاحظة طبية وكتب خطة؛ أما الطبيب فالتقى بالمريض ووازن بين التفضيلات والتأمين. يصعب القول إن الطرفين امتلكا المعلومات نفسها. يتضمن المستودع لقطة من مجموعة بيانات عامة للتفريغ الطبي، لكن المصدر الدقيق للحالات تعذّر تأكيده هنا.
- إعادة الإنتاج محدودة. يحذّر المستودع نفسه من أن إصدارات النماذج وتوافر API يتغيّران، لذا فإن إعادة تشغيل الاستعلامات لن تعطي النتائج نفسها. والمخرجات المحفوظة تعكس سلوك النماذج كما لوحظ في ربيع 2026[4].
- يُجرى الاستخراج أيضًا بواسطة نماذج LLM. يعتمد استخراج الفحوصات والأدوية من الخطط على نماذج LLM، لذا قد تنعكس أخطاء الاستخراج في تقديرات التكلفة. ويُقصد باستخدام عدة نماذج احتواء ذلك، لكن مستوى الخطأ تعذّر تأكيده هنا.
6. كيف تمّت تغطية الورقة البحثية؟
اختارت خطوة الانتقاء في هذا الموقع الورقة بوصفها واحدة من الأوراق التي اجتازت تحكيم الأقران ونالت تغطية من عدة جهات إعلامية مستقلة. وكانت الجهات المدرجة هي Nature وScience وFrontiers وNeurology Today وmedRxiv، بمجموع خمس جهات. غير أنه عند وضع العناوين في صف واحد، لا يتعلق أي منها بهذه الورقة.
- Nature: "النماذج اللغوية الكبيرة متعددة الوسائط تتحدى تحدي الصور في NEJM" (الدقة في أسئلة الصور)
- العلوم: "أداء نموذج لغوي كبير في مهام الاستدلال الخاصة بالطبيب" (مهام استدلال الطبيب)
- Neurology Today: "نموذج لغوي كبير يتفوق على الأطباء في دقة الترميز التشخيصي" (دقة الترميز)
- medRxiv: "Multimodal Large Language Model Passes Specialty Board Examination…" (درجات الاختبار التخصصي)
- Frontiers: "تقييم مُعمّى من مرحلتين للنماذج اللغوية الكبيرة في جراحة القلب المعقدة…" (أداء المهام في جراحة القلب)
كل واحدة من الدراسات الخمس دراسة منفصلة تصادف أن عناوينها تجمع بين LLMs والأطباء. خطوة الاختيار طابقتها استنادًا إلى كلمات مشتركة؛ وهي ليست دليلًا على أن هذه الورقة صدرت عنها تقارير. بالنسبة لهذه الورقة، سبب الاختيار المعلن المتمثل في التغطية المستقلة لا ينطبق.
لا يزال عدم التطابق ناقلًا لمعلومة مفيدة. فكل عنوان تم رصده يقوم على السؤال «هل الذكاء الاصطناعي أكثر دقة من الأطباء؟». هذه الورقة البحثية تقع خارج ذلك السؤال: فالتساوي في الدقة لا يعني التساوي في التكلفة. ووصول معيار التكلفة إلى مجلة علمية محكمة، بينما ينصبّ اهتمام الصحافة على الدقة، أمرٌ يستحق التوثيق. فلا النشر في مجلة محكمة ولا الاختيار من قبل هذا الموقع يضمنان أن النتائج صحيحة أو ذات قيمة سريرية أو جديدة.
7. أين يرتبط هذا بقطاع الأدوية والعمل التنظيمي؟
أولًا، معايير تقييم أدوات الدعم المعتمدة على الذكاء الاصطناعي. إذا عرض نظام ما خيارات رعاية على المهنيين الصحيين، فينبغي أن يغطي التقييم ليس الدقة فحسب، بل أيضًا مقدار ما تزيد به الاقتراحات من اختبارات وإحالات ووصفات طبية. يوفر تصميم الدراسة نموذجًا واحدًا للقيام بذلك.
ثانياً، المطالبات تحرّك النتيجة. وفي ملخص المؤلفين، قلّصت التعليمات المراعية للتكلفة الفجوة. لذلك فإن مطالبة النظام جزء من مواصفات المنتج وتندرج ضمن ضبط التغيير وحفظ السجلات. إذا كانت تعليمة واحدة قادرة على تغيير نمط التوصيات، فلا يمكن إعادة إنتاج التقييم ما لم تُسجَّل المطالبة المستخدمة.
ثالثاً، التقييم الاقتصادي الصحي. فمع مشاركة الذكاء الاصطناعي في المزيد من التوصيات، قد تتغير الطريقة التي تُستخدم بها الأدوية والاختبارات بحد ذاتها. وقد تحتاج أعمال تقييم فعالية التكلفة ودراسات الاستخدام بعد التسويق إلى وسيلة لرصد مدى تورط توصيات الذكاء الاصطناعي.
لا يعني أيٌّ من هذا إمكانية تطبيق النتائج على النظام الياباني كما هو الآن. وعند الاستشهاد بالدراسة، من المفيد الإشارة إلى أن التسعير يستند إلى القواعد الأمريكية وأن المعيار المرجعي هو تقدير الطبيب المعالج.