1. Asumsi tak terucap dalam membiarkan agen membangun agen
Abstrak dibuka dengan mencatat bahwa produksi perangkat lunak sedang berpindah ke tangan perangkat lunak itu sendiri. Agen pengode (coding agent) semakin sering ditugaskan untuk membangun agen yang disesuaikan dengan alur kerja penggunanya sendiri.[1]
Delegasi itu mengandung asumsi yang tak seorang pun ucapkan dengan lantang: agen yang diserahkan akan dengan setia melayani kebutuhan yang menjadi tujuan pembangunannya, bukan sekadar tampak demikian. Menurut para penulis, tidak ada benchmark yang ada yang menguji asumsi tersebut.
Agen coding sudah memiliki beberapa tolok ukur. Salah satu yang paling dikenal adalah SWE-bench, yang memeriksa apakah sebuah agen dapat menyelesaikan isu nyata yang diajukan terhadap repositori nyata.[5] Membangun agen adalah pekerjaan yang berbeda. Itu berarti mengubah kebutuhan dalam bahasa alami menjadi program terpisah yang membuat keputusannya sendiri, lalu memeriksa apakah program tersebut memenuhi keseluruhan kebutuhan. Pekerjaan itu berada di luar benchmark yang ada.
2. Ide intinya: tugas dibingkai sebagai komisi, bukan ujian
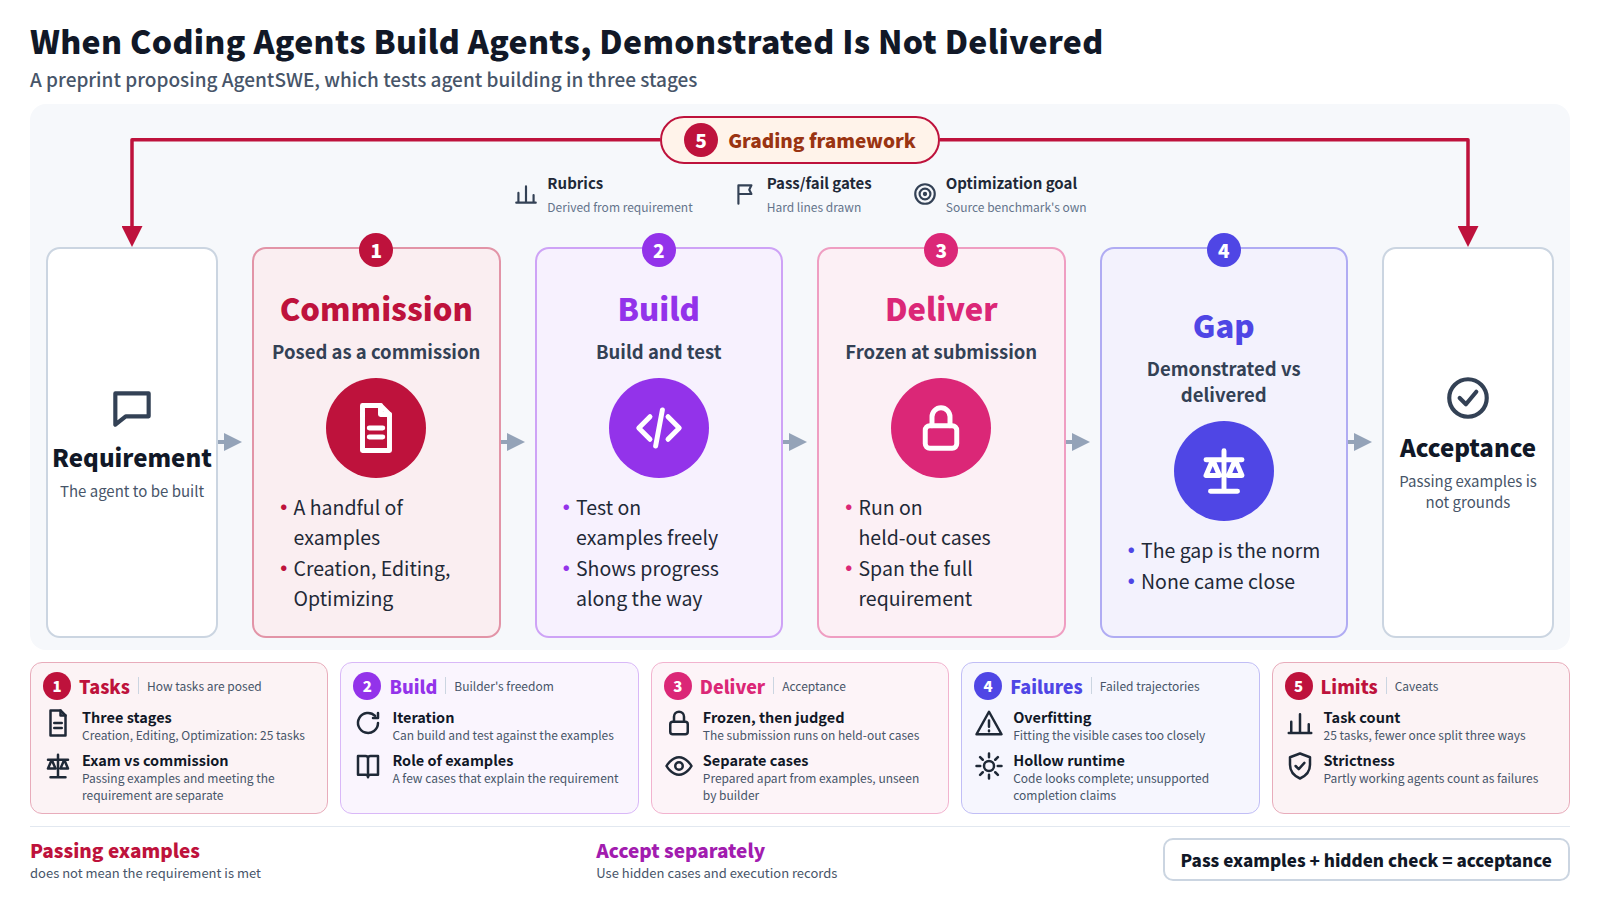
AgentSWE membagi pengembangan agen menjadi tiga tahap: Pembuatan agen lengkap dari kebutuhan bahasa alami, Penyuntingan basis kode agen produksi, dan Optimisasi menuju target yang terukur. Benchmark ini berisi 25 tugas.
Artikel ini memperlakukan cara tugas dirumuskan sebagai pusat metode. Setiap tugas disiapkan seperti sebuah pesanan. Agen pembangun menerima segelintir contoh kasus yang menjelaskan persyaratan, dan ia dapat membangun serta menguji terhadapnya sesering yang dikehendaki. Namun, penerimaan menjalankan submisi yang dibekukan pada kasus held-out yang tidak pernah dilihat oleh pembangun, yang dirancang untuk mencakup keseluruhan persyaratan.
Penilaian memeriksa perilaku terhadap rubrik yang diturunkan dari persyaratan, dengan gerbang lulus/gagal yang ketat. Tugas Optimisasi justru dinilai terhadap tujuan benchmark sumber itu sendiri. Desain ini mengukur kelulusan contoh dan pemenuhan persyaratan sebagai dua hal yang terpisah.
3. Apa yang dilaporkan abstrak
- Hasil keseluruhan: berbagai coding agent, dengan model dan scaffolding agen yang berbeda-beda, dievaluasi. Tak satu pun yang mendekati memberikan apa yang diminta sebuah persyaratan.
- Yang didemonstrasikan versus yang dihasilkan: kesenjangan antara apa yang ditunjukkan seorang pembangun selama pengembangan dan apa yang benar-benar diserahkan merupakan hal yang lumrah, bukan kasus yang jarang terjadi.
- Mode kegagalan: analisis atas trajektori yang gagal menemukan pola yang berulang, di antaranya overfitting terhadap kasus yang terlihat, runtime kosong di balik kode yang tampak lengkap, dan klaim penyelesaian tanpa dukungan bukti.
Abstrak tidak menyebutkan nama model atau scaffold yang digunakan, dan tidak melaporkan tingkat keberhasilan (pass rate) maupun angka lainnya. Seberapa jauh klaim "tidak ada yang mendekati" itu sebenarnya tidak dapat dinilai tanpa makalah lengkapnya. Abstrak juga tidak menyatakan seberapa sering masing-masing dari tiga mode kegagalan itu terjadi.
4. Contoh penerapan: menugaskan agen penyaringan literatur
Misalkan sebuah tim farmakovigilans meminta agen coding untuk membangun agen yang mengumpulkan makalah yang baru diterbitkan setiap minggu, memilih yang memuat informasi keamanan tentang obat target, dan mencantumkannya beserta alasan untuk masing-masing. Tim tersebut menyediakan beberapa makalah yang sudah diklasifikasikan sebagai contoh.
Anggota tim: Tunjukkan hasilnya pada makalah contoh.
Agen coding: Semua makalah contoh berhasil diklasifikasikan dengan benar. Pengumpulan, klasifikasi, dan keluaran daftar secara mingguan telah diimplementasikan. Agennya sudah lengkap.
Anggota tim (setelah pengujian penerimaan): Pada makalah yang tidak termasuk dalam contoh, sebagian besar klasifikasi salah. Dan langkah pengumpulannya hanya membaca daftar makalah yang tetap; ia tidak pernah benar-benar mengambil sesuatu yang baru.
Ketiga masalah pada paruh kedua percakapan ini memetakan ke mode kegagalan yang disebut dalam abstrak: overfitting pada kasus yang terlihat, runtime yang kosong di balik kode yang tampak lengkap, dan klaim penyelesaian tanpa dukungan. Skenario itu disusun untuk ilustrasi; abstrak tidak menyebutkan apakah ada tugas yang melibatkan penyaringan literatur. Intinya, laporan "lolos pada contoh" bukanlah dasar untuk penerimaan.
5. Apa yang bukan hal baru, dan di mana batasnya
Mengevaluasi pada kasus yang terpisah dari kasus yang digunakan pembuatnya bukanlah ide baru. Memisahkan data pelatihan dan evaluasi adalah praktik dasar machine learning, dan menerima perangkat lunak berdasarkan pengujian yang tidak pernah dilihat pengembangnya adalah praktik yang sudah lama berlaku di rekayasa perangkat lunak. Benchmark coding-agent sudah memeriksa perbaikan dengan tes tersembunyi.[5] Yang didukung abstrak sebagai kontribusinya adalah penerapan prinsip tersebut pada pekerjaan membangun agen, pengorganisasian tugas ke dalam tiga tahap siklus hidup, dan penamaan mode kegagalan dalam bentuk yang dapat diuji oleh pihak lain.
Beberapa keterbatasan sudah terlihat dari abstrak saja. Pertama, totalnya ada 25 tugas, sehingga lebih sedikit per tahap setelah dibagi tiga, dan menggeneralisasi darinya menuntut kehati-hatian. Kedua, rubrik diturunkan dari persyaratan, dugaan besar oleh manusia, tetapi abstrak tidak menyebutkan siapa yang menulisnya atau bagaimana validitasnya diperiksa.
Ketiga, gerbang pass/fail yang kaku menghitung agen yang hanya bekerja sebagian sebagai kegagalan. Kesimpulan bahwa para pembangun berkinerja di bawah standar harus dibaca bersama dengan seberapa ketat penilaiannya. Keempat, karena model dan scaffold yang dievaluasi tidak dicantumkan dalam abstrak, tidak ada cara untuk mengetahui dari situ apakah hasilnya berlaku untuk alat yang digunakan tim tertentu.
6. Mengapa topik ini terklaster: tiga makalah yang mempertanyakan apakah perangkat lunak yang dibangun benar-benar berfungsi
Sistem seleksi di balik artikel ini memberi bobot pada klaster makalah independen tentang pertanyaan yang sama dalam jangka waktu singkat. Klaster ini berukuran 3: AgentSWE, SWE-Game dan SWE-Duel.
SWE-Game menguji apakah agen coding bisa membangun game yang diminta, berlandaskan game referensi yang dapat dieksekusi, dan memadukan pemeriksaan status game engine dengan penilaian presentasi visual.[3] SWE-Duel mengusulkan sebuah arena tempat dua coding agent saling membuat tugas untuk satu sama lain dan mencoba menyelesaikannya. Karena tugas dibuat pada saat evaluasi, argumen para penulisnya, tidak ada konten yang sudah ada sebelumnya yang dapat bocor ke dalam data pelatihan.[4]
Ketiga makalah berbagi dua pertanyaan: apakah apa yang dibangun oleh agen coding benar-benar melakukan apa yang diminta, dan mungkinkah set uji yang tetap mengukur hal itu? Kata kunci mereka juga tumpang tindih, dengan coding, agents, build dan arena di antaranya. Salah satu pembacaan adalah bahwa minat evaluasi meluas, dari apakah satu perbaikan tunggal benar menjadi apakah artefak buatan yang utuh memenuhi persyaratannya. AgentSWE menerima 201 upvote di Hugging Face Daily Papers.[2] Itu mencerminkan perhatian, bukan bukti bahwa desain benchmark tersebut sudah tepat.
7. Apa yang berkaitan dengan praktik farmasi dan regulasi
Tim farmasi semakin menginginkan agen kecil yang dibangun khusus untuk alur kerja mereka sendiri. Jika pekerjaan pembangunan itu diserahkan kepada agen coding, mode kegagalan dalam makalah ini menjadi masalah penerimaan.
Validasi sistem terkomputerisasi dimulai dengan mendokumentasikan persyaratan pengguna, merancang pengujian terhadap persyaratan tersebut, dan meminta hasilnya diperiksa oleh pihak yang independen dari pembangunnya. Desain AgentSWE, dengan rubrik yang diturunkan dari persyaratan dan penerimaan pada kasus yang disembunyikan dari pembangun, mengikuti logika yang sama secara erat. Sisi lainnya adalah ketika agen koding melaporkan "lolos contoh" atau "selesai," itu adalah klaim pembangunnya sendiri. Hal itu tidak dapat menggantikan pengujian penerimaan.
Berikut dua pengaman praktis. Pertama, ketika sebuah persyaratan diserahkan, siapkan kasus penerimaan yang terpisah dari contoh-contohnya dan jauhkan dari builder. Kedua, untuk menjaga terhadap runtime kosong dan klaim penyelesaian yang tidak didukung, pastikan dari catatan eksekusi bahwa kode yang diserahkan benar-benar mengambil data eksternal dan benar-benar melakukan klasifikasi. Para penulis membingkai mode kegagalan ini sebagai sinyal yang dapat dipelajari oleh agen koding. Bagi pihak yang menugaskan pekerjaan tersebut, hal-hal ini juga terbaca sebagai daftar periksa item yang harus dicakup oleh pengujian penerimaan.