1. ¿Qué problema aborda el artículo?
La mayoría de los estudios sobre modelos de lenguaje de gran escala (LLM) en medicina han preguntado por la precisión. ¿Puede el modelo nombrar el diagnóstico, aprobar el examen, superar al médico? Sin embargo, cuando una sugerencia de la IA se ejecuta en una clínica, lo primero que se mueve son las órdenes de pruebas, las derivaciones y las recetas. Cada una de ellas conlleva un costo.
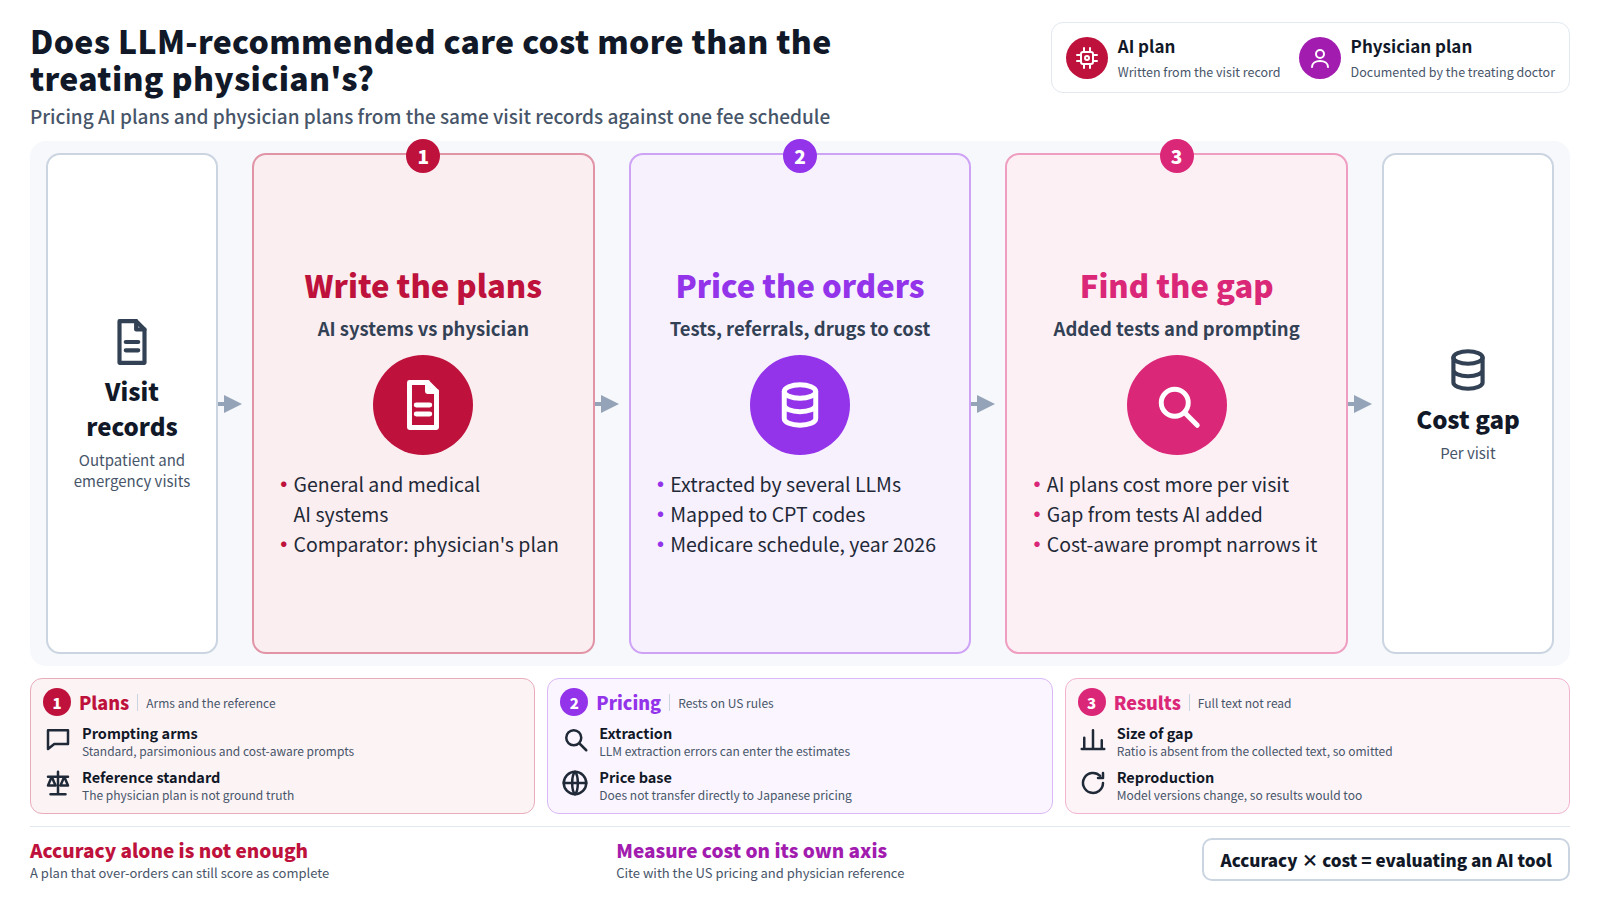
Este artículo original, publicado en NEJM AI tras revisión por pares, traslada la cuestión de la exactitud al coste. Dado el mismo registro de visita, ¿cuesta el plan de cuidados escrito por un LLM una cantidad diferente a la del plan del médico que realmente atendió al paciente? Si es así, ¿qué impulsa la diferencia, y la forma en que se formula el prompt al modelo, la cambia[1]?
Una IA con una puntuación de precisión alta puede seguir aumentando el gasto y la carga del paciente si tiende a acumular pruebas "por si acaso." Recortar los costos demasiado hace que se pasen cosas por alto. La precisión y el costo deben medirse en ejes separados; ese es el punto de partida del artículo.
2. ¿Qué propone?
El núcleo del método es valorar el plan de IA y el plan del médico contra el mismo esquema de tarifas. Según la descripción pública de los autores de sus datos y código de análisis, la información de presentación se tomó de registros de visitas ambulatorias y de urgencias, y se pidió a un conjunto de sistemas de IA, tanto LLM de propósito general como sistemas médicos especializados, que escribieran una evaluación y un plan. El comparador es el plan documentado del médico tratante[3][4].
Las pruebas, las derivaciones y los medicamentos de cada plan fueron extraídos por varios LLM independientes y mapeados a códigos de procedimientos de EE. UU. (CPT). Luego, las órdenes se tasaron con el Medicare Physician Fee Schedule del año calendario 2026, y los medicamentos con una encuesta nacional de precios de medicamentos de EE. UU. Además de un prompt estándar, se ejecutaron dos brazos de prompting: uno que pedía un plan parsimonioso y otro que pedía al modelo que tuviera en cuenta los costos[4].
Así que el estudio no le otorga a la IA una nueva capacidad. Vuelve a medir la salida existente de la IA con la vara de medir de la economía de la salud.
3. ¿Qué mostraba, dentro de lo que se podía verificar?
Una advertencia primero. En el registro bibliográfico recopilado para este sitio, el campo del resumen contenía solo la línea "NEJM AI, Ahead of Print." Al momento de redactar este texto no se pudo acceder a la página del artículo de NEJM AI, y el texto completo no ha sido leído. Lo que sigue se basa en el resumen que el grupo de los autores publicó en su propia página de publicaciones[2].
Según ese resumen, la atención recomendada por los sistemas de IA costó más por visita que la atención recomendada por los médicos tratantes. La mayor parte de la diferencia provino de pruebas que la IA añadió en visitas donde el médico no había ordenado ninguna. La instrucción consciente de los costos redujo la diferencia, pero nunca la cerró, escriben los autores.
El resumen también da una proporción del tamaño de la brecha. Este artículo no publica cifras que estén ausentes del texto primario que recopiló, por lo que la proporción se omite aquí. Los lectores que quieran conocer la magnitud deberán acudir directamente al artículo de NEJM AI y al resumen de los autores.
El repositorio público también enumera análisis de las valoraciones de idoneidad de los médicos, la concordancia diagnóstica entre la IA y el médico, y la fiabilidad test-retest[4]. Cómo se reportan esos resultados en el paper no se pudo confirmar dentro del alcance de este artículo.
4. Un ejemplo resuelto
Considere un equipo de asuntos médicos de un fabricante de medicamentos que evalúa una herramienta de soporte de IA para profesionales sanitarios.
Una reunión interna de revisión
Desarrollador: "En los casos de evaluación, la concordancia diagnóstica con los médicos tratantes fue aproximadamente la misma. Los planes no pasan nada por alto."
Responsable de economía de la salud: "¿Contó las pruebas en esos planes? En las consultas donde el médico optó por la espera vigilante, ¿la IA añade análisis de sangre y estudios de imagen?"
Desarrollador: "Sí parece haber muchas pruebas por si acaso. Pero eso peca de prudente."
Responsable de economía de la salud: "Que sea seguro depende de si esas pruebas cambiaron el manejo. Añaden costos y carga para el paciente, así que, a menos que midamos eso aparte de la precisión, no hemos evaluado la herramienta."
El artículo incorpora la opinión del segundo ponente. En una comparación de precisión, un plan que pide de más puede puntuar bien como "completo". Al alinear los planes por coste, el sesgo se hace visible.
5. ¿Qué no es nuevo y dónde están los límites?
Los estudios que comparan los LLM con los médicos son abundantes: precisión diagnóstica, preguntas de examen, lectura de imágenes. El marco de comparación en sí no es nuevo. Lo nuevo aquí es la vara de medir. Los componentes básicos, la extracción de los registros, el mapeo de códigos y la fijación de precios frente a un tarifario, son estándar en la investigación de economía de la salud. Del material disponible pueden leerse varios límites.
- El plan del médico no es la verdad de referencia. La referencia es lo que hizo el médico tratante, y que un médico no indicara ninguna prueba no era necesariamente correcto. Algunas pruebas añadidas por la IA pueden haber cubierto algo que el médico pasó por alto. Las diferencias de costo por sí solas no dicen qué plan fue mejor para el paciente.
- Los precios dependen del sistema estadounidense. Como se utilizan el sistema de tarifas de Medicare y datos de precios de medicamentos de EE. UU., los resultados no se trasladan directamente al sistema de reembolso ni a los precios de los medicamentos de Japón. La dirección de la brecha puede ser informativa; su magnitud depende del sistema.
- El registro de la visita es texto. La IA leyó una nota y escribió un plan; el médico atendió al paciente y sopesó las preferencias y el seguro. Es difícil afirmar que ambas partes tuvieran la misma información. El repositorio incluye una instantánea de un corpus público de transcripciones médicas, pero aquí no se pudo confirmar exactamente de dónde provenían los casos.
- La reproducción está limitada. El propio repositorio advierte que las versiones de los modelos y la disponibilidad de las API cambian, por lo que volver a ejecutar las consultas no daría los mismos resultados. Las salidas guardadas reflejan el comportamiento de los modelos observado en la primavera de 2026[4].
- La extracción también la realizan los LLM. Extraer las pruebas y los medicamentos de los planes se basa en los LLM, por lo que los errores de extracción pueden afectar las estimaciones de costos. Usar varios modelos busca contener esto, pero el nivel de error no se pudo confirmar aquí.
6. ¿Qué cobertura recibió el artículo?
El paso de selección de este sitio eligió el artículo como uno que superó la revisión por pares y fue cubierto por varios medios independientes. Los medios enumerados fueron Nature, Science, Frontiers, Neurology Today y medRxiv, cinco en total. Pero al alinear los titulares, ninguno trata sobre este artículo.
- Nature: "Los modelos de lenguaje de gran tamaño multimodales desafían el Image Challenge de NEJM" (precisión en las preguntas de imágenes)
- Ciencia: "Rendimiento de un modelo de lenguaje grande en las tareas de razonamiento de un médico" (tareas de razonamiento de un médico)
- Neurology Today: "Un modelo de lenguaje de gran escala supera a los médicos en la precisión de la codificación diagnóstica" (precisión de codificación)
- medRxiv: "Un gran modelo de lenguaje multimodal aprueba el examen de certificación de la especialidad…" (puntuaciones del examen de la especialidad)
- Frontiers: "Evaluación a ciego en dos fases de modelos de lenguaje de gran tamaño en cirugía cardíaca compleja…" (rendimiento de tareas en cirugía cardíaca)
Los cinco son estudios independientes cuyos títulos casualmente emparejan LLM con médicos. El paso de selección los emparejó por palabras compartidas; no son evidencia de que este artículo fuera reportado. Para este artículo, la razón de selección declarada de cobertura independiente no se cumple.
El desajuste sigue siendo informativo. Cada titular capturado se apoya en la pregunta "¿es la IA más precisa que los médicos?" Este artículo queda fuera de esa pregunta: igual precisión no significa igual coste. Que un criterio de medición de costes llegara a una revista revisada por pares mientras la atención de la prensa está fijada en la precisión merece quedar registrado. Ni la publicación en una revista revisada por pares ni la selección por este sitio garantizan que los resultados sean correctos, clínicamente valiosos o novedosos.
7. ¿Dónde se conecta esto con el trabajo farmacéutico y regulatorio?
Primero, los criterios de evaluación de las herramientas de apoyo basadas en IA. Si un sistema presenta opciones de atención a los profesionales sanitarios, la evaluación debe cubrir no solo la precisión, sino cuánto aumentan las sugerencias las pruebas, las derivaciones y las recetas. El diseño del estudio ofrece una plantilla para hacerlo.
En segundo lugar, los prompts mueven el resultado. Según el resumen de los autores, las instrucciones conscientes del costo redujeron la brecha. Por tanto, el prompt del sistema forma parte de la especificación del producto y debe estar bajo control de cambios y conservación de registros. Si una sola instrucción puede alterar el patrón de recomendaciones, una evaluación no puede reproducirse a menos que se registre el prompt utilizado.
Tercero, la evaluación económica en salud. A medida que la IA participa en más recomendaciones, la propia forma en que se usan los fármacos y las pruebas puede cambiar. Los trabajos de coste-efectividad y los estudios de utilización posteriores a la comercialización pueden necesitar una forma de captar en qué medida intervinieron las recomendaciones de la IA.
Nada de esto significa que los resultados puedan aplicarse al sistema japonés tal como está. Al citar el estudio, conviene señalar que la fijación de precios se basa en las reglas de EE. UU. y que el estándar de referencia es el juicio del médico tratante.